一张旧卡,为什么又回到讨论中心
2026年10月,开源项目gpu-unlock引起本地AI社区讨论。项目尝试解除部分Ampere消费级显卡在FP16、BF16和TF32混合精度计算上的指令吞吐限制。其README给出的RTX 3090 Ti测试结果是:BF16矩阵计算由87.50 TFLOPS升至157.41 TFLOPS,TF32由42.58升至82.61 TFLOPS。随后,社区又提交了RTX 3090、双卡3090和七卡3090服务器的测试。一张2020年发布的GeForce RTX 3090,到2026年仍被拿来跑本地模型。这轮讨论有两层:旧卡的计算资源还能挖出多少,以及跑真实AI任务时,这些增加的算力能换来多少时间和成本节省。矩阵基准测试和逐Token输出,答案并不一样。
一、RTX 3090为什么一直没有退出AI玩家的视线
RTX 3090一直留在本地AI配置清单里,24GB显存是重要原因。很多70亿、140亿乃至经过量化的更大模型,可以直接放进单张3090执行;如果使用双卡或多卡,还可以承担更长上下文或者更大的模型。
对于个人开发者、研究团队和中小企业,3090还有一个现实优势:二手市场供应非常丰富。截至2026年,大量企业已经更新到40系、50系或专业加速卡,3090进入二手市场后,形成了一类“便宜的大显存GPU”。本地AI项目里常见这样的配置:一台高核心数CPU,64GB甚至128GB内存,一到四张RTX 3090,运行Linux,使用vLLM、llama.cpp、SGLang等推理软件。这类配置主要面向企业内部代码模型、知识库、文档分析和Agent工作流,追求的是较低的部署成本。
二、gpu-unlock到底做了什么
gpu-unlock是一个Linux内核模块。根据项目README,它在NVIDIA原版驱动绑定显卡之前运行,通过修改GA102、GA104部分芯片的speed selector配置,提高FP16、BF16 FMA到FP32累加等指令的发射速率,然后执行Function Level Reset,再让未修改的NVIDIA驱动正常接管设备。原版NVIDIA驱动仍负责后续接管设备,项目的修改发生在更早的硬件配置环节。项目开发者给出的解释是,这些芯片本身具有相应计算能力,但消费级产品和部分专业产品在指令吞吐上存在差异化配置。
在RTX 3090 Ti、450W条件下,项目公开的8192³ dense GEMM测试结果为:
| 精度 | 修改前 | 修改后 |
|---|---|---|
| FP16 | 87.46 TFLOPS | 118.39 TFLOPS |
| BF16 | 87.50 TFLOPS | 157.41 TFLOPS |
| TF32 | 42.58 TFLOPS | 82.61 TFLOPS |
三、矩阵算力提升与LLM输出速度的差距
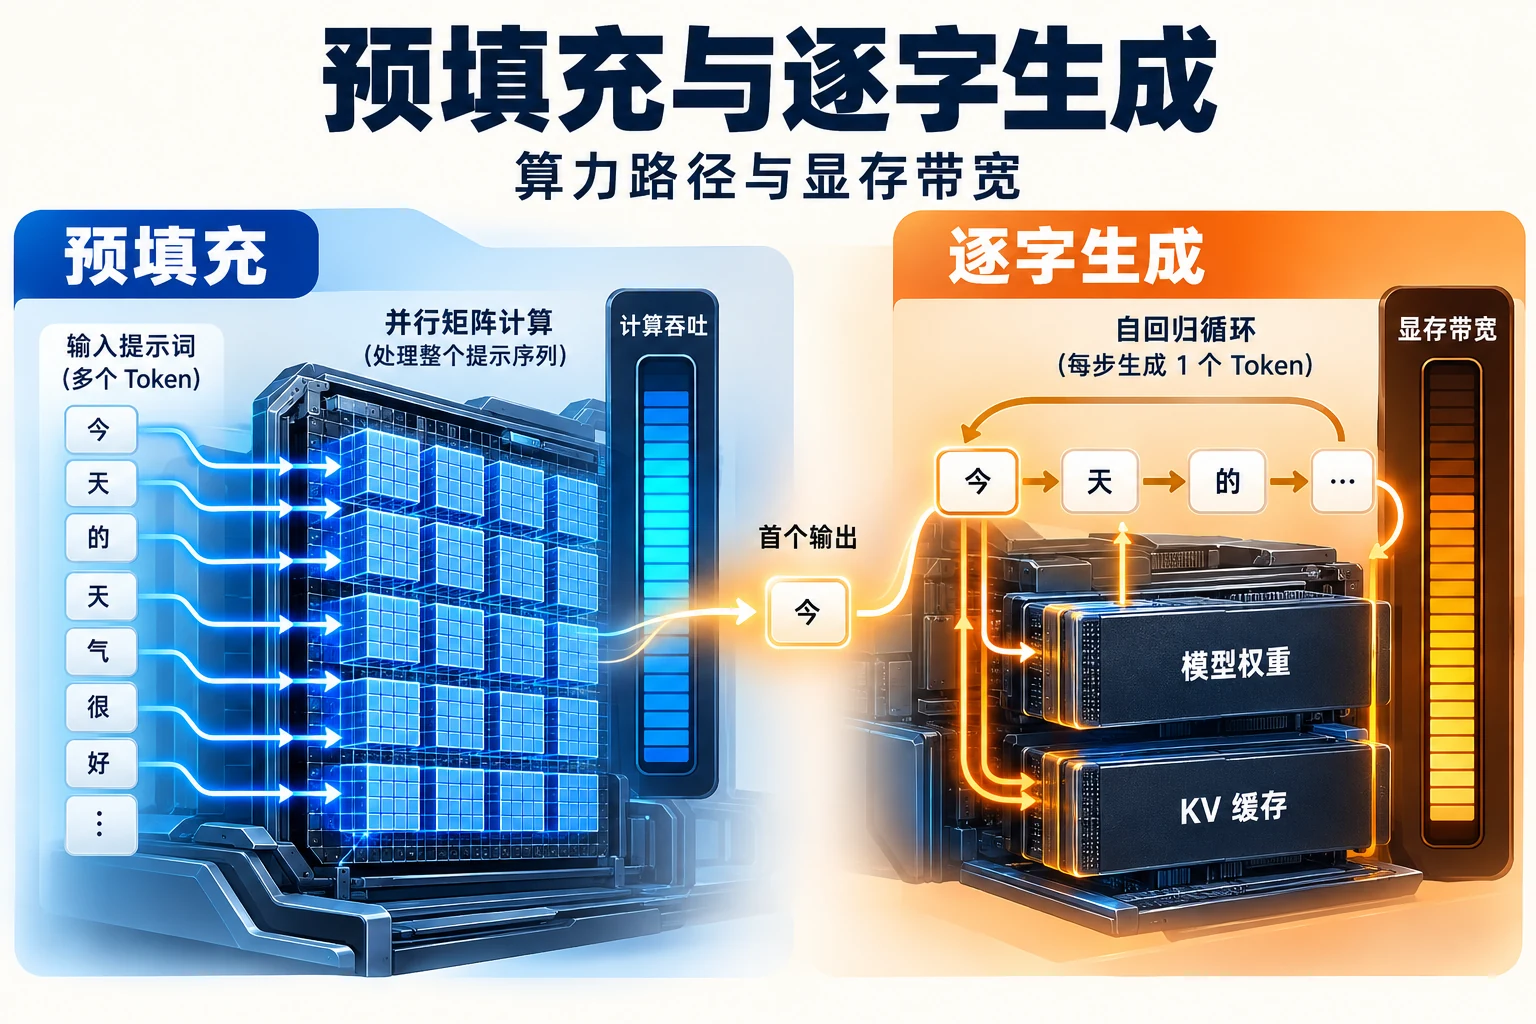
GEMM数字接近翻倍,推理任务中的每一步却未必由矩阵运算主导。大模型推理至少可以粗略分成两个阶段:prefill和decode。Prefill阶段会处理用户输入的整段上下文,例如一次输入2万Token的技术文档。这个阶段大量执行矩阵运算,对GPU计算能力更敏感。Decode阶段则是一Token一Token生成结果。此时模型需要反复从显存读取权重,瓶颈往往逐渐转到显存带宽。10月25日社区提交的一组RTX 3090物理测试就非常典型。在vLLM W4A16场景下,解锁后prefill提高约25%至50%,单位Token能耗下降20%至35%;逐Token decode则没有出现同等级提升。任务结构不同,gpu-unlock带来的收益也不同。
长文档输入、Embedding批处理、大批量Prefill、图像生成,以及部分训练和微调,收益可能比较明显。如果主要是单用户聊天、模型一次只生成一个Token,显存带宽依旧可能是主要瓶颈。评价一张显卡的推理表现,还得看具体任务落在哪个阶段。
四、七卡3090测试:功耗墙开始显现
gpu-unlock社区还出现了一组七卡RTX 3090服务器测试。测试机器采用AMD EPYC平台,七张不同品牌3090在350W至370W功耗范围运行。解锁前后BF16、FP16和TF32 GEMM提升普遍在56%至64%之间。几张卡的结果相当接近,至少在这组社区测试中,提升不依赖单张特定样品。
但测试也揭示了另一个现象:算力提升以后,显卡更快触碰功耗墙,核心时钟会有所下降。也就是说,理论上接近2倍的指令发射能力,最后转化成60%左右实测计算提升。解开一处吞吐限制后,功耗、时钟、显存和散热会继续约束整机表现。本地AI服务器需要按整套系统测量。
五、本地AI正在改变旧GPU的价值曲线
gpu-unlock受到讨论,也与企业部署任务的变化有关。训练超大模型之外,运行垂直模型的需求也在增加。大型模型训练需要H100、B200等高端计算卡,但企业实际部署的工作负载可能完全不同:一套企业知识助手、一个私有代码模型、一个视觉质检推理服务,或者几十个并发不高的内部Agent。
在这些场景中,成本最低的方案并不一定是最先进GPU。例如,假设一张二手3090可以承担某个14B模型,而企业实际并发只有5个人,那么直接采购新一代服务器卡可能没有经济必要。老GPU的价值因此开始重新计算。过去GPU折旧主要由游戏性能决定,现在AI让显存容量、矩阵精度和软件支持成为新的价值因素。24GB显存的3090,就像服务器领域的某些经典CPU一样,可能拥有比传统产品周期更长的“第二生命”。
六、生产服务器的变更成本
这里需要把实验社区和生产系统区分开。gpu-unlock涉及Linux内核启动流程和底层GPU配置。进入生产环境前,至少要检查这些环节:驱动升级后的兼容性、Secure Boot和内核签名、硬件稳定性、系统重启行为,以及潜在保修和维护问题。
个人实验室可以接受一定程度的不确定性,企业生产服务器则需要更严格的变更管理。如果一台服务器承担研发工作,出问题重新启动即可;如果它支撑100名工程师使用的代码Agent,稳定性和维护性优先级就完全不同。这个实验提示了旧硬件的优化空间,生产使用仍须单独评估风险。进入生产前,应先做连续压力测试、驱动升级回归测试和故障恢复验证。
七、把成本算到每个有效任务
TFLOPS可以衡量矩阵计算,却不能直接给出业务成本。企业还要计算一个有效任务需要多少成本。假设一个模型完成一次代码审查需要:2万Token输入、4000Token输出、12次工具调用、3分钟GPU时间,并经历一次失败重试。那么硬件价值应该通过这些真实任务来计算。有可能一张3090理论算力低很多,但模型更适配、利用率更高,单位任务成本反而比专业GPU低。反过来,如果业务需要高并发和长上下文,数据中心卡的显存带宽、互联能力和企业级可靠性就会体现优势。因此,同样要记录硬件利用率和每次有效任务的成本。
买新卡之前,先把任务账算清
模型量化、推理框架和旧GPU优化,让本地部署多了一些选择。gpu-unlock的矩阵测试值得研究,企业却不能把基准分数直接当作业务提速,更不能略过内核修改带来的兼容与维护成本。对一项具体工作,记录输入输出Token、工具调用、GPU时间和失败重试,再比较不同硬件的单位有效任务成本。轻并发场景可能适合大显存旧卡;高并发、长上下文业务则可能需要数据中心卡的带宽、互联和可靠性。先把自己的工作负载量出来,比先选型号更有用。
参考资料
-
gpu-unlock GitHub README
https://github.com/Zagitta/gpu-unlock/blob/main/README.md -
RTX 3090 compatibility report
https://github.com/Zagitta/gpu-unlock/issues/85 -
RTX 3090 vLLM W4A16 prefill test
https://github.com/Zagitta/gpu-unlock/issues/107 -
Seven RTX 3090 server test
https://github.com/Zagitta/gpu-unlock/issues/52