会回答之后,先看它能否把任务做完
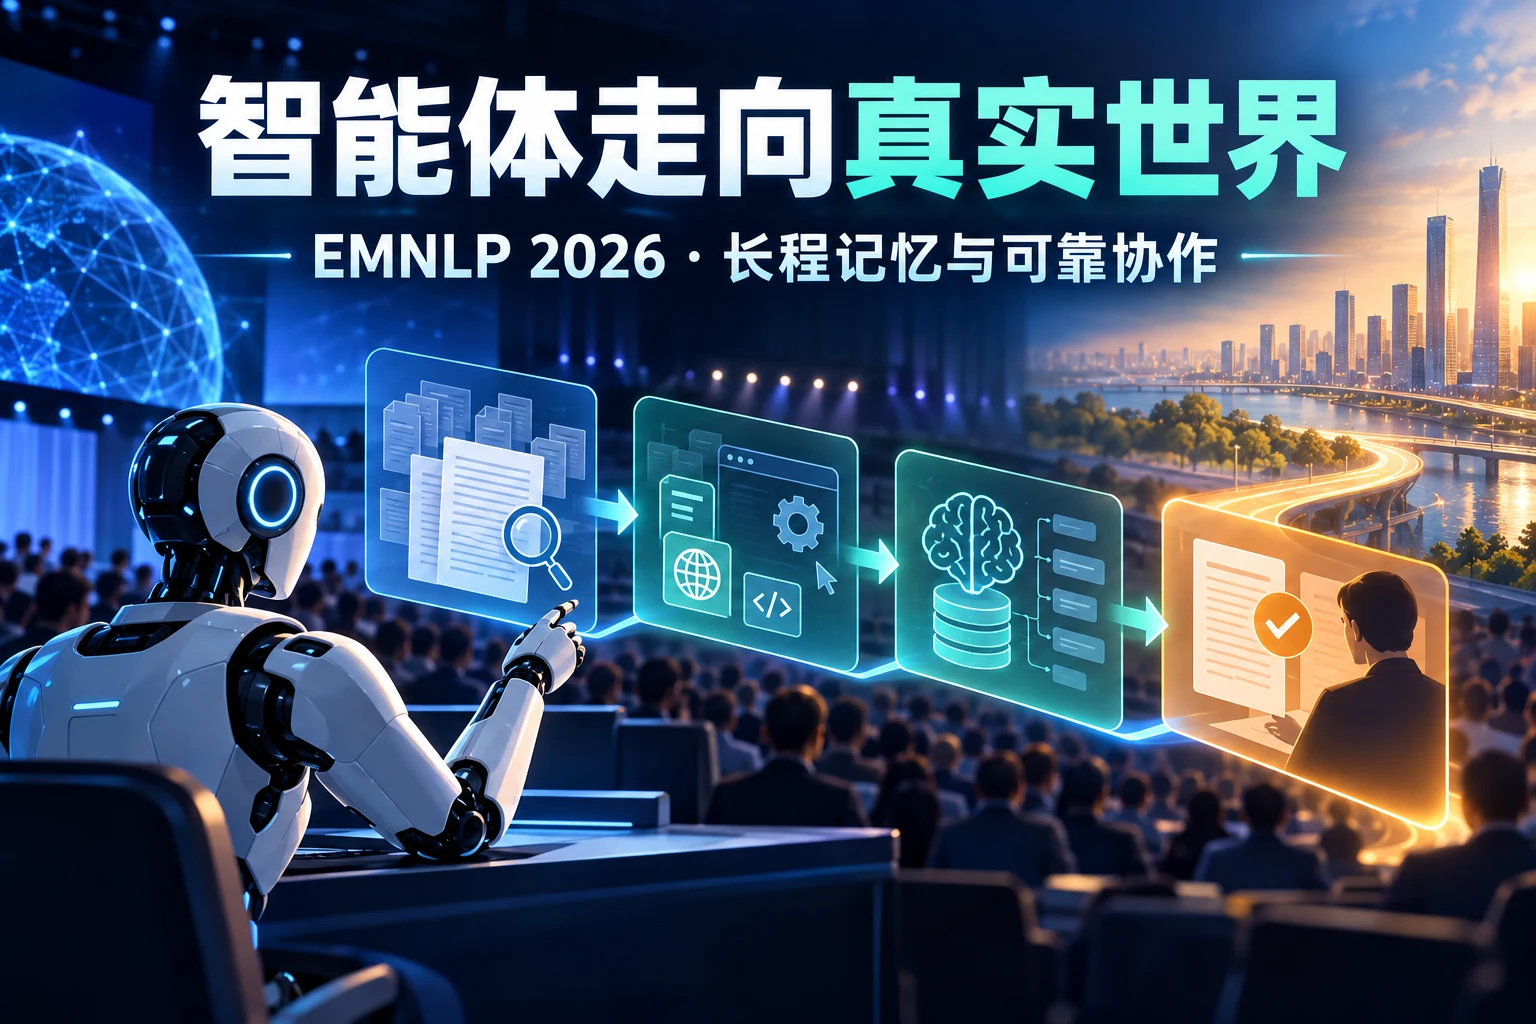
2026年10月25日,EMNLP 2026在匈牙利布达佩斯进入主会首日。香港科技大学Pascale Fung的主旨报告谈世界模型、连续多模态数据、规划、记忆与行动;北卡罗来纳大学教堂山分校Mohit Bansal的产业报告则提出可信协作、世界知识发现和长程记忆三类挑战。会议还安排了AI参与论文评审实验的初步报告。几项议程连在一起,讨论对象已经不止于模型答对一道题。
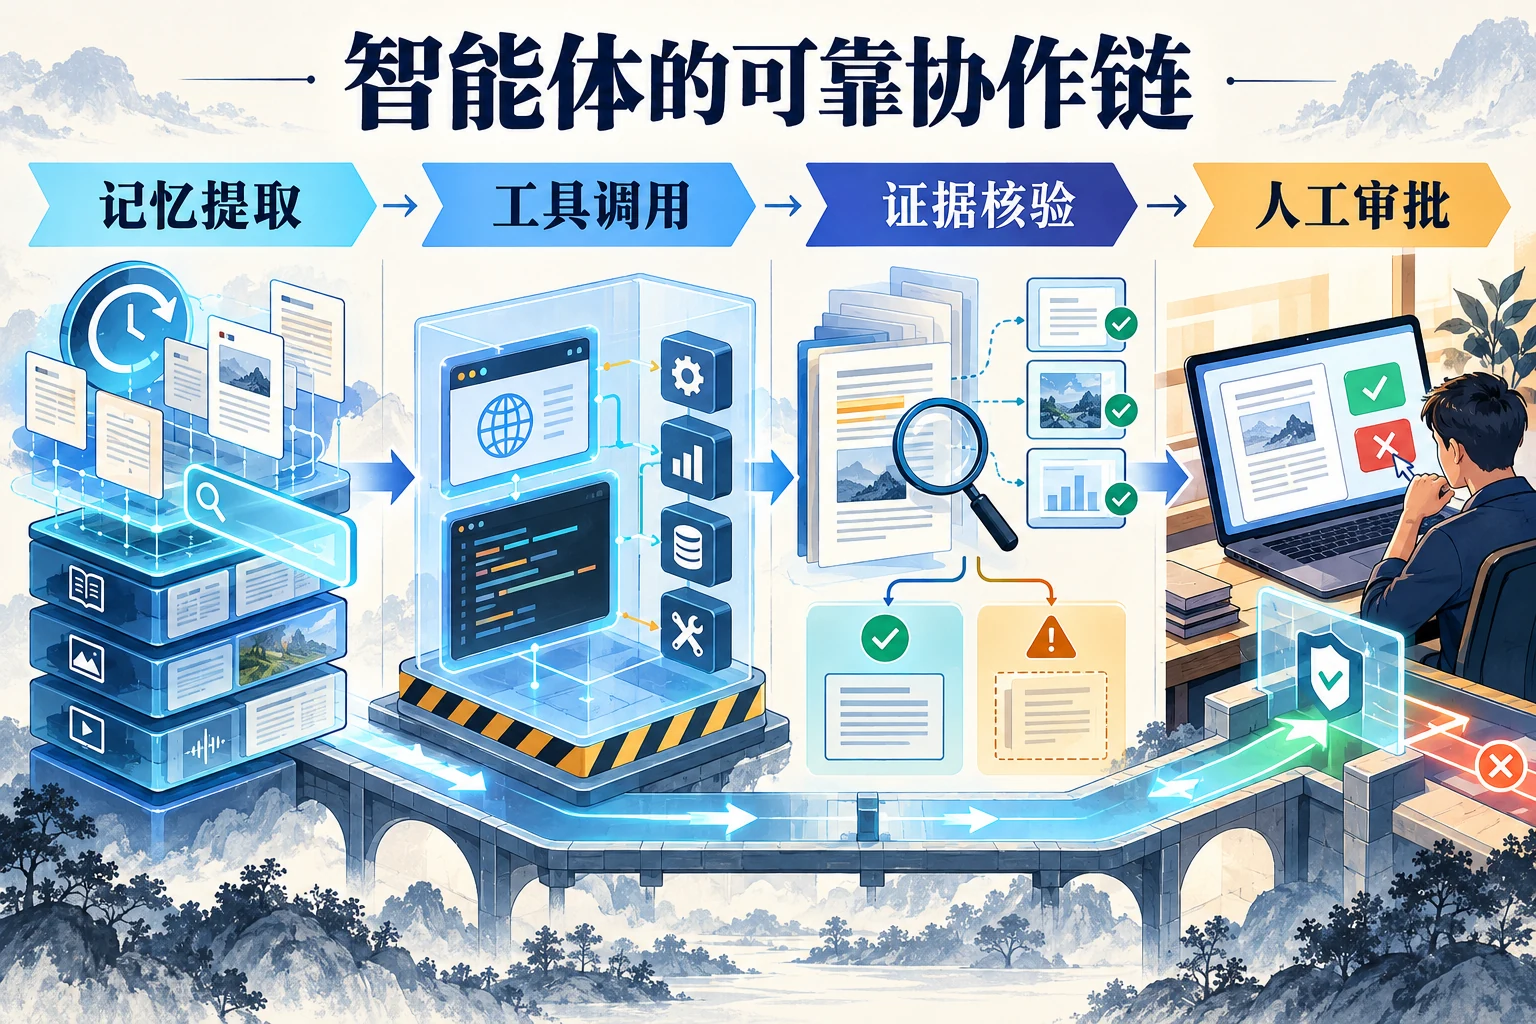
以企业销售场景为例,系统要读历史记录、查最新消息、提出跟进建议,还可能更新CRM。它要在多次工具调用后保留任务目标,碰到相互矛盾的信息时知道回查,并识别哪一步必须交给人批准。数学、代码或阅读理解的单次得分,解释不了一条工作链会在哪里断掉。EMNLP今年围绕真实环境的讨论,恰好把这种差别摆上了台面。
一、长程任务如何改变记忆设计
早期生成式AI产品大多是“响应式系统”:用户提出问题,模型生成回答。随着工具调用、代码执行、浏览器操作和多智能体协作进入产品,模型开始承担更长的工作链条。比如企业销售智能体接到“帮我分析这家客户是否值得跟进”,可能需要从CRM调出客户历史记录,搜索对方近期新闻,读取过去邮件,分析报价与采购规模,判断是否存在竞争对手,生成下一次跟进建议,最后更新CRM并提醒销售人员。
单个步骤未必复杂。难处在于走到第7步时,系统还得记住第1步的条件,核对搜索结果与历史记录的冲突,并区分可自动更新与须人工批准的字段。这类跨步骤的状态维持,对应议程中所说的“long-horizon memory”。长程记忆并不是把上下文窗口简单扩大到100万Token。一个持续运行的Agent会遇到三种典型问题。第一种是信息会变化。昨天的客户状态和今天可能不同,如果模型只把所有历史内容机械堆在一起,它很容易同时看到两个互相矛盾的版本。
第二种是信息分散。任务状态可能存在数据库、文档、聊天记录、工具日志和模型内部摘要里。如何把这些信息组织成统一、可更新、可追溯的记忆,是比“上下文长度”更难的系统工程问题。第三种是历史错误会积累。如果前面的步骤误判了一个事实,后续十几步全部围绕这个错误继续执行,最终结果可能看起来逻辑完整,却建立在错误前提上。长程任务需要一套管理事实版本、任务状态和执行证据的记忆系统;单纯增加上下文容量,解决不了版本冲突。
二、世界模型怎样处理现实约束
Pascale Fung在EMNLP主旨报告中讨论“world models”,对应一个长期难题:语言模型对现实世界的理解,很多时候仍然停留在文本相关性。语言模型很擅长根据大量文本学习“什么经常和什么一起出现”,但真实世界存在物理规律、时间顺序、空间约束和因果结构。
例如,机器人看到一个杯子,不能只知道“杯子通常放在桌子上”,还要知道杯子的空间位置、重量、是否被其他物体挡住、抓取后会发生什么。一个企业智能体看到“订单延期”,也不能只根据词语相关性判断风险,还需要理解库存、交期、产能、供应商和客户优先级之间的关系。世界模型要把环境变化表示成可用于预测的状态。
对于工业场景,这一点尤其关键。数字孪生可视为工程化世界模型:它用对象、物理状态和约束描述系统,三维画面只是可能的一种呈现方式。因此,AI世界模型与工业数字孪生有了可以对接的地方。语言智能体可以负责解释任务和理解意图;数字孪生负责提供可计算的现实约束;专业求解器负责判断动作是否满足物理规律。三者协作,工业智能体才有条件核对现实约束。
三、多智能体协作为什么比单智能体更难
Mohit Bansal的报告把“trustworthy collaboration”列为一项挑战。过去两年,多智能体系统受到大量关注。一个Agent负责规划,一个负责搜索,一个负责代码,一个负责审核,看起来比单模型更像一个真实团队。问题在于,人类团队协作依赖明确的角色、责任和信任机制,而多个模型之间如果没有边界,很容易出现三类失控。
第一类是错误共识。多个智能体共享了同一条错误信息,最后一致得出错误结果。数量增加并不会自动提高正确率。第二类是权限传递。上级Agent把任务发给下级Agent时,如果消息来源标签丢失,下级系统可能把“另一个Agent的建议”误认为“用户直接命令”。
第三类是说服偏差。模型可能通过语言影响其他模型的判断。当一个Agent非常自信地表达错误结论,其他Agent是否会被带偏?这与人类组织中的群体思维非常相似。多智能体系统需要明确的职责与授权,单靠把几个Agent放进同一段对话还不够。每个Agent需要有职责范围、可访问的数据、可调用的工具和最终批准权限。
四、论文评审实验:AI适合做哪一步
EMNLP今年还设置了“AI Reviewing Experiment”的初步报告。科研评审是一个典型的复杂任务:评审者要读论文、理解贡献、核查实验设计、判断与既有研究的差异,并给出理由充分的评价。这与企业知识工作非常接近。如果AI能够辅助评审,理论上可以降低重复阅读和资料检索成本;但另一方面,论文评审高度依赖学术判断,错误摘要、遗漏关键文献或者对实验统计的误读,都会直接影响作者。AI评审实验可以用来划分适合交给机器的环节,以及仍须评审者作判断的环节。
可供辅助评审的环节包括检查参考文献格式、辅助寻找重复工作、检查实验是否遗漏关键对照、提醒评审者可能忽视的材料,以及对评审意见进行一致性检查。最终录用判断依然需要人的责任承担。企业部署Agent也可先交给它容易验证、能够回放的步骤,随后再视运行情况扩大任务范围。
五、从EMNLP看未来一年:智能体评测将越来越像软件工程
一张排行榜足以展示单项模型得分,却难记录Agent完成任务的过程。评测Agent还需要可复现的测试环境。评测环境至少应该记录任务目标、使用的数据和调用的工具,中间发生多少次失败、什么时候重试、是否访问了不该访问的资源,以及最终结果是否正确、总共花了多少时间和成本。企业部署时,这些执行记录通常比单一Benchmark分数更有用。
如果两个Agent最终都完成任务,其中一个调用工具30次、花费20分钟,另一个只调用8次、花费4分钟,那么产品价值完全不同。此外,Agent的结果还需要可复现。同一个任务执行10次,如果有3次失败,企业就要知道失败发生在哪一步。EMNLP 2026的这些议题,也让任务执行过程进入了研究讨论。
聊天框外,还要有可追溯的执行链
从2023年的聊天机器人走到2026年的智能体系统,模型能力仍是起点,使用体验却越来越取决于记忆管理、工具调用、权限控制和失败后的恢复。同一项任务执行十次,哪一步容易出错、重试要花多少时间,都应当能查。世界模型和数字孪生为行动提供环境约束,专业求解器负责具体计算;在人参与的业务里,最终批准权也要留在清晰的岗位上。能把这些环节接起来、长期稳定完成任务的系统,才经得起企业场景检验。
参考资料
-
EMNLP 2026 Conference Overview
https://2026.emnlp.org/program/ -
EMNLP 2026 Keynotes
https://2026.emnlp.org/program/keynotes/ -
EMNLP 2026 Industry Track
https://2026.emnlp.org/program/industry/