管网模型算得快,才有机会赶上现场
工业仿真在设计阶段很有用,设备投产后却常被留在项目文件夹里。现场数据和模型参数一直变化;每次计算还要人工准备数据,结果往往赶不上调度节奏。全国主干天然气管网包含多个气源、压缩站和用户,离线模型尤其难以承担日常运行支持。
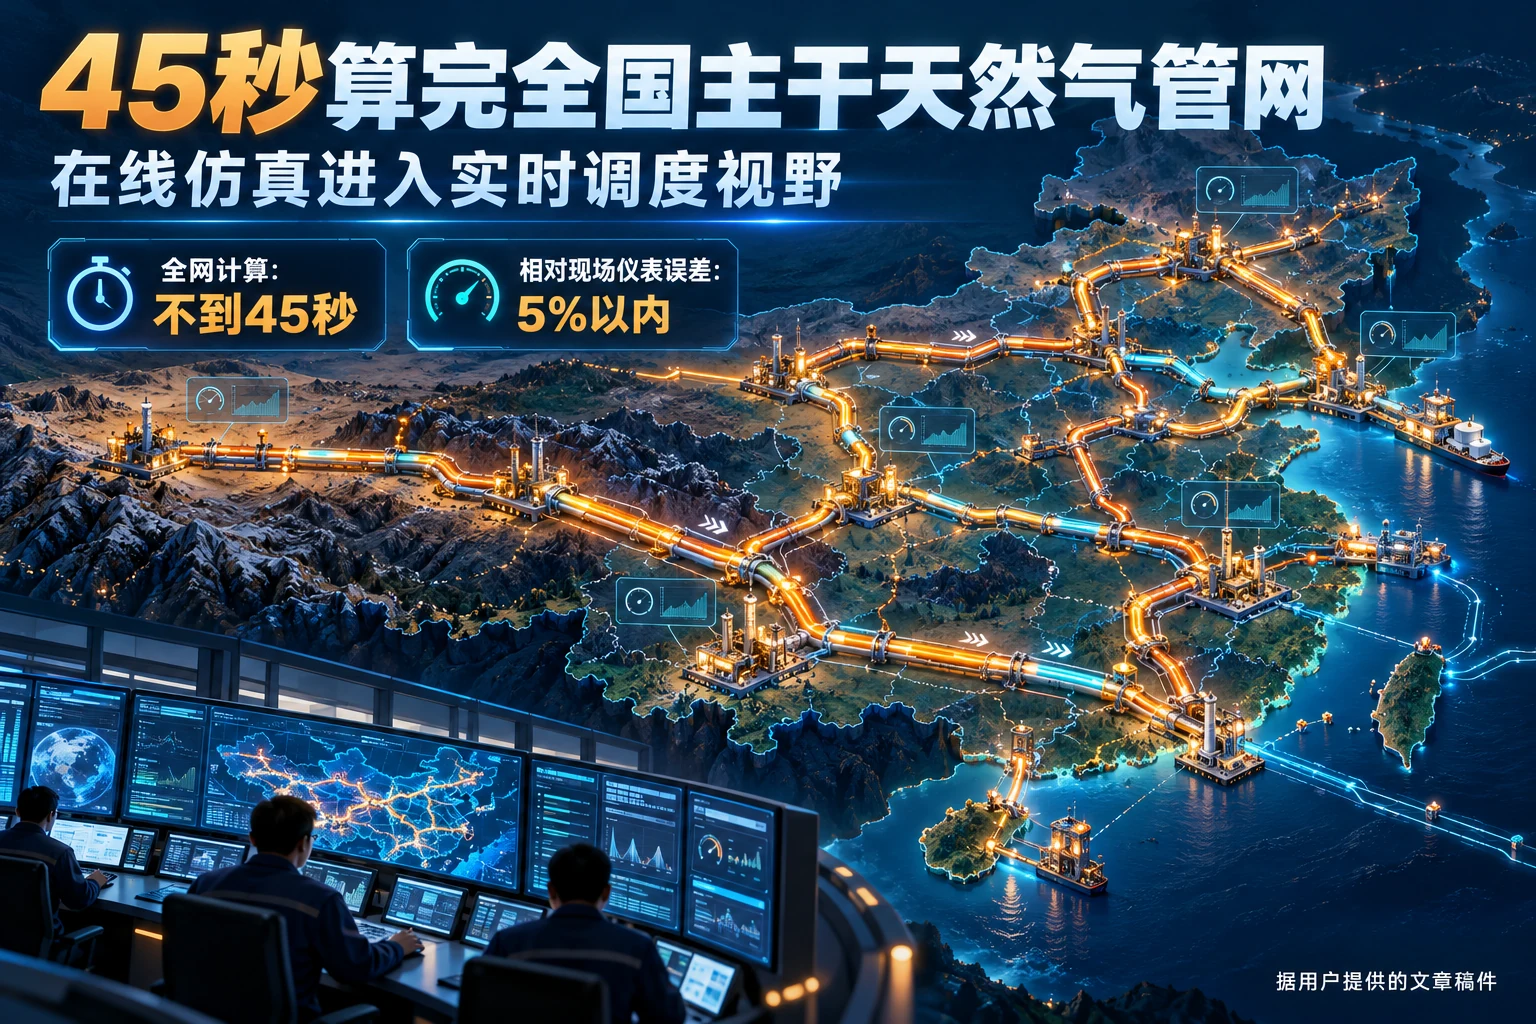
国家管网集团研究总院此次披露的超大规模天然气管网在线仿真系统,已应用于全国主干天然气管网。按官方披露,一次全网计算不到45秒,计算结果与现场仪表数据的相对误差控制在5%以内,并可依据未来24小时用气变化预测运行状态。这里值得细看的是计算频率和现场数据的配合:求解器进入持续运行的流程,调度员才可能用它检验下一步操作。
一、天然气管网为什么特别适合数字孪生
天然气长输管网是一个高度耦合的动态系统,单看管道分布还远远不够。管网内部存在压力、流量、温度和压缩机状态等变量;某个城市用气突然增加,可能改变上游多个管段压力,一个压缩站调整运行模式,也可能影响几百公里之外的供气能力。
这类系统首先是规模大:全国主干天然气管网跨越多个区域,包含大量管段、阀站、压缩机和气源节点。其次,状态持续变化,天然气需求有明显昼夜变化、季节变化和突发波动。安全要求也极高,调度系统不能只给出一个“可能有效”的建议,还得让压力和设备运行状态处在安全边界内。
实际调度还需要提前预测。如果等压力异常发生之后再处理,已经太晚;调度员需要知道几小时后甚至一天后的状态。系统规模、连续变化、安全边界和提前预测的需求放在一起,正是天然气管网适合采用在线数字孪生的原因。
二、45秒能改变调度节奏吗
不到45秒,改变的是调度员能否及时拿到计算结果。传统工业仿真中,一次计算花几十分钟甚至几个小时并不少见;如果计算需要两小时,它适合做设计分析,却很难参与生产调度。缩短到45秒后,系统可以周期性重新计算,让仿真定期参与运行判断。
假设每5分钟进行一次全网状态更新,45秒求解意味着还有时间用于数据同步、结果分析和调度决策。如果系统还能够基于未来24小时用气预测进行多情景计算,调度员就可以检验明天北京地区用气增长10%时哪些管段压力会下降、某个气源供应减少时应该调整哪些压缩站,以及极端寒潮下现有供气能力能否满足需求。过去依赖调度专家经验回答的问题,如今可以由模型辅助判断。
三、误差5%背后,是工业模型最难的数据问题
官方披露在线模型与现场仪表数据的相对误差在5%以内。要维持这个误差范围,还得持续处理现场数据和模型参数,因为现实中的工业数据并不“干净”:压力传感器可能漂移,流量计存在误差,设备状态可能未及时更新,管道粗糙度会随运行时间变化,气体组分和温度也会影响计算。
因此,在线仿真系统必须不断做模型校准。三维画面可以展示设备;工程数字孪生还要反复对照仪表读数,校正计算与现场的偏差,这种一致性需要长期数据支持。如果工业AI要调用模型,传感器读数与参数版本同样需要可追溯。
四、从“仿真系统”到“智能调度”,中间还有关键一步
在线仿真能预测工况,距自动调度仍有优化、审批和控制几个环节。在线仿真解决的是“如果这样运行,系统会发生什么”,智能调度还需要回答“应该怎么运行”。优化问题包括开启哪些压缩机、压力设定值是多少、不同气源如何分配、储气设施什么时候注气或采气,以及怎样降低能源消耗。
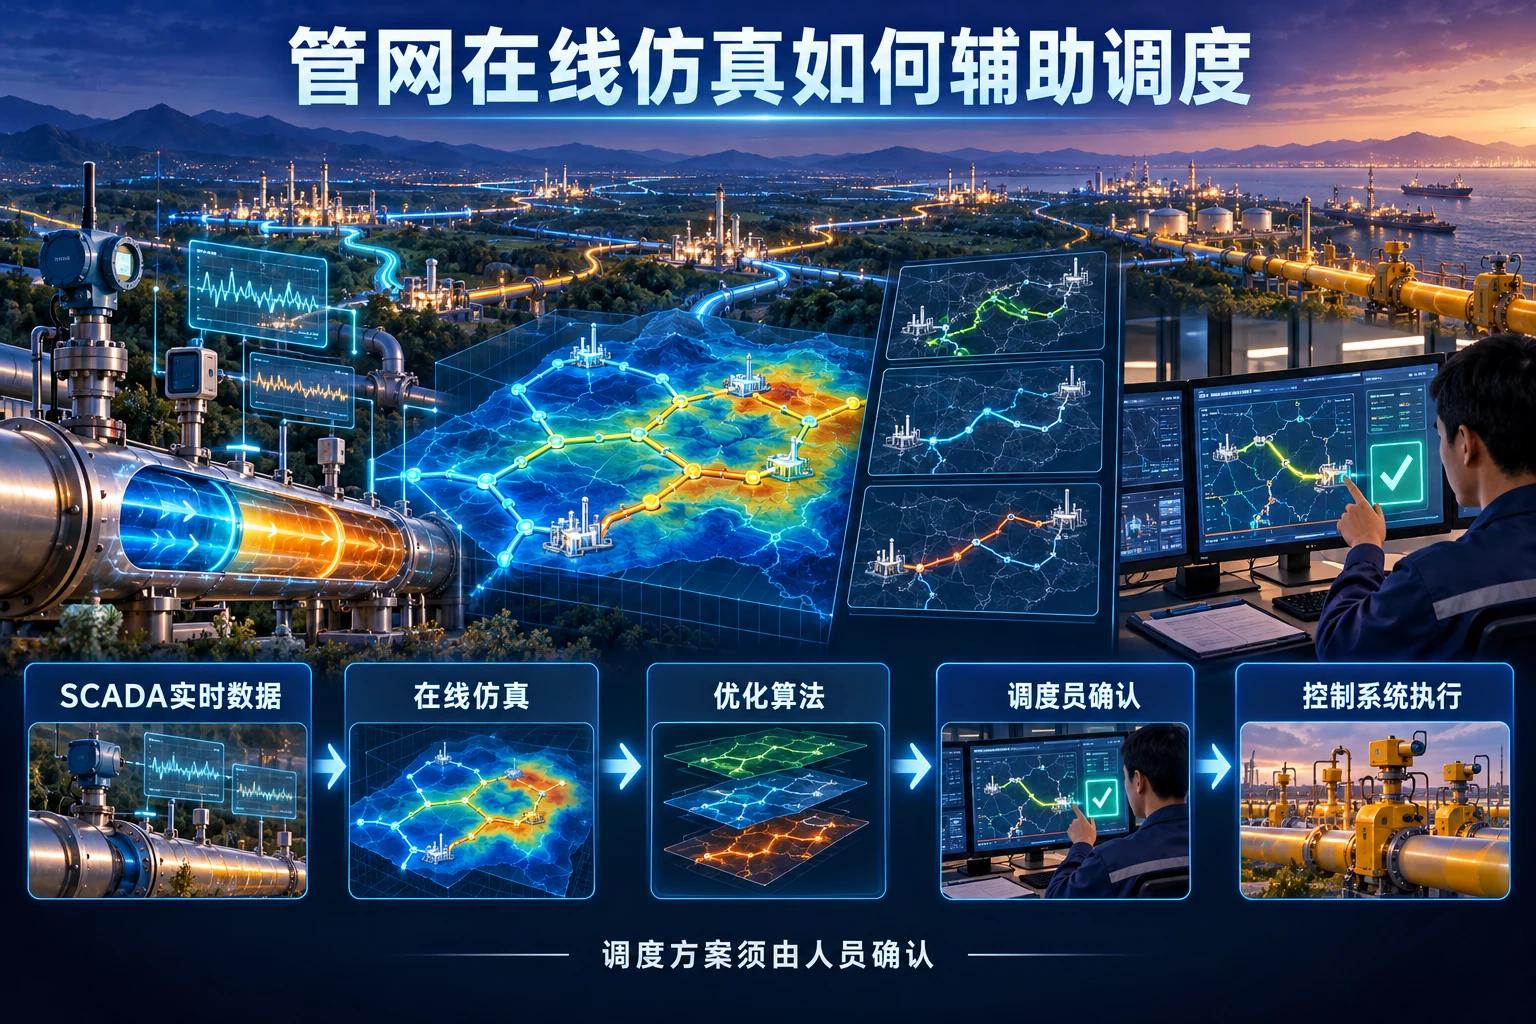
优化算法可以在仿真模型之上不断测试方案,AI智能体则可以理解调度需求、调用仿真、比较结果,并给出方案说明。比较理想的工业智能体系可能是:
SCADA实时数据 → 在线仿真模型 → 优化算法 → AI智能体解释 → 调度员确认 → 控制系统执行。
在这个架构中,专业求解器负责物理计算,大模型负责调度任务、调用软件和解释结果;调度员确认与控制系统执行仍是链条里的独立环节。
五、这对国产工业软件意味着什么
长期以来,国产工业软件讨论经常围绕CAD、CAE和PLM,油气、电力、化工等行业其实还有大量高度专业的行业软件,管网在线仿真就是典型例子。这类软件直接参与关键基础设施运行,可靠性和行业适配比通用市场用户数量更重要。
一套全国天然气管网在线仿真系统,需要同时解决大规模网络求解、工业数据接入、实时状态估计、高可用部署、模型版本管理、安全权限和调度业务接口。这些环节让软件必须按工业基础设施的要求运行和维护;管网这样的深行业场景,也为国产工业软件提供了具体的使用与检验条件。
六、这类系统很适合接入工业智能体
在线仿真有一个现实问题:使用门槛高。专业工程师知道怎样设置模型参数、判断结果,但大量业务人员并不熟悉求解器。智能体可以把自然语言任务转换成专业仿真任务;调度员比如会问:“如果明天华北需求增加8%,哪几条管段最紧张?”
接到这样的任务,Agent可以调用需求预测、生成仿真工况、运行在线模型、读取结果,再生成风险排序并解释原因。大模型承担理解、组织和解释任务,物理计算仍交给在线仿真;这种分工给“AI+CAE”提供了一条可落地的路线。
七、持续运行留下哪些数据资产
过去仿真数据往往是一次性的:工程师计算完一批工况,结果便存进项目目录。在线仿真则会不断产生每天几百次的系统状态、预测与实际偏差、调度动作前后的系统变化、设备效率变化和异常事件。如果记录与回放机制完备,这些运行记录便可积累为数据集。
这些数据未来可以用于训练运行状态预测模型、发现设备性能退化、优化求解器参数、建立异常工况样本库以及训练调度辅助Agent。对这类工业任务,“真实系统运行—模型预测—实际结果”的成对记录,直接关系到模型校正与评估。
下一步,看仿真怎样接上决策
不到45秒完成一次全网计算,给周期性状态更新留下了时间。若要进一步用于调度,还需把现场数据接入、工况预测、优化建议与调度员确认串成可运行的流程。
在这条链上,专业模型计算压力和流量,大模型可以解释需求与结果,业务系统留存审批记录,控制系统执行经确认的动作。对管网这样安全要求很高的系统,各环节的责任和数据质量,比给软件贴上“智能”标签更实在。
参考资料
-
天津政务网/天津日报:《不到45秒“看透”全国主干天然气管网》
https://www.tj.gov.cn/sy/tjxw/202610/t20261025_7641174.html -
国家管网集团官方网站
https://www.pipechina.com.cn/