每天处理约300万次搜索请求,平均回答速度提高20%,所需计算资源降到原来方案的三分之一。欧洲搜索公司Qwant披露的这组数据,让“主权人工智能”第一次在大量普通用户熟悉的搜索场景中呈现出具体的运营面貌。2026年11月19日,Qwant、Shadow、European Search Perspective(EUSP)与OVHcloud在OVHcloud AI Summit上宣布技术和商业合作,准备把欧洲Web索引、语言模型、GPU计算设施和搜索应用连成完整服务链。Qwant搜索结果页面的快速回答功能已经使用OVHai LLM开发的Olala mini 7A1B,在Shadow的GPU Blade平台上执行推理;公布的数据来自这一实际运行的服务,因而比单纯把新模型放到榜单中更能展示产品选择背后的经济逻辑。
这次新公告的关键日期是11月19日。OVHcloud在11月17日先行介绍Olala系列第一款模型,11月19日则发布搜索合作的技术与商业安排,并集中展示55项围绕云和人工智能的产品服务。两个日期代表了不同事件:一个是模型家族公开预告,一个是把模型连到用户流量、算力资源和商业合作方的系统发布。OVHcloud的官方会议博客介绍,Olala 1.0 mini 7A1B的总参数约70亿,每次请求只激活约10亿参数;模型使用混合注意力架构,并计划以Apache 2.0许可公开权重、代码与相关合规文档。这种轻量设计给高频问答提供了新的部署选择。
为什么搜索业务最能检验小模型的成本
搜索快速回答的任务高度重复,却有很大的请求规模。用户输入一两句问题,检索系统要从网页索引中定位相关内容,整理证据片段,再由模型生成语言自然、来源可追溯的摘要。单次处理看似简单,产品部门每天面对的却是请求量、峰值并发、延迟分布、答案点击率、硬件利用率和单位请求成本。大型模型的综合能力强,但为所有短问答都调用高成本推理资源,可能使大量计算预算消耗在问题改写、资料压缩和简单描述上。针对这种业务设计的小模型,可以把频繁出现的任务高效完成,把复杂推理需求留给更大模型处理。
Olala mini采用稀疏激活设计,总模型拥有较多参数,但处理一次请求时只调动其中一部分专家模块。OVHcloud介绍的技术路线还引入Differential-TPA与Mamba-3等混合结构,以减少特定长序列推理的计算与内存压力。厂商在11月17日的公告中披露,模型可以在至少8GB显存的GPU上运行,在RTX A4500上报告每秒160个token的吞吐,在普通CPU上也报告每秒50个token。这里的吞吐依赖于测试硬件、输入长度和推理设置;Qwant公布的实际在线业务表现,则让模型路线的价值可以进一步换算成服务容量和响应时间。
一天300万次请求若均匀分布,平均每秒约35次;实际搜索流量有明显的昼夜、工作日和突发热点波动,运营方需要针对峰值配置缓存和推理实例。资源消耗下降到原来的三分之一,意味着同样的服务负载可以用更小的计算预算支撑,或在预算不变时覆盖更多请求。Qwant没有在这则公告中公布完整财务报表,因此这组比例最适合用于说明计算资源效率的变化。结合20%的响应提速,可以看到模型选型、部署和业务场景共同优化带来的结果,而不是简单依赖模型规模增长。
欧洲主权AI的四层拼图
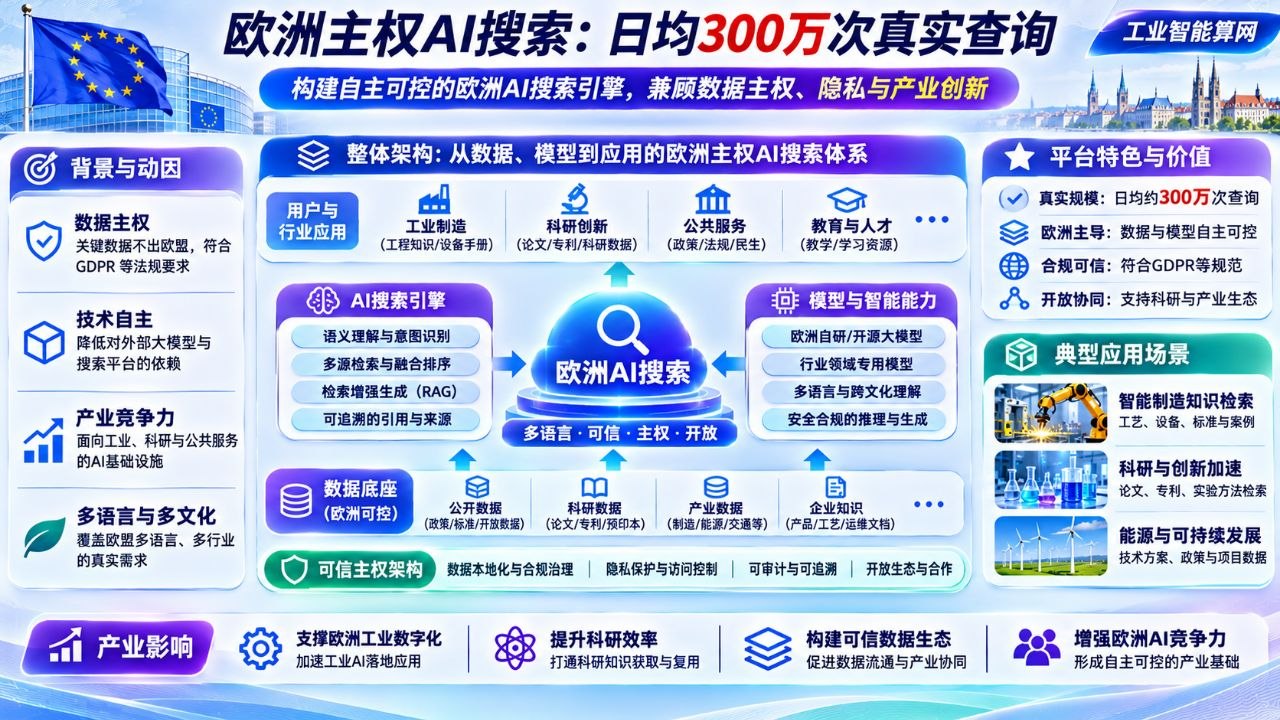
从系统架构看,四家公司的分工相当清楚。EUSP与Qwant掌握搜索产品及索引能力,OVHai LLM提供语言模型,Shadow运行用于推理的GPU平台,OVHcloud将这些能力与其云服务、数据中心及企业客户网络联系起来。用户发起查询,搜索基础设施提供文本证据,模型根据检索内容形成回答,结果进入Qwant界面。工程师可以在不同层次检查异常:索引未找到资料属于检索问题,模型表达偏离证据属于生成环节问题,首字延迟过高则需要检查计算实例、缓存与调度策略。
这种端到端产业链是欧洲近年来推进数字技术自主能力的具体表现。主权AI常常涉及数据存放地区、计算设施控制权、软件供应来源和运行过程的可审计性。只拥有欧洲数据中心而使用完全不可控的模型服务,产品方仍要面对模型接口、版本、定价和调用规则的变化。只训练一款欧洲模型而没有稳定业务流量,又难以形成持续的工程反馈。搜索合作把上述问题放在一项日常服务里处理,使不同企业分别承担自己擅长的部分,并让终端产品的性能作为合作的共同目标。
OVHcloud官方介绍,Olala模型在Jupiter、MeluXina和Jean Zay三套欧洲公共超算基础设施上训练。训练设施的开放支持与生产推理设施的商业运营由不同机构承担,形成研究、训练、部署和服务相互衔接的结构。大型公共计算资源帮助企业获得基础模型训练能力,云服务商把模型转换成可重复部署的推理服务,应用厂商则通过日常用户反馈判断质量。欧洲技术生态选择以开放模型和商业合作组合参与市场竞争,也为需要本地化、特定行业语言或区域合规的企业提供了新的供应结构。
工业智能体如何复用这套成本逻辑
将这一经验放到工业企业,最容易找到对应的场景是设备文档搜索、售后答疑、物料标准查询和操作记录归纳。设备制造商可能拥有数万份产品说明、维修手册、工艺卡、认证报告与备件表。销售助手每天需要回答大量重复问题:某型号泵的连接尺寸、某个密封件的材料代号、某类控制器支持的通信协议、某个零件对应哪些替换料号。检索系统先定位文件,轻量模型进行摘要和格式化输出,少量涉及复杂工艺推断的任务才交给更高计算成本的模型和专业工具。
企业还可以通过不同模型的路由设计来控制成本。知识检索和简单填表走本地小模型,跨系统工艺分析走专业Agent,复杂代码修改调用具备工具能力的大模型;各类任务的输入长度、输出量、执行时间和成功率都可以记录。模型是否部署在一台工作站、边缘服务器或云计算环境,需要根据现场数据位置和调用频率选择。对要求“数据不出厂”的制造企业而言,开放模型可以与本地文件系统、权限系统和设备数据接口结合,构成更容易控制的岗位智能体。
搜索产品提供的另一条经验是把高频真实任务变成质量数据。用户重复搜索某个问题、点击答案后又打开手册、对维修步骤提出纠正,都是改进知识服务的线索。制造企业可以把售后工单、问答记录、技术文件版本变化与产品编码关联起来,观察模型在哪些知识范围内比较稳定、哪些领域需要重新检索和人工补充。运营数据长期积累后,模型选型就可以从展示环节的主观印象进入成本、效率与业务指标的联合评估。
从单款模型发布到完整产业产品
OVHcloud在11月19日展示的55项产品和服务,覆盖推理、编排、云基础设施与AI增强型平台,OVHai Workspace则面向企业工作环境。这样的组合反映出模型服务正在进入普通软件采购和业务运营流程:企业要购买的不只是推理接口,还包括账户管理、数据接入、费用控制、模型版本管理和与既有系统协作的方式。对于云服务商来说,模型可以是用户进入云生态的入口;对于搜索公司来说,推理效率直接影响每次查询的成本;对于行业应用服务商来说,能够部署并持续迭代的模型接口才方便交付。
欧洲这组合作最值得继续研究的指标,已经直接写在实际运营中:日均服务请求量、计算资源消耗比例和响应速度。背后是从公共超算训练到商业GPU推理、从开放模型到用户产品的完整链路。工业企业沿着同样的思路建设本地智能体时,也能够把“模型有多大”的讨论转成每份文档的检索耗时、每张工单的处理成本、每项工程任务的完成质量和长期可维护性,逐步让AI进入真实生产经营的预算与考核体系。
这种产品化路径对中小软件公司也有启发。过去自己训练大模型通常需要完整的算力团队与训练数据管线,今天开发行业应用更容易从成熟开源权重开始,在检索、任务分解、缓存、工具权限和监控上积累差异化能力。只要服务对象的请求模式足够清晰,专门设计的工作流就能让相对有限的计算设备处理有规模的业务量。Qwant已经运行的快速问答服务,是这一工程路线在互联网高并发场景中的实例;制造、政务和专业信息服务可以根据自己的业务特征进行改造。
参考文献
- OVHcloud,2026-11-19,Qwant, Shadow, EUSP and OVHcloud join forces to accelerate sovereign European AI:https://corporate.ovhcloud.com/en-gb/newsroom/news/qwant-shadow-eusp-ovhcloud-alliancy/
- OVHcloud,2026-11-17,OVH announces Olala mini 7A1B:https://corporate.ovhcloud.com/en/newsroom/news/ovh-olala-mini/
- OVHcloud,2026-11-19,OVHcloud AI Summit 2026: AI from prototype to Production:https://blog.ovhcloud.com/en/posts/ai-summit-2026-announcements/
- OVHcloud 官方新闻页,2026-11-19 相关发布:https://corporate.ovhcloud.com/en/newsroom/news/