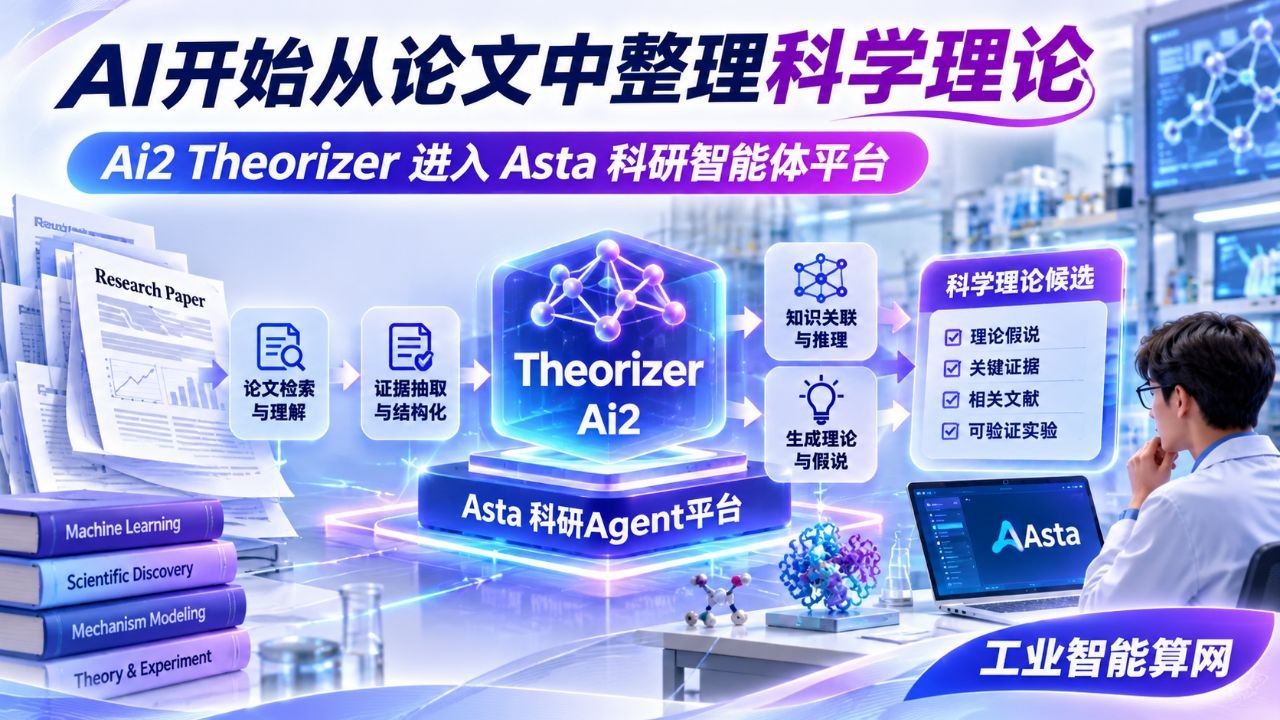
一位研究肺癌的医生在临床上遇到不符合既有解释的病例:病人对治疗的反应出乎预料,肿瘤DNA与RNA检测却提供了大量零散线索。要把这些线索变成可供实验检验的假说,研究人员通常需要检索数百篇论文,分别核对样本、变量、治疗条件和统计结论,再把不同实验室的发现放到同一张逻辑图上。艾伦人工智能研究所Ai2在2026年11月19日发布的《Theorizer comes to Asta》中,介绍了与Providence Swedish Cancer Institute胸部肿瘤项目医疗负责人Sid Devarakonda的合作。Devarakonda看到系统提出的第一批理论时,发现其中包含自己经过多年研究才逐渐形成的想法。由此可见,科研智能体已经开始触及科学知识组织中相当费时间的工作:在大量相互独立的观察结果之间发现可解释的结构。
Ai2这次把Theorizer放进Asta科研智能体平台,并同步公开实现代码。Theorizer本身在2026年1月28日已有技术报告和研究原型,11月19日的新进展是研究人员能在Asta中使用它,以自然语言提出研究问题,查看它所整理的证据和理论,也可以通过开源库改变运行流程。Ai2介绍,Asta网页界面提供有额度限制的推理费用支持;选择自己部署的研究人员可安装开放库并按使用量支付模型调用费用。工具从论文中的方法演示进入实际科研工作台后,最容易变化的是研究者的使用频率:以前需要专门组织一次文献综述的任务,可以在新实验结果出现后持续更新。
从找到论文到生成可讨论的理论
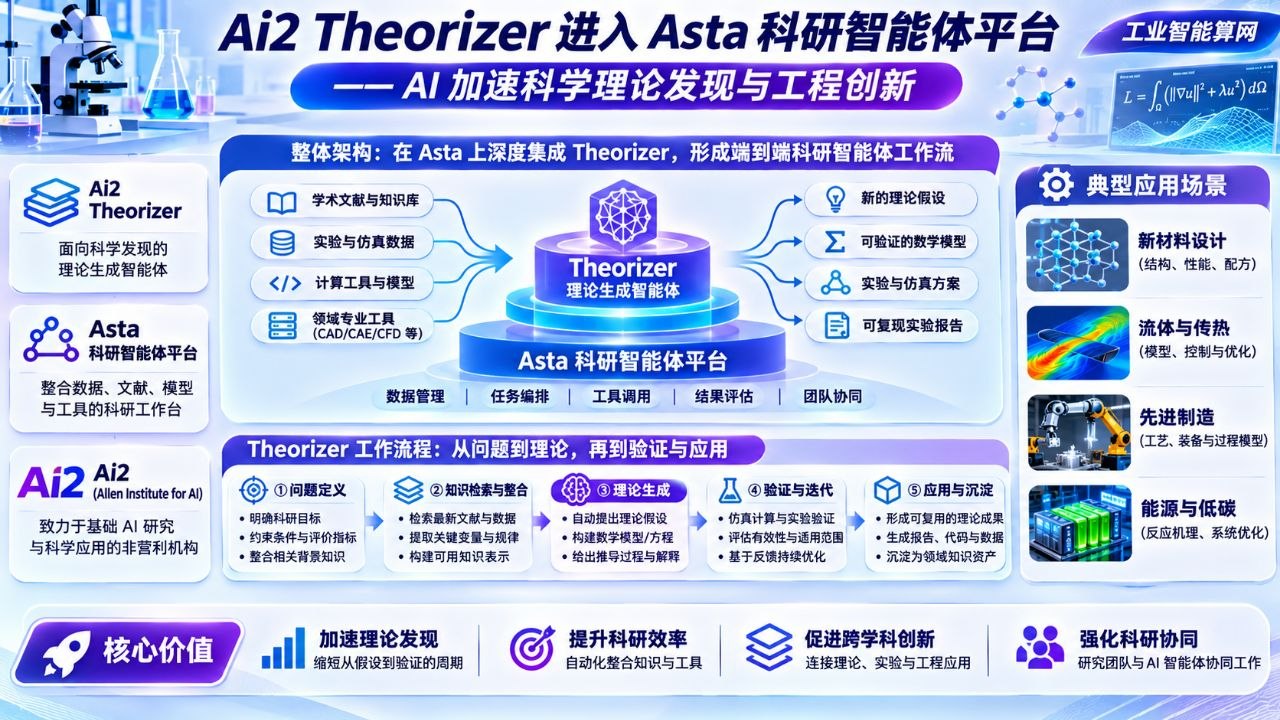
传统的学术搜索把关键词、作者、会议和引文关联起来,返回一个候选论文列表。研究者读完摘要之后,再决定要不要下载全文。Theorizer把后续工作也纳入流程:根据问题构建检索式,调用学术检索服务,寻找开放获取的论文全文,再将文献转换成可处理文本。Ai2在1月的技术说明中介绍,系统通常围绕一个问题收集最多约100篇相关论文;若直接检索结果不足,会根据候选文献中的参考资料继续扩展。选择100篇这一数量,是在检索覆盖率、上下文开销和抽取成本之间设定的工程预算。它给研究者一个可检查的证据集合,便于发现哪些研究被纳入,哪些研究仍处于外围。
接下来较难的一步,是为证据抽取设计结构化字段。假如问题是“什么条件下记忆增强语言模型会改善问答性能”,系统需要标出任务类型、记忆机制、模型规模、数据集、对照组和结果指标。对于肿瘤生物学,字段可能换成突变类型、药物、治疗周期、组织样本和分子通路。每篇论文里的自然语言表述千差万别,采用统一字段可以让不同研究结果在一个坐标系里比较。科研智能体随后根据这些条目归纳规律、提出带适用范围的命题,再回到证据检查是否存在矛盾或遗漏。最终的产物更接近一套有出处的研究假说以及它们的证据链,研究者可以从命题回看原论文。
Ai2此前报告了一个较大规模的实验:围绕100个理论查询,处理13,744篇来源论文,合成2,856个理论候选,很多理论包含一到两条规律。相关数据集约有3000项理论,研究者可以检查其来源摘要和归纳路径。这个数字是科研系统的大规模实验结果,并不表示实验室已经验证了同样数量的自然规律。科研理论要拥有预测力,仍然要进入实验设计和结果复核环节;系统在前端整理已有证据,可以让科学家把更多时间投入能区分不同解释的关键实验。
为什么科学研究需要“理论生成”这一层
过去十余年的科研人工智能主要发展了几条路线。搜索与文献问答帮助找到资料;生物信息模型识别蛋白质结构或基因表达模式;实验自动化平台通过机器人采样和测量积累新数据;机器学习模型对特定预测任务进行拟合。许多系统能处理单个研究环节,但研究项目持续推进时,真正耗费科研人员精力的工作是跨越环节解释结果。一次材料疲劳测试出现异常,工程师可能需要同时查找载荷谱、热处理记录、显微结构、裂纹扩展理论和类似材料的论文,才能决定下一轮试验测什么。Theorizer所处理的就是这种从“已知观察”通向“可检验解释”的中间层。
这一层也最适合把研究人员的经验显式记录下来。资深专家通常知道某个实验规律只在特定温度、样本规模和加工方式下成立,甚至知道几篇结果不一致的论文是因为测量仪器不同。把样本类型、适用边界与证据来源直接作为数据字段,后来加入项目的研究人员就能迅速理解判断依据。科研团队还可以把失败实验、内部报告和公开论文连接到同一套证据结构中,让知识积累跟随项目迭代,而不是依靠个人邮件与文件夹命名传递。
放到工业研发:一张工艺参数表背后的知识网络
以高端泵阀研发为例,客户反馈一批机械密封在特定介质下寿命下降,研发团队可能拿到维修工单、密封面照片、材料检测结果、CFD流场仿真与供应商工艺参数。单独阅读每份资料容易得到局部解释:某种涂层磨损、颗粒物浓度提高、温升异常或装配预紧力不稳定。若把这些资料转换为统一的证据字段——设备型号、介质、温度、转速、压差、材料批次、加工工艺、故障时间与试验方法——便可以形成跨项目检索和比较机制。类似Theorizer的理论整理工具可以从公开论文提出若干机理候选,再通过企业内部数据对照,帮助工程师确定需要新增哪些传感器、哪些工况试验和哪些显微分析。
再往前走一步,仿真与试验团队可以为每一条理论候选附上计算证据:热流耦合分析得到的温升分布、材料本构模型给出的应变集中位置、台架试验测得的失效时间。理论命题和数据对象之间建立引用关系后,CAD、CAE、LIMS、PLM以及企业文档管理系统中散落的研发记录就形成了可以反复使用的知识资产。工业智能体负责按需查找文献、构造数据查询与准备计算输入,专业仿真工具负责求解,试验人员负责测量,产品工程师把结论落到设计变更单和工艺卡里。这样的协作方式需要各个环节能输出可追踪的中间结果,而Theorizer提供的是前端文献组织环节的技术参照。
开源把研究工具变成可定制的工程能力
Ai2同步公开代码,有助于把研究流程调整到不同学科。企业可以替换文献来源、定义特定术语、设计自己的证据抽取模板、加入内部项目编号,并将结果保存为Markdown、结构化JSON或数据库记录。其开放实现包含界面、API和相关提示词,研究团队能够比较不同模型在相同论文集上的抽取结果,也能够明确哪一项费用来自检索、哪一项来自大模型推理、哪一项来自二次核对。若要处理专利、技术标准、项目报告或客户故障文档,只需围绕这些文档的结构特点重设抽取和引用规则。
在应用市场上,这种能力会推动知识服务产品出现新的分工。学术数据库可以提供高质量文献入口;专业模型负责医学、材料或机械领域的对象识别;研究机构积累经过专家审核的理论与实验记录;企业研发平台则把这些知识与设计、仿真和试验任务连接起来。以前机构购买的是数据库账号、论文下载与人工知识整理服务,今后还可能购买持续更新的特定技术专题证据库、面向某类材料的假说生成组件,以及能与PLM、LIMS交换结构化结果的研究智能体。Asta和Theorizer在11月19日的产品更新,让这一整套科研工作流有了可以直接试用、检查和扩展的入口。
研究机构如果决定将这类工具引入日常工作,还可以把每一次研究问题和证据范围做成版本。假设一支材料团队在年初依据200篇论文提出某种涂层配方的寿命假说,半年后又有新的公开研究和台架数据,系统可以比较新旧两轮证据,标注结论变化来自样本增加、测试方法改进,还是原有条件发生变化。团队负责人无需重读所有文档,直接查看更新的证据表、被修改的论点和新增试验需求,就能够组织下一轮研发评审。长周期的工业研发项目尤其需要这种持续更新机制,因为设备设计和工艺版本可能跨越数年,研究记录通常由多个单位共同维护。
参考文献
- Ai2,2026-11-19,Theorizer comes to Asta:https://allenai.org/blog/theorizer-in-asta
- Ai2,2026-01-28,Theorizer: Turning thousands of papers into scientific laws:https://allenai.org/blog/theorizer
- Asta科研平台:https://asta.allen.ai/