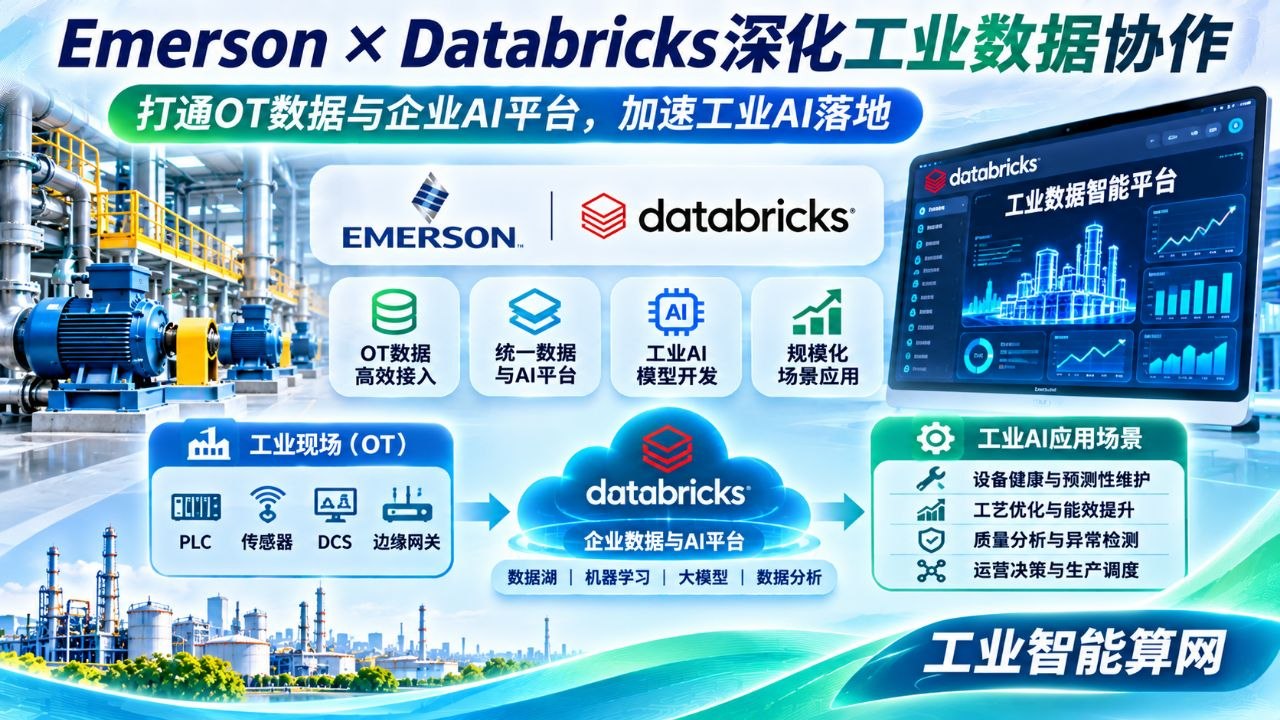
一座化工厂可能同时拥有几万条实时过程变量、数十年的设备档案、按班组记录的生产日志以及来自多个业务系统的质量和维护数据。工程师想查某台压缩机为什么连续三周能耗升高,需要把转速、入口压力、出口温度、原料性质、负载变化和检修时间排在同一条时间线上。现场DCS与Historian认识信号标签,MES认识批次和工单,ERP认识设备资产与采购成本,财务系统关注能源账单。即使厂里已经部署大模型,没有一套把这些对象关联起来的数据接口,模型也只能从局部记录里寻找答案。2026年11月19日,Emerson宣布与Databricks合作,将AspenTech Inmation OT Data Fabric与Databricks Data + AI Platform连接,向企业提供从现场工业数据到分析、AI工作流和智能体的一条通路。
Emerson官方新闻《Emerson and Databricks Collaborate to Bring Industrial and Enterprise AI Together》把合作目标写得清楚:提高运营技术数据的可访问性、上下文完整性与AI可用性,打通工厂、设备及运营数据与企业数据之间的隔离。Inmation负责连接带有时间和工艺语义的工业数据,Databricks提供数据工程、分析与AI应用环境。公告明确涉及现场、边缘和云端的实时与历史数据,重点是双方产品及服务的协作,不以某个单一模型的算法表现作为卖点。工业AI从演示环境进入企业级系统时,底层数据组织往往比模型选择更耗费工程资源,因而这次合作直接回应了制造企业长期存在的问题。
一条温度曲线为什么需要数据上下文
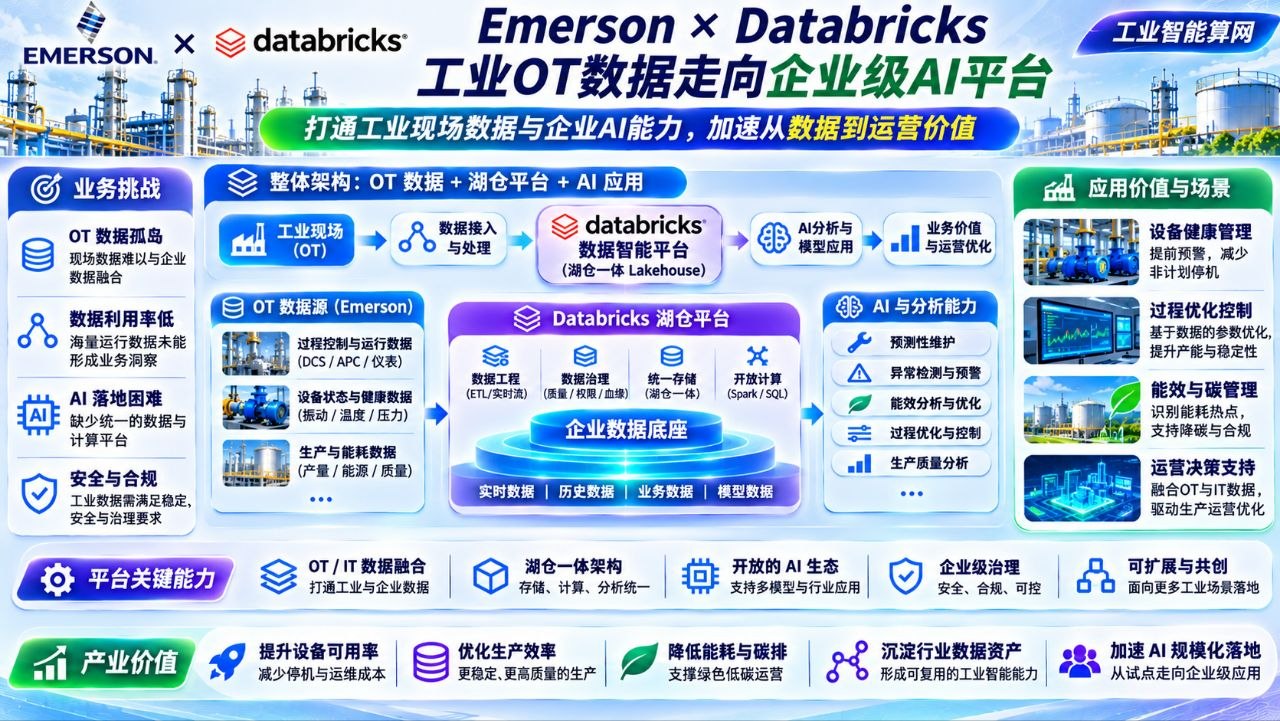
工业时间序列具有强烈的现场语义。某个标签可能表示反应釜夹套入口温度,也可能是外壳测点;测量值的单位、量程、采样间隔、传感器校准日期和控制回路关联关系,都影响分析结论。标签名在不同工厂、不同历史时期可能变化,升级项目还会把设备重新编号。单独抽取一串时间戳和浮点数,即使模型能准确拟合趋势,也很难解释结果与哪一台设备、哪一批物料、哪一个生产阶段有关。数据织物要做的工作,是在不打断现场系统运行的情况下,建立设备身份、工艺位置、物理单位、事件和数据权限之间的关联。
Inmation这类工业OT数据织物的价值正在于此。它可以面对异构现场系统整理信号、标签、时间序列和生产上下文,再向上层应用提供统一访问机制。企业在Databricks里使用这些数据时,既能进行统计分析和机器学习,也可以结合工单、质量数据和财务信息构造跨域问题。对于维护工程师,查询“上一季度同类轴承在高温工况下的故障记录”需要识别轴承型号、安装设备、时间窗口、工况标签、维修报告和替换零件;对于生产主管,判断“哪条产线的单位能耗变化最大”还要结合产量、换线、停机和订单结构。数据织物提供足够一致的对象描述,这两类查询才有共同的基础。
OT和IT之间的隔离是如何形成的
工业控制系统首先服务生产连续性与安全。PLC、DCS、SCADA通常围绕设备控制和操作员监视进行建设,历史库保存高频数据,工程站负责设备配置和控制逻辑。企业IT平台则围绕订单、采购、人员、账务、仓储与经营报表工作,很多系统的更新周期也不同。工厂投产之后,车间的系统由设备供应商和自动化集成商维护,企业信息部门负责另一套软件;同一个“设备”在控制系统中是变量与报警,在ERP中是固定资产,在维护系统中又对应工单和备件。这些系统各自完成本职工作,跨系统统计和AI分析时便需要建立额外联系。
过去企业常通过数据中台、ETL脚本、OPC UA网关和定制数据库将部分数据汇集起来。单个项目可以解决一个问题,但企业规模扩大后,接口数量、数据复制和标签治理的维护成本随之增长。一条泵组诊断链可能同时调用设备实时状态、工艺变量、试验台架数据和维修记录;另一个能效项目又需要相似数据。通过统一工业数据访问层,企业能复用同一套资产标识、数据字典、质量标记和访问策略,减少各个算法团队重复开发接口的工作。Emerson与Databricks的合作,可以放在这条工业数据基础设施演进路线中理解。
从现场数据到AI智能体,完整执行链长什么样
假设某泵阀制造企业希望建立售后故障诊断Agent。用户提出“这批机泵为什么在低负载下振动变大”,系统先根据设备号定位资产,再查询对应时段的振动、流量、压力和转速,读取维修更换记录与出厂试验报告。Agent调用时序分析工具识别特定频带和变化区间,使用设备设计参数筛选可能的运行工况,必要时引用CFD或转子动力学模型,再输出带曲线、数据来源和排查步骤的报告。时序数据库保证信号准确,PLM提供型号和BOM,MES提供制造批次,实验系统保存基线测试,行业模型负责组织任务,专业算法负责数值计算。
如果再向前一步,在工厂能源管理中部署多角色协作,能效Agent可以计算设备单位能耗,工艺Agent解释产量和配方变化,维护Agent检查异常设备的保养历史,经营分析Agent把能源成本与订单毛利关联。所有角色都使用相同的设备身份与工艺数据底座,且每次查询保留时间范围、单位与调用记录。这样的体系便于将自然语言问题转换成一串确定的工具操作,最终的计算结论可以在数据库、报表与工程模型之间相互核对。Emerson公告提到的实时及历史数据、从现场到云端的治理能力,为这一类企业级Agent应用提供了基础设施接口。
数据权限和本地部署会影响产品架构
许多制造企业要求生产数据留在厂区或私有环境。工业数据织物可以把现场实时数据留在本地,只向经过授权的应用暴露必要的查询服务;企业可根据业务选择数据驻留、边缘分析或云端处理方式。权限控制需要细到工厂、设备、变量类型和用户角色:销售智能体可以读取产品规格与价格权限内的信息,维修智能体可以读取设备状态和工单,研发智能体可以访问试验数据和设计文件,控制程序修改权限则由专用工程流程管理。这些差别会反映到数据网关、接口令牌、访问日志和结果缓存设计中。
工业数据的时间语义同样需要进入治理体系。实时点位和实验记录往往使用不同时间精度,PLC采样周期可能为毫秒级,MES工单按分钟记录,企业财务数据按月汇总。跨层分析时应保存数据的原始采样方法与聚合窗口,方便工程人员复查。对预测性维护而言,故障发生之前一段时间的振动趋势与停机事件之间的对应关系,比一份去掉时间信息的汇总表更有价值。将工业数据接口交给AI使用之前,建立清晰的元数据和版本机制,通常可以同时改善传统报表和模型训练的质量。
商业机会出现在专业数据建模和应用交付之间
Emerson与Databricks分别积累了工业现场连接能力和企业级数据与AI平台能力,合作使行业客户能够在既有系统基础上扩展分析环境。对本地软件厂商和行业服务商而言,机会更多集中于资产模型、现场语义、设备机理与具体应用。泵阀、机床、钢铁、化工和半导体工厂对设备健康、质量、能耗与工艺优化的分析方式不同,业务模型需要与现场设备参数和工艺流程相结合。工业数据平台提供通用接口,行业应用提供可量化的决策价值,双方可以在一个项目中分工协作。
企业内部的数据治理工作也将越来越像工程产品开发。设备模型需要版本、数据接口需要测试、生产环境需要监控,智能体调用要记录状态、权限和结果;一次设备改造之后,数据模型随之更新,历史分析可以用同一资产标识继续关联。对于具有几十年服务周期的工业装备,跨越设计、生产、交付与运维的数据贯通会积累很大的长期价值。11月19日的这项合作表明,工业AI市场正在形成从OT数据连接到语义治理、再到数据分析和Agent应用的分层结构。它能让工程师把更多注意力放在设备机理、工艺规则和客户问题上,数据系统承担跨系统组织和可靠传递信息的工作。
在实际交付中,数据平台项目可以按照设备资产清单逐步建立覆盖范围。先选一条产线或一个关键设备群,核对设备号、点位、时间戳、运行单位与异常事件,再接入维修工单和生产批次;下一步将这些数据交给时序模型、机理算法或工业智能体做专项分析。这样能够在试点阶段直接形成完整的数据质量报告和工程验证记录,为跨产线推广提供基础。软件供应商也可将行业语义模板、接入测试脚本和智能体调用接口做成标准组件,减少每个项目从零定义标签的时间。
参考文献
- Emerson,2026-11-19,Emerson and Databricks Collaborate to Bring Industrial and Enterprise AI Together:https://www.prnewswire.com/news-releases/emerson-and-databricks-collaborate-to-bring-industrial-and-enterprise-ai-together-302942422.html
- Emerson / AspenTech Inmation,工业OT数据织物产品及应用背景,以11月19日合作公告为核验依据。