几百页文档,不能只看识字率
OCR听起来像一项已经很成熟的技术。扫描一张合同、识别几段文字,今天大多数软件都能做到。企业要处理的文档往往长达几十页、几百页,甚至上千页。招股说明书、技术手册、法律合同、设计规范、审计报告、采购文件、实验记录,通常包含复杂表格、跨页公式、章节层级和大量引用关系。10月27日,百度开源Unlimited OCR 2,并同步推出MarathonDocBench,重点瞄准的正是这个过去容易被忽略的问题:长文档解析。
512 Token引用预算与跨页结构
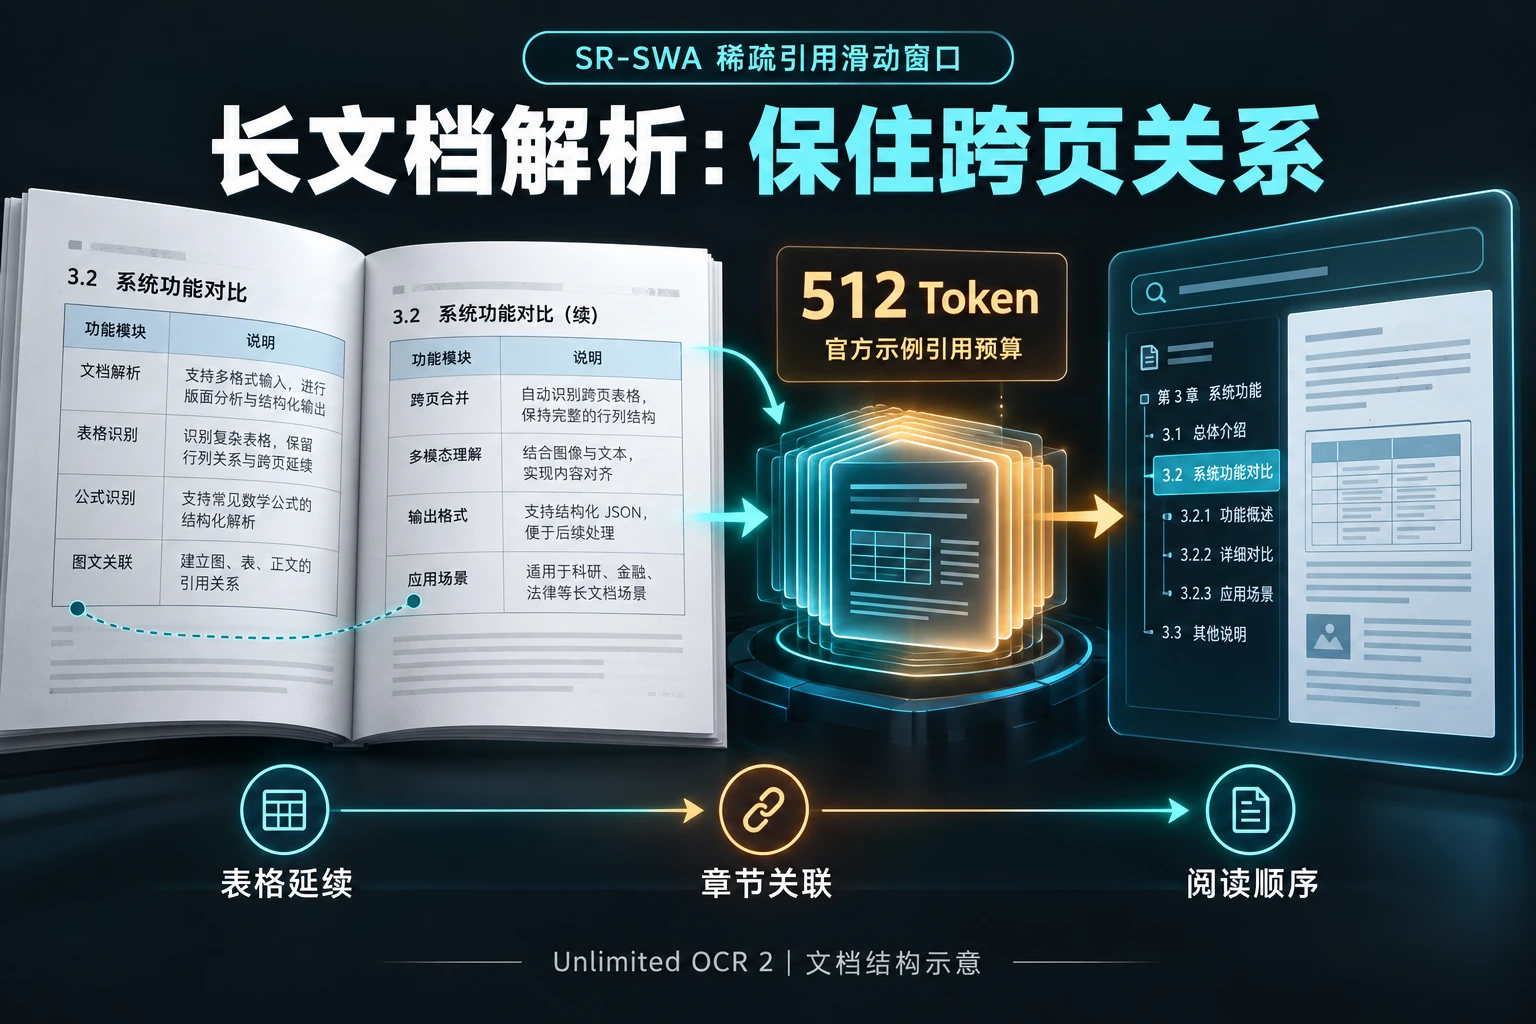
Unlimited OCR 2采用Sparse Reference Sliding Window Attention,也就是稀疏引用滑动窗口注意力。简单理解,它不会把前面所有页面的全部信息都长期放在上下文里,而是把关键历史信息压缩成一个固定规模的“引用集合”。官方示例使用512个Token作为引用预算。这样做的目的,是让模型在文档越来越长时,不至于每处理一页都重新携带全部历史内容,从而控制显存和计算成本。这个思路非常接近人类阅读长文档的方式:我们不会记住前100页的每一个词,但会保留章节结构、关键变量和重要结论。
长文档OCR难在恢复结构。普通OCR可以识别“这行是什么字”,但企业应用关心的是“这段属于哪个章节”“这个表格是不是接着上一页”“这个公式里的符号在前面怎么定义”“这个脚注引用的是哪一条”。如果这些结构丢失,后续知识库和大模型问答就很容易出错。比如一份300页设备手册,某张表格跨三页,如果系统逐页切开,第三页可能只剩数字,没有表头。模型虽然识别出内容,却无法知道这些数字代表什么。
Unlimited OCR 2试图在图像理解和跨页上下文之间建立更紧密联系。它处理文字,也恢复表格、公式和阅读顺序,并支持跨页联合解析。企业知识库尤其需要保住这些结构。一些RAG项目在进入检索环节前,文档预处理已经破坏了原有结构。PDF被切成一堆纯文本后,标题、表格、图片和脚注全部丢失,模型拿到的是碎片化信息,自然很难回答复杂问题。
让企业知识库保住文档关系
从工程角度看,OCR系统正在从“字符识别模型”变成“文档理解基础设施”。一个成熟的企业文档平台,至少需要完成四层工作:第一层是图像和文字识别;第二层是版面分析,判断标题、正文、表格、图片和公式;第三层是跨页结构恢复;第四层是语义索引,把章节和对象关联到知识库。Unlimited OCR 2主要在前面三层推进,特别是长文档上下文管理。
这种能力在工业场景尤其有价值。制造企业积累了大量PDF手册、设备说明、SOP、检验规范和历史报告。很多文件存在十几年,格式复杂,甚至是扫描件。如果能够高质量解析这些资料,就可以构建更可靠的本地知识库。一个维修Agent查询“某型号泵在高温环境下允许的振动上限”,系统需要定位正确版本手册、找到相关章节、识别表格,再结合设备型号回答。任何一步解析错误,都可能导致错误建议。
法律和金融场景同样如此。合同里一个定义可能在第5页,约束条款出现在第80页,附件又在第150页。如果模型只看局部上下文,很容易把定义和条款拆开。长文档解析能力提升后,系统可以更完整地保留引用关系,这对于尽调、审计和合规非常重要。
本地部署与运行成本
Unlimited OCR 2以开源方式发布,也关系到企业能否本地部署。企业在处理敏感文件时,经常不愿意把资料发送给外部云服务,尤其是制造图纸、法律合同和医疗记录。MIT许可证意味着团队可以在本地部署和二次开发。对于私有化知识库,这是很实际的优势。百度还提供Transformers和SGLang推理路径,说明项目不仅面向研究,也考虑了工程部署。
不过,长文档解析的成本仍然存在。SR-SWA解决的是“每一步需要记住多少历史信息”的问题,并不会让几百页文档瞬间完成处理。每一页图像依然需要视觉编码,所以总运行时间会随页数增长。企业选型时,不能只看单页准确率,还要看每百页处理时间、显存占用、跨页表格恢复率和失败重试成本。
评测要看整份文档
MarathonDocBench则把长文档解析带进评测视野。OCR评测过去偏向单页文字准确率,长文档场景缺少统一Benchmark。新的测试集如果能够覆盖跨页表格、目录、公式和引用关系,就会推动行业从“识字”走向“理解文档”。未来文档模型的竞争指标可能包括:100页文档能否保持结构一致、表格跨页恢复准确率、章节引用正确率、长文档处理吞吐和成本。
文档智能面向的是企业大量存量资料。几乎所有企业都有大量非结构化文档,而这些文档正是Agent最需要的知识来源。过去知识库项目常常把重点放在向量数据库和大模型,现在越来越多团队意识到,前面的文档解析才是决定效果的关键。对这类项目,解析质量提高1%可能比更换大模型更有价值。
Unlimited OCR 2让“文档基础设施”在企业AI里的位置更加清晰。未来知识库不会只是把PDF上传进去,而是会先进行版面恢复、版本识别、跨页关联和结构化解析。对于制造、金融、法律和科研企业来说,谁能把几十年的文档资产转成可检索、可验证的知识,谁就更容易把AI从聊天工具变成生产工具。