从画面连续到行动反馈
Google DeepMind在10月27日发布Genie 4之后,世界模型这个已经热了两三年的概念,又向前走了一步。过去人们提到世界模型,容易想到两个方向:一类是给机器人训练的模拟器,另一类是把一段文字变成连续视频的生成模型。Genie 4的不同之处,是它开始把画面、声音、人物对话、用户实时输入和智能体行动放到同一个持续生成环境里。用户能观看模型生成的世界,也可以通过键盘改变视角和移动,用自然语言修改天气、加入物体,甚至让场景中的人物随着情境产生对话。Google还把Gemini 3.8 Flash接进运行流程,让它观察环境、拆解目标并追踪任务完成状态。单看功能列表,Genie 4已经不像传统视频模型,更像一个可以边生成边运行的动态空间。
视频生成与世界模型之间,有一道明确的分界线。普通视频模型的任务是“生成一段看起来合理的画面”,它只要在视觉上连续就可以;世界模型则需要处理“行动之后会发生什么”。如果用户向前走,场景要继续扩展;如果打开一扇门,门后的空间要和之前世界保持一致;如果场景里有角色,角色的声音、位置和行为要随着事件变化。这要求模型不仅生成像素,还要在某种内部表示中维持空间、对象和因果关系。Genie 4目前仍会出现长时间运行后的物体漂移和空间错误,但它已经把交互式世界生成从研究演示推到了更接近可用产品的阶段。
世界状态才是难题
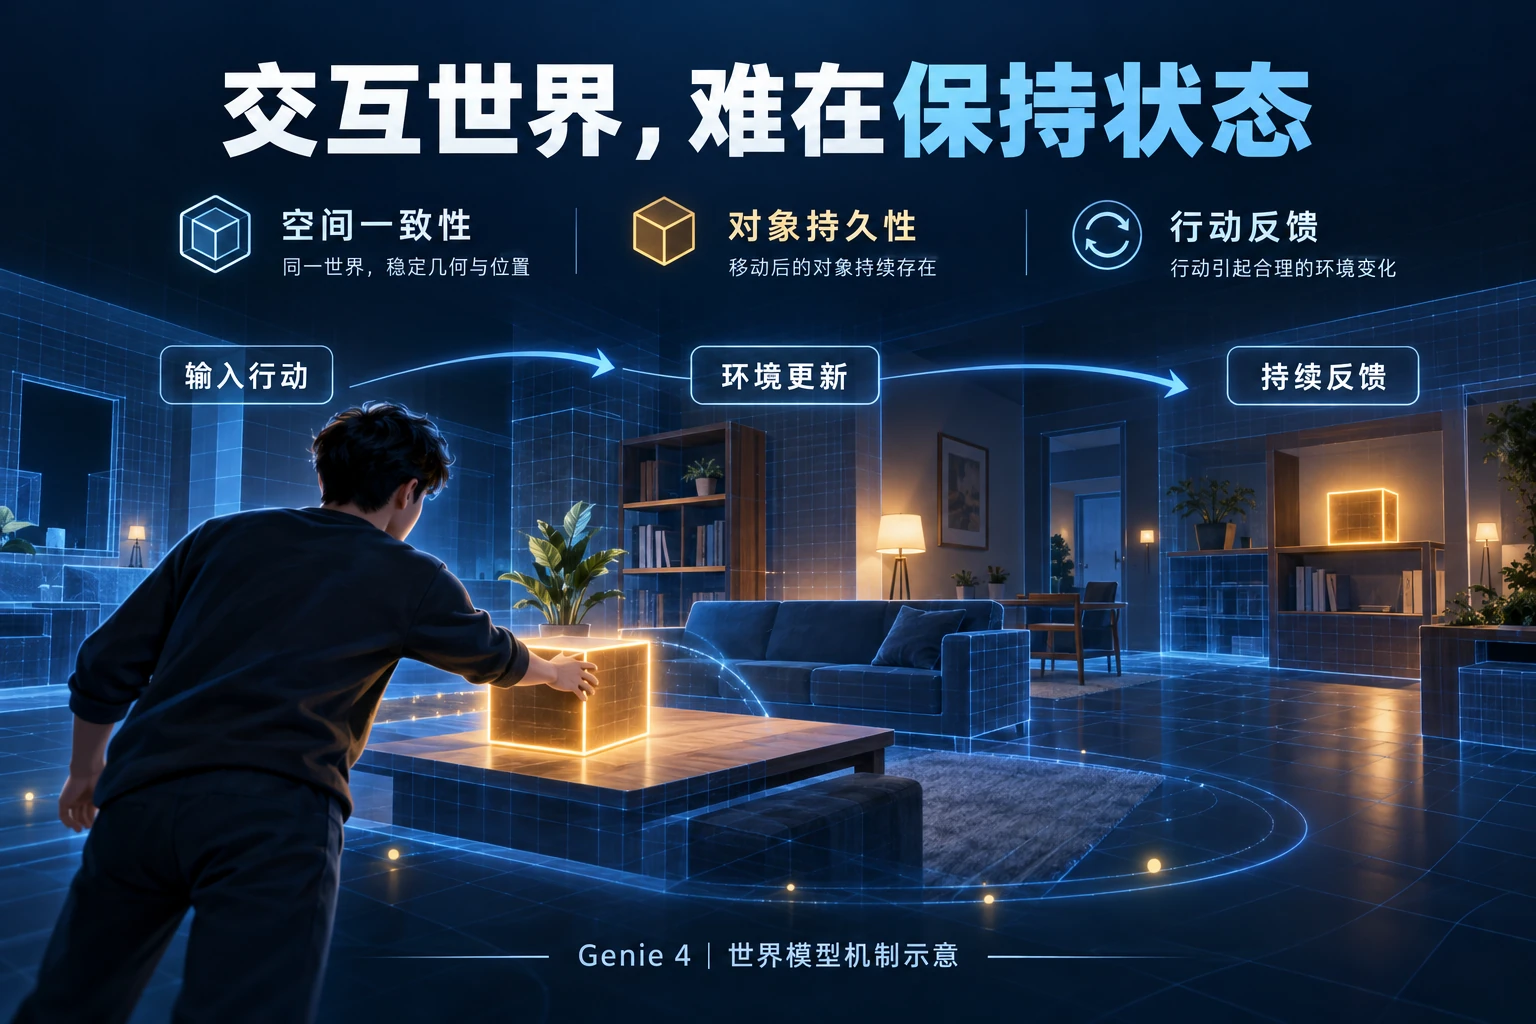
世界模型最难的是保持状态,画面漂亮还不够。传统图像生成模型只需要生成当前帧,视频模型也可以通过局部时间相关性维持几秒连续性,但可交互环境必须知道几分钟前发生了什么。一个箱子被移动到墙角,十分钟后用户再回来,它最好还在墙角;一个人物被告知某件事,后续对话应该记得这一设定。世界模型需要同时解决空间一致性、时间一致性、对象持久性和行为反馈。这个问题非常接近机器人中的“状态估计”,也接近游戏引擎里的“世界状态”,区别在于Genie 4试图让这些状态由生成模型动态维护,而不是全部由人工编写规则。
智能体训练需要新环境
Google把Gemini接入Genie 4,正是为了处理行动与目标。世界模型负责生成环境,语言模型负责理解目标、拆分任务和决定下一步行动,两者组合后更像一个“Agent在虚拟世界里生活”的系统。这给智能体训练提供了新思路。今天很多Agent评测依赖网页、桌面软件或固定游戏环境,场景数量有限,很容易出现模型“背题”。如果世界模型能够不断生成新环境,就可以动态制造更丰富的测试。比如,训练一个导航Agent时,系统可以自动生成不同城市、天气和障碍;训练服务机器人时,可以生成不同房间布局和物体组合;训练客服或教育Agent时,可以生成带角色和语音的情境互动。过去需要工程师手工制作大量模拟场景,未来可能由世界模型批量完成。
游戏和内容产业也可以用Genie 4做原型。游戏开发成本高,主要原因之一是大量场景、关卡和素材需要人工制作。世界模型如果可以快速生成一个可探索空间,就能把“概念验证”成本大幅压低。一个设计师可以先用自然语言生成一个科幻城市,快速测试玩法,再决定哪些区域值得正式建模。影视行业也可以用类似方法做预演,把镜头、光照、场景动作和角色位置提前模拟出来。它不一定直接替代Unity、Unreal或Maya,但可以成为前期创意和交互原型的重要工具。
教育和科研同样需要这种能力。很多教学内容依赖“情境”。历史课可以让学生进入某个时代的城市,地理课可以生成不同气候条件下的地貌,工程培训可以模拟危险作业环境。世界模型与传统VR最大的区别,在于场景不必提前全部制作,系统可以根据用户问题实时调整。这种能力一旦稳定,教育软件会从“固定内容”走向“生成式环境”。
原型工具与高精度仿真的边界
Genie 4离高精度物理仿真还有距离。工业设计、机器人控制和安全训练要求高精度物理规律,视觉上“像真的”远远不够。一个机器人抓取训练环境,如果摩擦系数、质量、碰撞反馈不准确,训练出来的策略很可能无法迁移到现实。因此,世界模型短期内更适合做感知、交互、规划和内容层面的模拟,而不是替代高精度CAE或机器人动力学引擎。更现实的路线,是把生成式世界模型与传统物理仿真结合:前者负责快速生成环境和场景变化,后者负责关键物理过程。
世界模型还可能改变训练数据的形态。过去AI训练依赖文本、图像和视频,未来可能越来越多使用“可行动的数据”。这类数据不只是记录画面,而是包含“动作—环境变化—反馈”的完整序列。对于机器人、自动驾驶和智能体,这种数据比静态视频更有价值。谁拥有更大规模、更高质量的交互数据,谁就可能在世界模型竞争中占据优势。
仍处研究预览阶段
Google目前仅向可信测试者提供Genie 4研究预览,面向Ultra用户和API开发者的开放仍在规划中。它尚未进入大规模商业化阶段;从这次预览来看,世界模型正在成为继大语言模型之后的另一条主线。过去AI理解世界主要靠阅读文本和观看视频,下一阶段则要通过“行动”学习世界。
Genie 4值得关注的,是它把“可交互环境”推向基础模型能力。当模型能够生成世界、理解世界并在其中行动,AI产品的形态会发生很大变化。未来的智能体可能拥有自己的工作环境、模拟空间和长期任务世界。到那时,世界模型就不再只是游戏技术,而会成为Agent、机器人和具身智能的一块核心基础设施。