工业智能前沿技术深度解读|2026年10月26日
官方发布:NVIDIA Isaac Lab v3.0.0,2026年10月20日(GA)
关键词:机器人学习、Isaac Lab、Newton、PhysX、Warp、柔性体、多后端仿真、Sim-to-Real
摘要
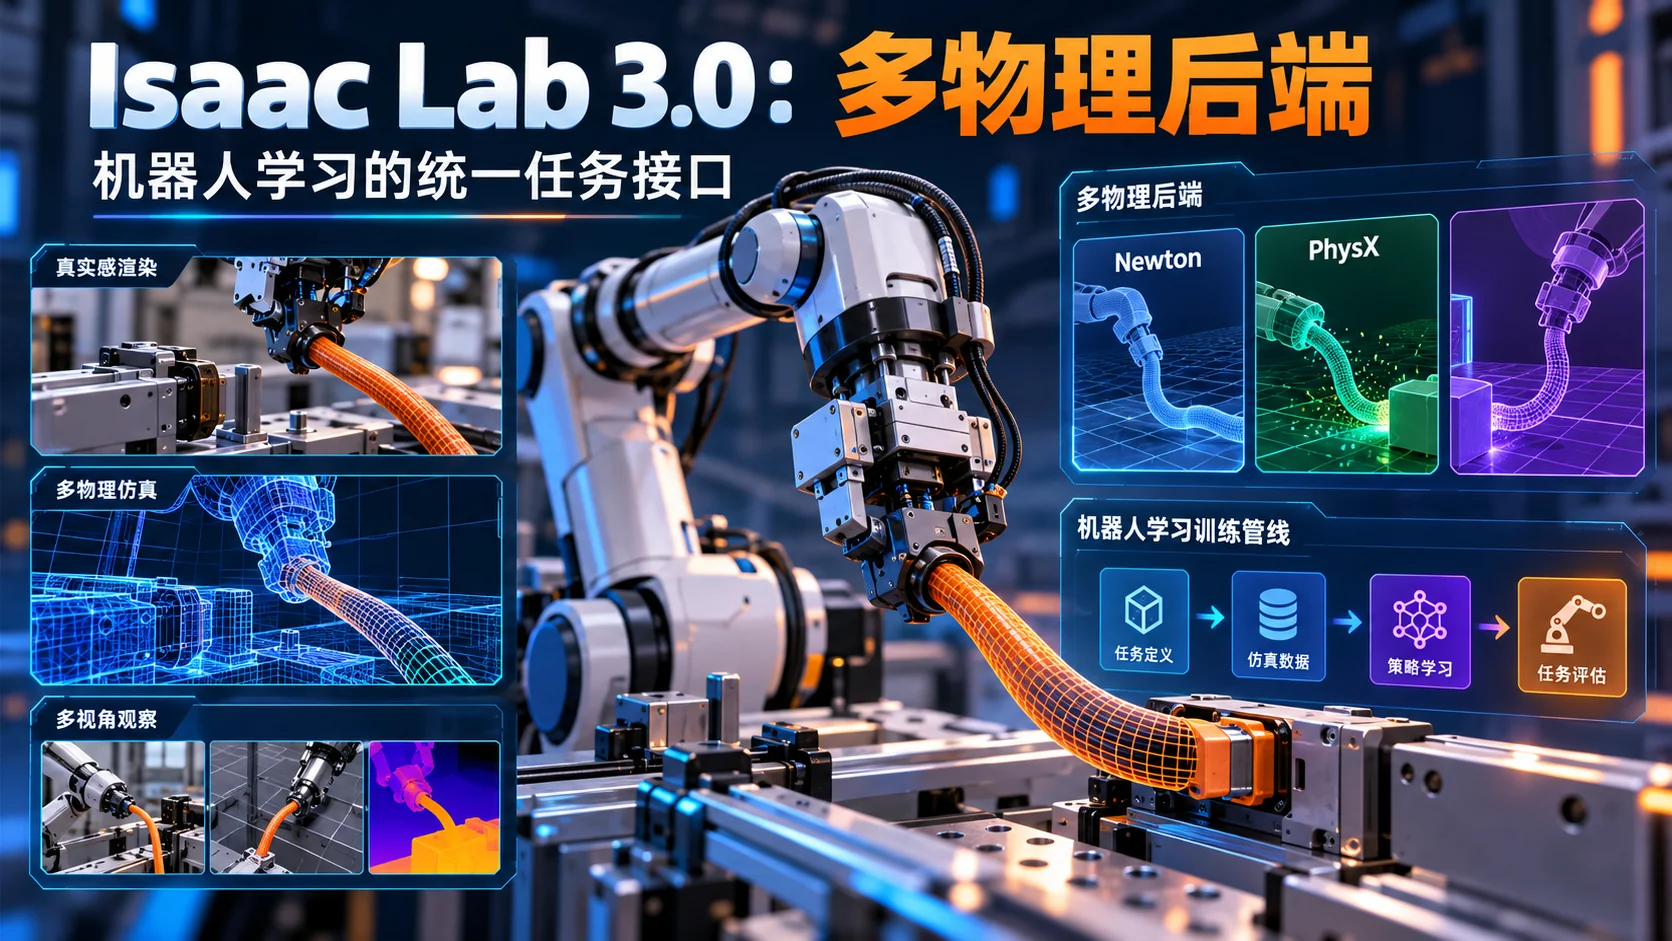
机器人进入工厂前,要在不同接触条件、柔性材料、视觉场景和夹具几何下反复训练、验证。仿真平台若绑定单一物理引擎和完整可视化运行时,更换求解器或在轻量节点上并行运行时,就要处理环境迁移与数据复制。NVIDIA在2026年10月20日发布Isaac Lab 3.0正式版,提出统一的任务、资产、传感器和场景接口,并支持Newton、独立OV PhysX/RTX以及完整Isaac Sim等不同组合。版本还扩大了Warp原生数据通道、柔性体和粒子能力,并统一了训练、评估与策略导出流程。物理仿真、渲染、可视化和训练工具可以分开配置;切换后端时,仍需检查任务兼容性和物理结果。
一、不同仿真任务需要不同运行配置
在工业机器人项目中,仿真至少承担四种不同工作。机械工程师用它检查轨迹、夹具和干涉;视觉团队生成相机图像与深度数据;控制算法团队验证抓取、装配和接触策略;强化学习团队则要求成百上千个环境并行训练。前三类往往关注几何完整性、交互和高品质呈现,最后一类尤其看重单秒物理步数、GPU带宽与状态同步成本。如果所有任务必须绑定相同的图形运行时,部署大规模训练集群就会为不需要的渲染和GUI组件付出额外开销。
工业场景还存在不同物理问题之间的选择困难。刚体堆垛、机械臂关节控制、线缆弯曲、颗粒堆积和液体倾倒都可归入机器人操作,却涉及接触求解、有限变形、粒子动力学等不同数学近似。一个对刚体操作高度优化的引擎未必是柔性线缆的最佳选择;高精度渲染也未必需要与训练物理过程运行在同一进程。可按任务选择求解器,按研发阶段选择渲染方式,同时尽量保持任务接口稳定。
Isaac Lab以往广泛依赖Isaac Sim平台和Omniverse Kit运行时。完整平台在USD资产、可视化、仿真扩展和ROS桥接等方面能力丰富,但安装组合较重。3.0版本不再把完整Kit环境视为所有流程的必需组件,许多工作流可以选择独立物理与可视化模块执行。后台训练服务器、工程师终端和数字孪生服务因此可以采用不同配置,不必一律加载完整Kit。
二、任务API之下,物理与渲染后端分开选
官方v3.0.0发布说明强调工厂模式(factory-based)的多后端架构:资产、场景、传感器、机器人环境使用相对统一的上层任务API,再由指定后端实现对应的物理和观测操作。开发者可以从Newton-MuJoCo-Warp路径切换到OV PhysX或Isaac Sim PhysX路径,并分别选择Newton渲染、OV RTX或Isaac Sim RTX,以及Newton GL、Viser、Rerun或Kit等可视化方式。切换所需的配置比过去显式,也更有利于编写重复运行的基准。
Newton属于Warp原生物理框架,正式版列出MuJoCo-Warp、基于顶点块动力学的VBD、物质点法MPM及刚柔耦合等路径。OV库则以独立组件形式提供PhysX与RTX能力。与此同时,完整Isaac Sim仍承担ROS桥接、XR、直播、Kit扩展和高整合度资产处理等工作。三种路径对应不同的任务组合。一个没有相机的抓取动作训练可以走轻量物理路线,复杂场景的多相机合成数据却可能仍要启用更完整的渲染工具链。
官方给出的配置选择示例中,physics=newton_mjwarp代表Newton的MuJoCo-Warp路径,physics=ovphysx对应独立PhysX库,physics=isaacsim_physx则通过Isaac Sim运行。开发者还可以用list_envs --show_presets检查环境预设支持情况。统一任务API不意味着所有物理后端、传感器、材质和场景组合都受支持。特殊接触模型或柔性求解器切换后,输出轨迹可能不同,不能以同一脚本成功运行代替动力学等价性证明。
三、Warp数据路径减少状态转换开销
机器人训练的瓶颈不只发生在物理求解器。每个控制步都可能读取上千个环境的关节位置、速度、接触力和相机观测,计算奖励及终止状态,再写入动作。若状态在求解器、CPU数组、PyTorch张量和Python对象之间反复转换,即便单步物理计算足够快,框架调用开销也会吞掉并行收益。3.0引入更明确的ProxyArray访问路径,允许从同一资产数据获得Warp或PyTorch视图,通过融合GPU内核、懒初始化与缓存视图降低不必要的数据搬运。
官方示例使用类似robot.data.joint_pos.torch和robot.data.joint_pos.warp的接口,迫使开发者明确数据进入哪一类计算体系。这样可以分别安排计算:强化学习代码可以继续使用PyTorch组织策略网络,碰撞查询与传感器操作可尽量留在Warp计算路径,减少两个体系之间的内存往返。特别是接触丰富的大批量场景,若每个时间步都从GPU回传CPU计算奖励,再传回GPU更新状态,性能损失可能超过训练网络本身的开销。
零拷贝仍受设备与数据格式限制。跨GPU、进程隔离、不同张量布局和依赖CPU的扩展仍可能发生复制与同步;记录轨迹、可视化和调试时也存在额外数据出口。生产环境应分别测量物理步时间、传感时间、奖励计算、策略推理、GPU显存和CPU占用,避免把框架整体吞吐增长笼统归因于一个数据接口。
四、柔性线缆、颗粒和流体把工业操作问题推向多物理
3.0版本展示了基于VBD的线缆插接、基于MPM的流体倾倒,以及刚柔耦合等场景。接插件、线束、软包装、软管、密封件和粉粒料等工件,对仅处理刚体搬运的仿真构成不同要求。对一根线缆而言,抓取点、弯曲刚度、扭转、与夹具的多点接触都影响最终插接;只用一条几何曲线或多个刚体铰链模拟,可能无法保留关键形变。对于颗粒和液体,接触数量、流变性质和环境边界会决定训练策略是否存在系统性的仿真偏差。
多物理模块提供了建模入口,材料行为仍需按任务标定。线缆护套的粘弹性、接插件摩擦、液体表面张力、真实颗粒的非球形状以及电缆内部导体结构都需要特定参数标定。应先明确任务成功最敏感的物理量,再选择求解器和合理的简化。如果目标只是学习柔性物料的大致引导动作,快速近似模型可能足够;若目标是验证接插件的压接峰值、磨损或耐久,则需要专门力学测试与更细粒度求解。
一个现实的产线试点可从柔性线束的定位与插接开始。先采集线束规格、夹持位置、插座几何、机器人控制周期及失败样本;建立刚体机械臂与柔性线束组合模型;在已知插入力—位移曲线和变形实验上校准仿真;随后通过域随机化覆盖线缆长度、初始弯曲、摩擦与视觉误差。策略通过训练后,必须经过仿真外模型测试、实物离线工站验证以及人机安全评审,才能进入连续运行。试点应事先确定插接成功率、作用力和失败条件等验收指标。
五、官方正式版的依赖组合与迁移风险
升级前先核对依赖组合。v3.0.0正式发布页的概览列出Isaac Sim 6.2、Python 3.12、PyTorch 2.11、CUDA 13.0、NVIDIA Warp 1.17与Newton 1.6.1;部分迁移段落沿用了Isaac Sim 6.1的文字,与概览并不完全一致。因此正式部署时需要以目标发布标签对应的安装矩阵、锁定依赖和容器清单为准,不能混用3.0早期预览版与正式版的组合,也不宜只凭一处文档断言全部环境均支持。NVIDIA还提供3.0.0容器,在离线及企业受控网络中仍应核实镜像许可、GPU驱动、CUDA能力与部署基础镜像。
四元数顺序变化可能导致难以察觉的姿态错误。Isaac Lab 2.x常用WXYZ,3.0统一为XYZW,单位姿态由(1,0,0,0)变为(0,0,0,1)。如果历史项目中某些目标姿态、重置配置、传感器数据转换和控制器参数仍按旧顺序存储,程序可能正常运行,机器人却执行错误方向的运动。资产数据也不再直接作为Torch张量返回,必须明确.torch或.warp的访问语义;部分写入接口则区分索引和掩码。对于在多个项目中复用的机器人库,Isaac Lab 3.0的这两类变更都应纳入回归测试。
迁移建议采用并行分支而非原地升级。第一步固定现有环境、依赖哈希与策略评测结果;第二步在全新Python 3.12环境中安装3.0正式版;第三步使用小规模任务检查观测维度、姿态变换、随机种子和重置逻辑;第四步对同一策略在旧新仿真环境中比较轨迹、奖励与终止条件;第五步验证运行时间、显存和GPU利用率。只有这些指标进入预先设定的容差范围,才可以将迁移视为成功。
六、面向工业AI中试平台的部署架构
对于工业AI创新中心或机器人中试平台,多后端架构可以形成三层相对独立的服务。第一层是工程数据与资产管理,保存CAD/URDF/USD资产、材料参数、传感器标定、夹具及工艺要求;第二层是仿真计算服务,根据任务标签选择刚体、柔性体或粒子求解后端,并在GPU节点上开展批量运行;第三层是任务、策略与验证服务,管理训练实验、离线测试、策略版本及真实机器人放行审批。三层通过明确的数据模型和作业接口协同,避免某个物理引擎版本直接渗透到全部业务系统。
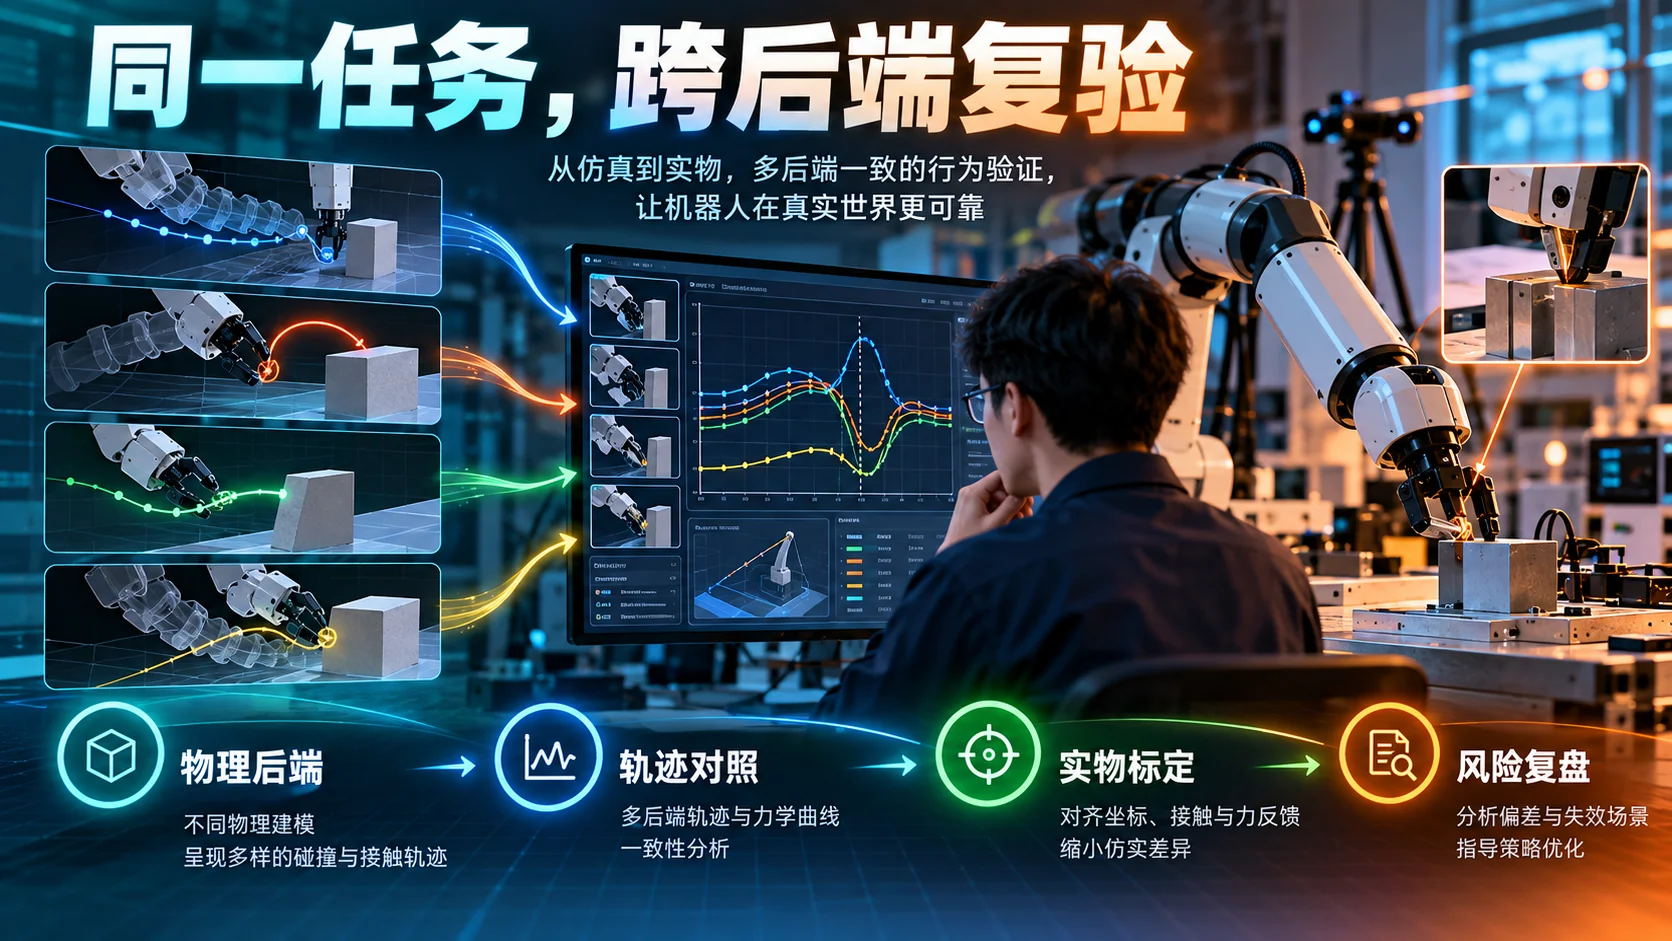
在产品设计中,可将策略验证流程划为“训练仿真—跨后端复验—真实硬件在环—现场试运行”四个阶段。跨后端复验可以暴露物理差异:同一策略在Newton和PhysX条件下性能明显下降时,往往意味着某些接触规律、控制误差或仿真时间步已经被策略过度利用。这个差异本身是值得保留的风险信号,而非必须通过调整评分口径抹平的噪声。对企业客户,平台应提供可重放的失败轨迹、随机化范围、仿真可信度报告及人工签审记录,而不仅是一段机器人完成动作的视频。
3.0还整合多个强化学习库、遥操作数据、示范生成和策略导出功能,可在同一流程中管理研究、验证与部署。但多库并存需要明确数据记录标准,包括观测时间戳、动作频率、控制器单位、物理步长、坐标系、奖励定义与安全停止条件。不同框架即使导出相同网络权重,也可能因预处理或时间对齐差异表现不同。对此建立统一的策略包元数据,比追逐某一轮训练吞吐纪录更能提升企业交付质量。
七、如何建立客观的后端比较方法
后端选型时,推荐建立针对同一工件、同一控制周期和同一物理扰动的双重评价。一类评价面向计算资源,统计每秒仿真步数、同时容纳的环境数量、GPU峰值显存、初始化耗时和并行增益;另一类面向物理真实性,比较相同接触事件中的运动轨迹、最大法向力、静摩擦起滑阈值、柔性体挠度与实测操作成功率。若只看并行吞吐,某个后端可能在简化碰撞或低精度材料参数下表现更快,却无法满足精密装配的预测要求。选型时应优先使用经过物理标定的对照数据。
还应考虑硬件受限的工厂运维环境。训练阶段可以使用多块高端GPU,而现场回放或小规模策略验证可能只配一块工作站显卡;资产加载、场景初始化、依赖体积和驱动维护都会影响可运营性。工程中可以把高性能训练、常规仿真验证和现场诊断分成不同镜像或部署配置,保持任务配置与测试报告格式一致。借助这种分层,企业能够把算法升级与产线验证解耦,同时在出现新版本兼容问题时快速回退到上一套已签审的仿真环境。
八、后端可替换之后,还要验证物理结果
Isaac Lab 3.0提供了更清楚的任务接口、物理引擎边界和数据处理通道。它有利于把计算密集型训练部署到轻量节点,把高保真场景验证保留在完整平台,并为未来不断出现的新求解器提供接入空间。对柔性插接、颗粒处理和接触丰富装配等任务,这种灵活性可能显著降低原型探索成本。
通用接口不会消除物理模型偏差。企业迁移到GA版本时,还需做模型标定、跨后端对照和实际工装试验,保留部署审批记录。选型从目标工序、精度要求和硬件约束入手,再决定是否采用Isaac Lab 3.0。
参考资料
- NVIDIA Isaac Lab v3.0.0官方发布说明,2026年10月20日。https://github.com/isaac-sim/IsaacLab/releases/tag/v3.0.0
- Isaac Lab源代码与版本迁移入口。https://github.com/isaac-sim/IsaacLab
- NVIDIA Isaac Lab 3.0.0容器信息。https://catalog.ngc.nvidia.com/orgs/nvidia/-/containers/isaac-lab/3.0.0
- NVIDIA 2026年10月21日Isaac平台发布。https://nvidianews.nvidia.com/news/nvidia-advances-isaac-platform-for-general-purpose-robotics-with-new-reference-humanoid-frameworks-simulation-pipelines-and-data
版本说明:发布页概览与部分迁移段落的Isaac Sim版本文字不一致,部署时应按正式标签对应安装矩阵锁定、实测依赖。