工业智能前沿技术深度解读|2026年10月26日
核心论文:A Process-Informed, Photorealistic Digital Twin for Vision-Based Inline Inspection of C-SMC Strip Deposition,arXiv:2610.28050,2026年10月20日
关键词:复合材料、碳纤维SMC、工业视觉、偏振成像、合成数据、数字孪生、过程质量
摘要
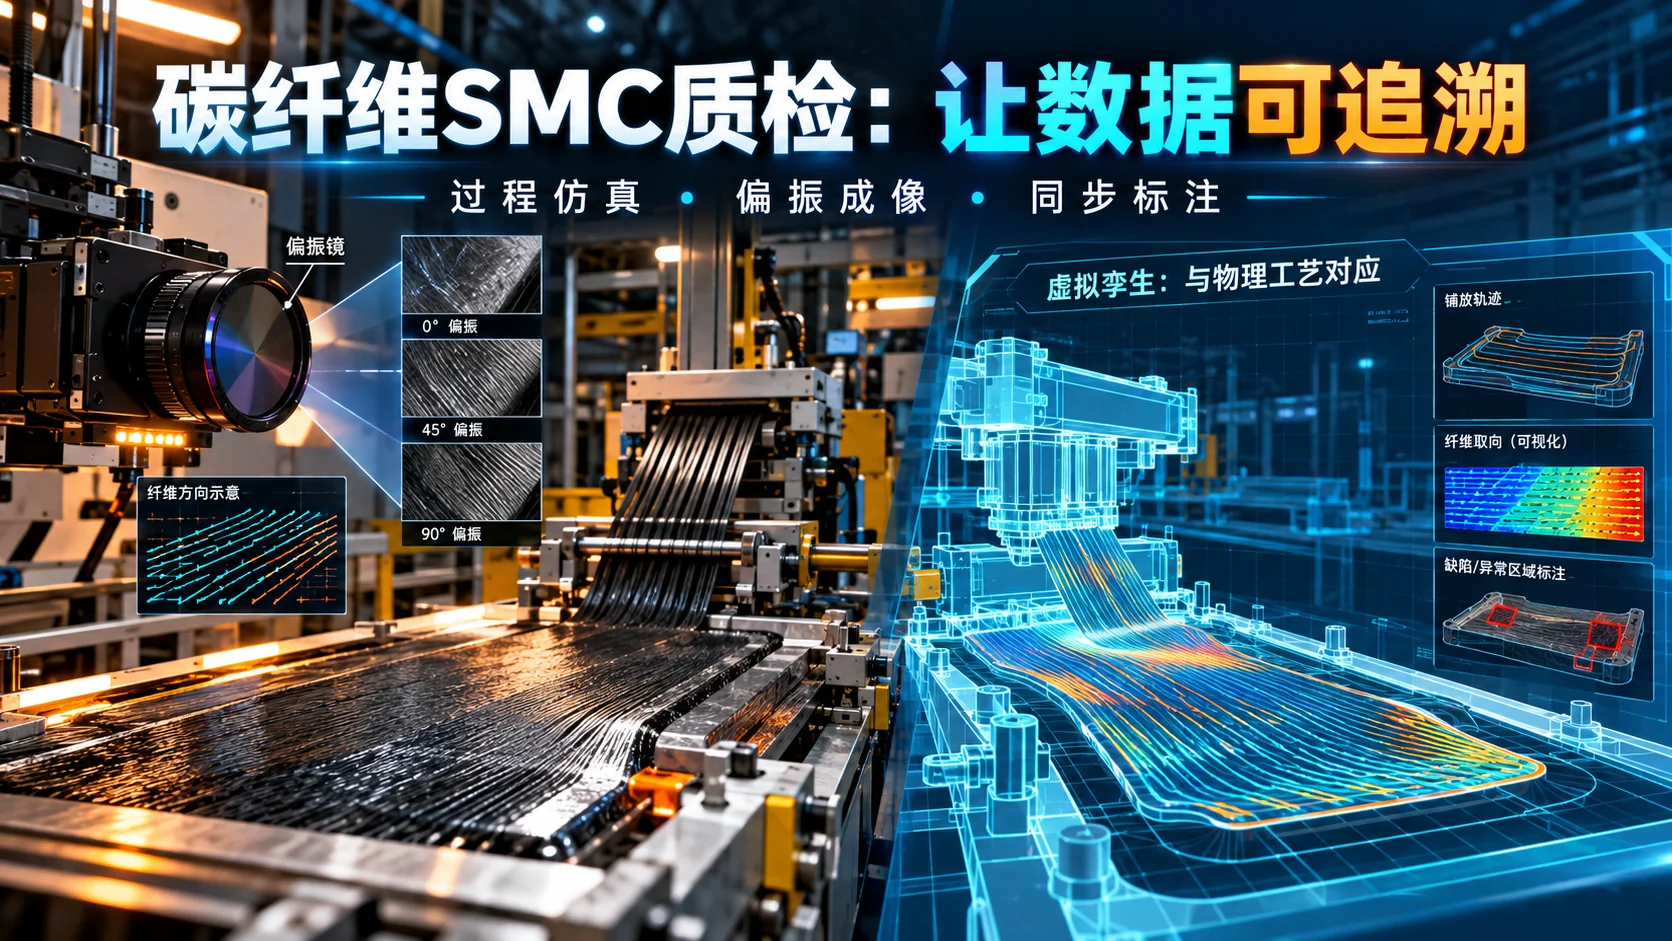
工业视觉项目常缺少可靠标签,换用更复杂的检测网络也很难补上这块数据。碳纤维片状模塑料(C-SMC)铺放是一个典型案例:数百乃至上千条纤维束相互叠盖,在传送带上形成具有方向分布与面密度的随机薄层,人为标注每根纤维束的真实位置和朝向几乎不可能。研究者提出一种过程驱动的光真实数字孪生,先用刚体动力学模拟沉积和传送,再通过物理相关的偏振渲染产生图像及同步标注。论文生成超过3300个测量帧、逾16000张图像,并让纯合成数据训练的YOLOv11在留出的合成图像上取得最高约0.91的mAP50。作者同时比较了合成图像与真实图像的外观差异。模型在合成验证集上的得分,仍需经过真实产线检验。
一、铺放现场为什么难做准确标注
片状模塑料由增强纤维与树脂体系构成,在生产中可能经历切断、随机沉积、浸渍、压制与后续成形。对于碳纤维SMC,纤维束的局部堆积密度和取向会影响材料的力学各向异性、填充均匀性和最终成形质量。质量人员既关心平均面密度,也关心某个区域是否过密、过疏或形成偏向带;这些特征常常在压制之前就已由铺放过程决定。
标注最难处理的是纤维束互相遮挡。普通RGB相机能看到表面纹理,却无法直观识别被遮挡的内部束条;人工把每条纤维画成一个有方向的边界框,本身就存在观察不完全与标注者差异。对密集铺放而言,图像计数也不能简单等价于真实落料数量,因为一条纤维束可能部分落在视野外,另一条被上层材料掩盖。如果训练集采用人工猜测的可见数量作为真值,检测网络所学到的只是标注规则,而未必对应材料真实的物理状态。
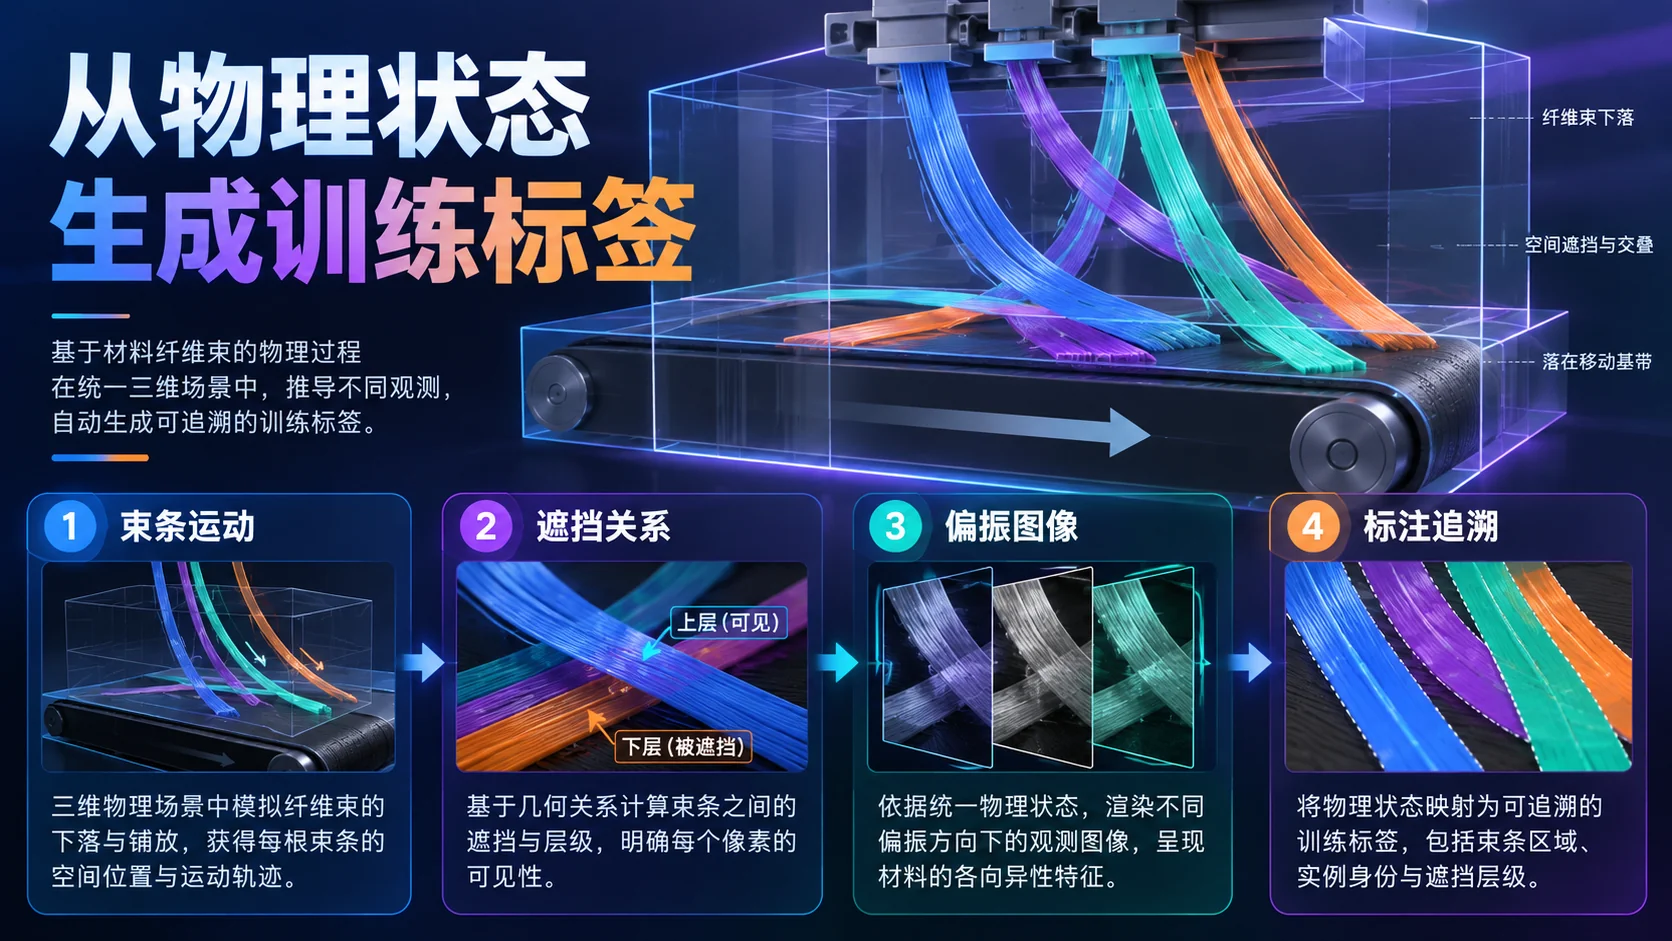
模拟器则能保留画面之外的信息。模拟器保存每根束条的几何尺寸、质心、运动轨迹、姿态、重叠层级和接触关系,图像即使出现遮挡,系统仍知道生成场景中的真实实例数量和方向。模型训练所需的检测框、旋转框、密度图与方向统计可以统一由同一个状态导出,使不同标签可以追溯到同一场景状态。类似方法也可用于散料分拣、金属屑检测、药片堆叠、纤维铺放和复合材料预成形。
二、数字孪生如何把生产过程转成训练图像
研究从铺放过程生成图像:纤维束如何下落、碰撞和随传送带移动,都有相应的场景状态。仿真从纤维束条的几何、投放初始状态和输送带运动出发,计算重力下落、碰撞、摩擦、落稳与物料被输送离开测量区域的过程。每个时间帧中,系统拥有全部束条的世界坐标和方向,因此可以精确计算视野内覆盖率、束条数量和方向分布。随机种子和过程参数可用于重演样本。
在视觉层,论文引入偏振成像模拟。偏振相机通过不同检偏角采集强度,再重建线偏振角(Angle of Linear Polarization,AoLP)与线偏振度(Degree of Linear Polarization,DoLP)。它比普通灰度图具有不同的信息维度,适合研究纤维方向、表面反射与材料纹理之间的关系。模拟中需要设定光源、材质、相机、背景及偏振参数,再把物理状态投射为不同检偏方向的图像;同时由确定性几何投影产生旋转边界框和像素级标签。无论后续训练目标是检测、计数还是方向估计,数据都共享同一份场景真值。
这套数字孪生主要用于生成监督标签;产线节拍和控制策略并非论文实验的重点。实际系统可以保留两条线:一条根据PLC、相机和工艺参数持续更新过程状态,另一条根据经过校准的过程模型离线生成大量训练场景。离线生成可定向补充极端密度、特殊光照与异常姿态样本,减少逐张现场采集和标注。
三、16000张图像背后的数据结构与计算成本
论文报告生成超过3300个测量帧,其中3145帧具备完整纤维束标注;每个测量帧包含四个检偏方向的渲染以及一个派生AoLP图像,因此逾16000是图像组件数量,不代表逾16000个相互独立的物理过程场景。划分训练集时要区分帧和图像组件:同一场景的多种偏振图像高度相关,同一次模拟中相邻帧的物料构型也具有时间连续性,若随机按图像打散训练与验证,极容易把同一个物理场景的信息泄漏到两边。
数据生成平台采用Blender 4.0和Cycles渲染器,图像分辨率为512×512;作者记录的计算配置为每个任务使用8个CPU核心、48 GB内存和一块NVIDIA V100 GPU。不同落料数量对应不同执行时间,1000条束条时约11秒产生一组测量帧的渲染与标注结果,2000条时约26秒;一轮33帧约需6—14分钟。这些时间不包括首次场景设置和刚体动力学预烘焙,不能简单乘以帧数理解为从空白开始的完整运行成本。
| 每轮束条数量 | 测量帧渲染与分析时间 | 33帧一轮耗时 |
|---|---|---|
| 1000 | 约11秒/帧 | 约6.0分钟 |
| 1250 | 约11秒/帧 | 约5.9分钟 |
| 1500 | 约14秒/帧 | 约7.5分钟 |
| 1750 | 约27秒/帧 | 约14.3分钟 |
| 2000 | 约26秒/帧 | 约13.7分钟 |
渲染时间随束条数量变化,前期还需要建模与校准。模型建立、工艺标定、材质参数获取和数据质量审核往往是前期主要投入;大量运行阶段则可以通过独立随机种子横向扩展到多个计算节点。企业计算ROI时,可以比较达到相同工况覆盖、标签一致性和稀有样本比例所需的总成本。
四、检测得分、过程统计与真实图像
论文针对束条检测训练了五种规模的YOLOv11,均训练100轮,使用576张合成图像训练、144张合成图像验证。随模型规模扩大,mAP50从0.883升至最高0.908,最大模型的precision为0.998、recall为0.822,mAP50–95为0.899。检测召回率没有同步达到接近1,部分原因是仿真真值包含严重遮挡的束条,单张图像中并非全部目标都可辨认。实验说明合成标签可用于训练和分析遮挡误差;真实车间能否达到90%以上准确率,仍待测量。
针对旋转检测框,作者还用YOLO11s-OBB进行了独立可训练性检验。实验按完整仿真轮次划分训练和验证,440帧训练、220帧验证,避免相邻帧泄漏;仅训练15轮便达到mAP50为0.83、mAP50–95为0.72,在每图最多300个输出检测的默认限制下,precision为0.97、recall为0.71。提高最大检测数量以适应密集场景后,recall可回升至0.80,mAP50约0.89。密集目标检测还受后处理输出上限影响,不能把漏检全归因于定位或定向能力。
作者还检验了合成数据的方向统计。论文通过纤维束角度分布和方向集中度进行定量说明,方向集中度约0.047,显示样本接近二维准各向同性,但卡方检验仍可发现沿输送方向的微弱偏向。论文把这一偏向与落料和传送过程联系起来。对复合材料而言,这种验证应与显微结构、取向张量及力学性能实测建立联系,才能判断图像数据的方向标签究竟对最终材料质量有多少预测价值。
合成图像与真实采集的差异也有量化结果。论文在真实图像之间建立参考距离:两次真实采集序列的梯度分布KS距离约0.41、重叠度0.57;合成与真实之间约0.46、重叠度0.56。这些距离与真实采集序列之间的差异相近,但还不能据此把合成图像当作真实图像使用。研究也报告了偏振平均强度约58%的系统性偏移、背景材质差别和参考轴校准问题。现场部署前,应针对这些偏移校准,并用真实标注与跨批次数据验证检测表现。
五、从合成图像到现场质量判定,还差哪些环节
落地质检系统时,相机标定、偏振坐标、工艺阶段和材料批次需要与质量目标一起记录。对于方向检测,先确认AoLP坐标系与物料物理方向之间的映射,建立传感器角度偏移校准;对于面密度,则需要把像素覆盖、纤维长度、截面质量以及材料堆积关系转换为可验证的工程量。仅依赖检测框计数很难计算三维堆积厚度,必要时应将称重、厚度、线速度和视觉信息融合。高覆盖率的遮挡区域还应有“不可观察”的标记,避免检测模型给出虚假的精确数值。
真实场景评价要按采集日、设备、材料批次和光照配置划分数据,并保留一个完全独立的生产测试集。推荐同时统计绝对计数误差、方向分布差异、稀疏与高密度工况下的检出率、漏检成本和单位时间误报率。如果系统用于闭环调节落料速度或束条分布,则还需测试控制动作的滞后、鲁棒性和误报时的退化策略。视觉模型可以先作为提示与预警层,工艺参数调整仍由明确的控制器和授权人员完成,直到积累足够的稳定运行证据。
合成数据平台还要记录素材和代码的授权。几何模型、真实物料纹理、工艺数据和相机参数可能分别受不同授权约束;研究论文的许可并不自动覆盖原始生产数据与可商用程序资产。企业部署时应记录输入物理参数、随机种子、渲染版本、输出标签哈希和数据许可来源,以便日后重演异常样本与管理训练数据血缘。特别是用少量真实照片标定渲染器时,必须管理样本采集授权和生产敏感信息。
六、工业视觉平台如何接入合成数据
常见视觉项目从现场采集和人工标注开始;设备、光照或材料一变,标注往往要重做。过程驱动合成路线增加了一个可控变量空间:传送速度、落料频率、束条长度、反光特性、相机位置、光源偏差和随机种子均可系统采样。在不违反物理合理性的前提下,仿真能够专门覆盖容易漏检的高密度遮挡、边缘堆积与异常叠放情形。这类数据对于训练鲁棒性和定位模型盲区的价值,可能比单纯增加正常样本数量更大。
面向企业软件,建议把过程仿真、渲染、自动标注、数据集版本和模型评测作为可组合服务,通过统一元数据规范共享生产对象。训练平台可以自动申请指定工况的数据任务,生成后将每批次的物理参数、标签统计、校验结果回传,随后与真实数据按比例混训或微调。部署系统再通过主动学习收集置信不足或与过程预期矛盾的画面,用真实样本对仿真参数进行反演更新。这样,真实采集结果还能反过来修正下一轮仿真参数。
在选取首批试点时,应优先选择物理过程较清楚、视觉标签难以人工精确取得、但真实质量指标可以通过离线试验建立基准的工序。碳纤维束条铺放符合这些条件,散料供料和某些复合材料层叠工序也可能适用。若生产过程高度依赖难建模的化学反应或微结构演化,则需要混合数据方法,而不能强行套用刚体粒子仿真。
七、先把场景状态与标签对齐
模拟器记录每条束条的位置和角度,遮挡不会让标签丢失。超过16000张图像和合成集上的YOLO结果,展示了这套标注流程的训练用途;真实产线仍需要校准和独立测试,不能照搬0.91的mAP50。下一步若能把真实厚度、纤维体积分数和成形性能接入评估,才更容易判断方向与密度标签对材料质量的实际用处。
参考资料
- Flore, P. 等,A Process-Informed, Photorealistic Digital Twin for Vision-Based Inline Inspection of C-SMC Strip Deposition,arXiv:2610.28050,2026。https://arxiv.org/abs/2610.28050
- arXiv HTML全文(数据生成、时间开销、YOLO验证及迁移差异)。https://arxiv.org/html/2610.28050
- Blender渲染与物理仿真文档。https://docs.blender.org/manual/en/latest/
- Ultralytics YOLO检测器与OBB说明。https://docs.ultralytics.com/tasks/obb/
说明:检测精度来自合成验证数据;产线集成方案为本文工程建议。