工程师接到一个设计任务,通常先要确认产品约束,再去寻找可重用的模型、图纸和试验记录。假设客户希望把一套机械传动机构装进更紧凑的壳体,设计人员会先读取已有装配关系,核对轴承位置、传动件尺寸以及加工工艺,随后更新三维模型,计算负载,安排仿真,最后把结果整理成可供评审的技术报告。这项工作跨越CAD、CAE、PLM、测试文件和项目协作系统。工程团队真正耗时的环节常常隐藏在这些文件和软件的切换之中:设计目标不断被重新描述,参数在几种工具之间反复录入,计算结果与版本对应不清,审阅意见又要靠人工重新汇总。随着能够操作软件的模型进步,这条复杂工作流出现了新的自动化入口。
OpenAI在2026年11月17日正式发布GPT-6.2 Astra和GPT-6.2 Sol。公司给Astra的定位是复杂专业项目,给Sol的定位是日常和高频任务。和此前发布大模型时主要展示对话、写作与编程能力不同,这次官方重点展示专业文档、电子表格、幻灯片、计算机操作、三维设计,以及通过编程工具开展模拟计算的完整过程。产品文章里出现了汽车底盘运动学模拟、发动机零部件装配、从建筑立面生成可制造模型等实例。对于工业软件从业者而言,这些例子值得仔细拆解,因为它们包含了复杂工程应用的几个连续步骤:理解图形与空间关系,生成可执行的设计和计算操作,读取软件反馈,再把结果重新呈现给专业人员。
从一个汽车底盘模拟看模型工作的变化
官方展示的一个任务是将山区公路上的车辆底盘动力学可视化。模型创建三维场景,编写Python求解程序处理轮胎和悬架的相互作用,再通过Blender制作动态呈现。这个案例展示了语言模型对编程、三维场景与数值计算工具的组合调用。底盘系统涉及轮胎与路面接触、悬架刚度、阻尼、载荷转移、转向和车体姿态,多种因素的耦合使工程师必须在模型假设与实际测试之间不断比对。程序能够生成运动结果之后,还需要确定所使用的力学方程、参数来源与求解边界,团队才可以把它作为设计方案讨论材料。
对一家机械装备企业,较容易形成生产力的路径是从标准化程度较高的计算任务开始。例如针对泵阀产品,让智能体读取客户工况和历史产品型号,依据压力、流量、介质与温度建立筛选条件,检索已有模型,生成候选配置,并把需要进一步计算的工况交给CFD或有限元软件。模型可以负责CAD参数化建模与求解任务的编排,求解器负责完成物理计算,工程师则针对极端工况和关键材料提出修订意见。这样形成的技术报告能够携带设计版本、仿真文件、边界条件及结果曲线,使后续订单有机会复用既有的工程工作。
成本变化让多步骤任务更容易进入预算表
GPT-6.2 Astra的标准API价格为每百万输入令牌8美元、缓存输入0.40美元、输出40美元,输入和输出单价较GPT-6 Astra降低20%。GPT-6.2 Sol延续上一代Sol每百万输入2美元、输出10美元的价格。在官方Agents’ Last Exam评测中,Astra比前代提高5.2分,厂商报告其对应任务成本不足前代的三分之一。在科学任务的Terminal-Bench-Science 0.1中,Astra较前代提高9个百分点,同样报告成本降至不到三分之一。这些数字来自OpenAI给出的评测配置,展示的方向是模型每完成一个专业任务所需的计算和输出更加节省。
企业采购AI服务时,按照令牌量算账容易忽略人工操作次数。一次设计变更可能包含20轮模型读图、10次数据库检索、数次求解任务、评审反馈与报告修订。若模型在中间需要反复重做,低廉的调用单价也无法自动转化为低工程成本。合理的业务计量单位应逐渐转向完成一项工艺卡修订、处理一个质量异常、生成一套投标技术方案或执行一轮有限元计算的综合成本。这个口径需要把模型消耗、计算资源、工具运行、工程师复核及任务返工计入同一条项目记录。对准备部署多角色工业智能体的企业,统一的任务账本将直接影响模型组合的选择。
专业交付物成为模型与行业知识相遇的地方
此次发布特别强调模型遵循既有幻灯片、表格和文档模板的能力。官方展示了沿用企业现有配色、版式和字体规格的幻灯片、遵照财务结构生成的工作簿、围绕指定专业标准完成的书面交付物。对于制造业,这类改进可能比聊天界面里多回答几条知识问答更快地反映在日常工作中。机械行业的技术协议、BOM、检验报告、热处理工艺卡、设备维修记录和客户验收表往往早有稳定格式。工程师需要将新数据填入正式模板,保证同一产品编号在所有文件中一致,最终由相应责任岗位确认签发。
如果企业把标准模板、字段字典、文件命名规则和产品族约束接入智能体,模型就可以从历史资料中检索满足条件的内容,形成初稿并把需要复核的参数指向原始文件。PLM里保存产品构型,MES里保存生产执行记录,QMS里保存质量判定与追溯,文件夹保存设计计算附件。模型输出的一个技术说明书可以把这些系统连接起来,让阅读者看到参数与图纸、试验曲线和工单的对应关系。这样做还便于在同一任务上逐代替换模型:新模型只要遵循已有的数据契约和交付格式,就可以进入现有流程比较表现。
为什么工程领域需要工具链,而不是孤立的模型接入
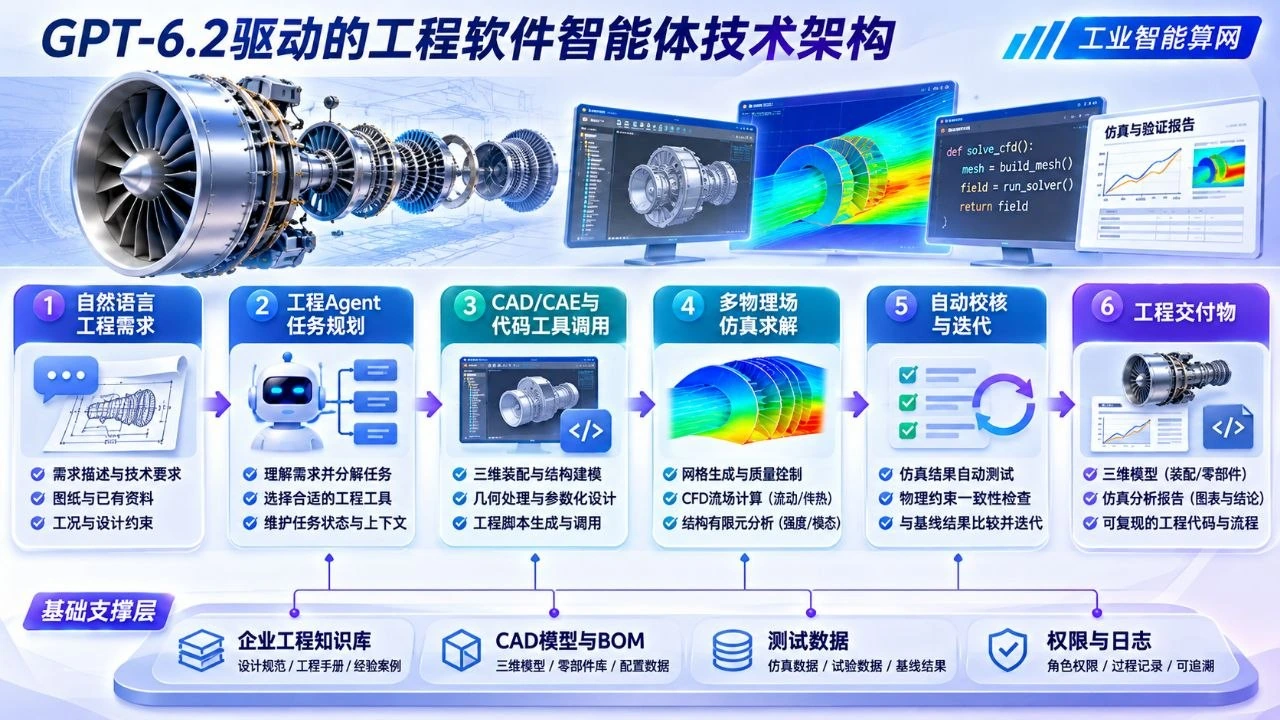
传统CAE软件的价值包含物理模型、网格算法、求解器、结果分析与大量行业经验。CAD软件也包含几何约束、特征建模、装配关系以及与加工制造相关的完整数据结构。GPT-6.2示范的计算机操作能力,使自然语言任务可以继续向下分解到几何修改、脚本执行与仿真调用。这为工业智能体平台提供了一条可操作的技术架构:让模型负责理解需求和调度,让专业工程内核处理确定性的几何与数值问题,让企业现有业务系统保存任务状态与审批结论。
这套架构还需要细分操作权限。设备工程师可以批准修改运维参数,但通常不应同时拥有更改产品主BOM的权限;工艺工程师可以修订某版本工艺卡,却不能绕过正式的工程变更审批。智能体的执行身份、工具许可、版本切换与日志留存必须沿着企业岗位授权机制设计。对于数据不出厂的客户,可以把产品图纸、工艺文件、试验结果与本地知识库放在内网,按任务性质决定哪些通用内容调用云端模型、哪些涉密数据必须由本地模型处理。新的模型能力能被吸收到这些现有约束之内,企业才可能把一项演示任务扩展成一条常态化业务流程。
从工程项目进入软件产品,需要一套连续验证方法
企业团队可以选择一组有代表性的既有任务,建立可重复运行的工程评测。比如从历史工单挑选不同材料、不同压力等级的阀门设计变更,准备一组有基准答案的BOM核对任务,再选取网格敏感性研究和典型设备故障分析作为计算场景。对每项任务固定输入数据、输出格式、允许使用的软件工具、完成条件和人工审核标准,然后比较不同模型配置的完成率、错误位置、运行时间和综合成本。评测结果积累下来,可以帮助采购方判断哪些岗位适合直接使用智能体,哪些任务应该先补齐数据质量和工具接口。
OpenAI同时介绍了模型在更复杂的编码修改、仓库级操作和软件测试方面的改进。这对传统工业软件企业具有另一层意义。许多工程软件积累了多年代码,包含Fortran、C++、Python、专用脚本以及与商业求解器的接口。智能体可以沿着完整测试链路参与代码阅读、模块修改、回归验证和用户界面更新。工程团队能够把计算一致性、产品性能与审计信息做成自动门禁,让软件升级速度与验证强度同步提高。模型从技术演示进入长期交付,最终会体现在工程师每天少做多少重复工作、设计和试验记录能否更顺畅地流转,以及企业是否积累出一套越来越好用的研发数据资产。
原始资料
- OpenAI,Introducing GPT-6.2 Astra and Sol,2026-11-17:https://openai.com/index/introducing-gpt-6-2-astra-sol/
- OpenAI,GPT-6.2 System Card,2026-11-17:https://deploymentsafety.openai.com/gpt-6-2-astra-sol/internal-deployment-of-gpt-6.2-astra-and-gpt-6.2-sol
- Microsoft,Ignite 2026: Building the frontier ecosystem,2026-11-17:https://blogs.microsoft.com/blog/2026/11/17/ignite-2026-building-the-frontier-ecosystem/