今天,我们习惯了打开对话框,把一段报错日志丢给 AI,或者让它直接上手修改几十个代码文件。但在它能够像一名成熟工程师那样条理清晰地拆解任务之前,它其实经历了一段从零开始的“求学与历练”。
如果把训练一个大语言模型比作培养一名学生,无论背后的技术路线如何演进,它的成长都绕不开三个核心阶段:预训练(Pre-training)、监督微调(SFT),以及决定最终能力上限的强化学习(RL)。
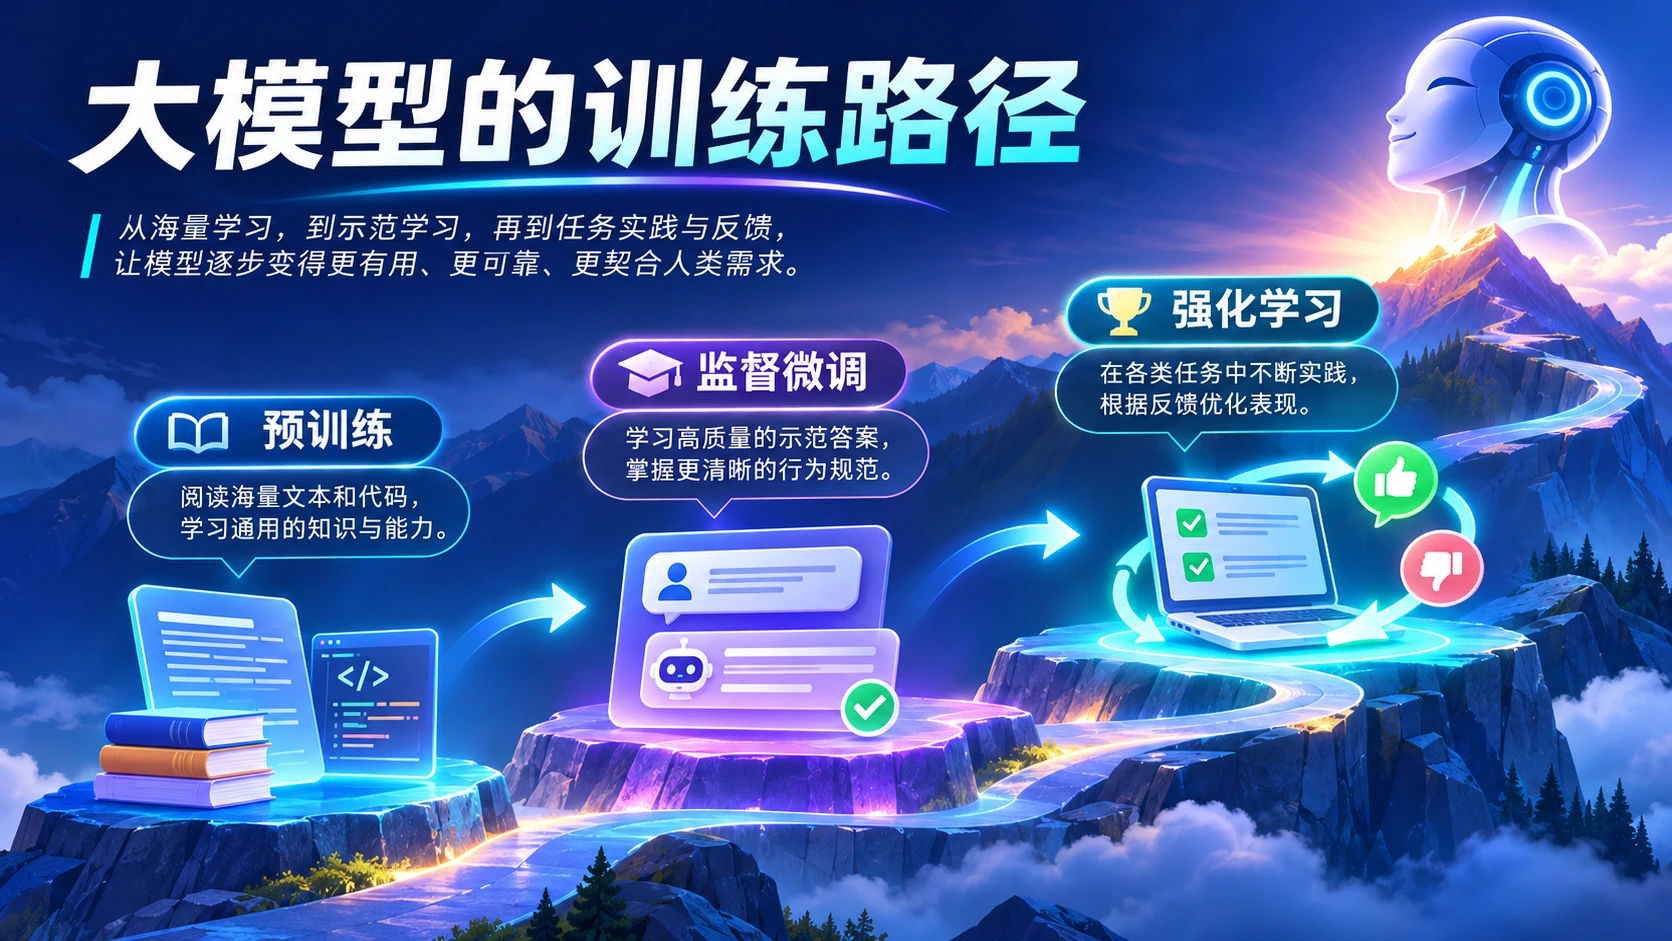
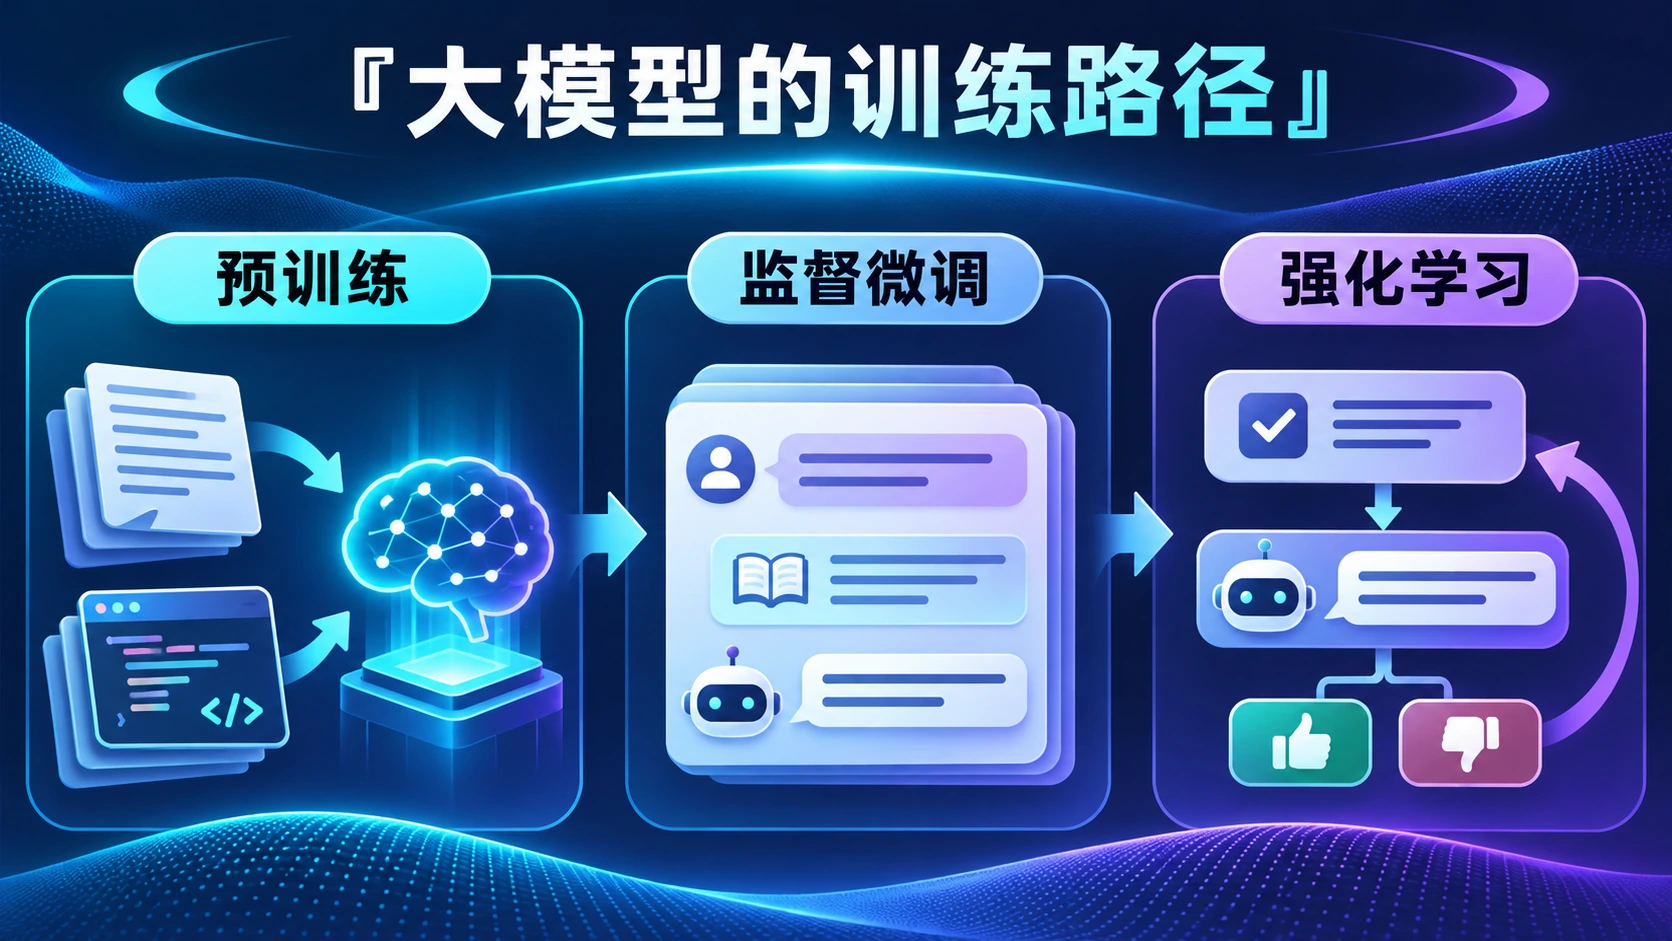
第一步:预训练——关进图书馆的“猜词游戏”
大模型的起点,是一张白纸般的神经网络,里面只有随机初始化的数十亿甚至上万亿个参数。训练的第一步,叫作预训练。这相当于把一个刚出生的孩子直接锁进一座囊括了全人类数字知识的超级图书馆——里面有百科全书、学术论文、网页论坛、开源代码仓库,以及各种高质量的合成文本。
在这个阶段,没有任何老师在旁边讲解语法规则,也没有人教它什么是逻辑推理。它每天只玩一个极其枯燥的游戏:文字接龙(Next-Token Prediction)。系统会把一句话的后半截遮住,让它根据前面的上下文,去预测下一个最可能出现的词是什么。在成千上万张高性能计算卡上,这个“猜词游戏”会以万亿次为单位日夜不停地运行。为了把下一个词猜准,模型被迫在内部建立起对语言结构、事实知识、代码语法甚至基础因果律的压缩映射。
但预训练结束时,我们得到的还不是一个好用的助手,而是一个“博学但不会聊天的书呆子”。它脑子里装满了知识,却不知道自己是一个人工智能。如果你在此时问它:“我的服务器连不上网了,怎么排查?”它很可能会顺着互联网论坛语料的惯性,在后面接上一句:“楼主后来解决了吗?求踢一脚。”它只会续写,还不懂什么是“回答问题”。
第二步:监督微调——手把手教规矩的“示范课”
为了让这个只会续写的“书呆子”学会与人类正常对话,就需要进入第二个阶段:监督微调(Supervised Fine-Tuning,简称 SFT)。如果说预训练是“读万卷书”,那么监督微调就是“请名师开小灶”。在这个阶段,研发团队会构建一批高质量的“示范教材”——由人类专家或顶尖模型编写的成千上万组(指令,标准回答)配对数据。
老师不再让它自由发挥去猜网页的下一句话,而是把标准范文摆在它面前,手把手教它立规矩:对话边界——当别人提问时,你的身份是助手,应该直接给出解决方案,而不是反问;表达范式——遇到复杂问题时,如何分点陈述、如何组织结构、如何保持客观礼貌;思考与行动轨迹——在面对复杂推理或需要调用外部工具的场景时,示范数据还会展示“应该先拆解哪一步、如何查阅文档、拿到结果后再如何归纳”的完整思维链(CoT)。
经过监督微调的模型,终于完成了从“文本补全机器”到“对话助手”的蜕变。它懂规矩、听得懂指令,也能模仿范文写出像模像样的分析。但模仿终究有天花板。只靠背诵范文的学生,一旦在真实世界里遇到从未见过的复杂难题,或者需要连续执行几十步操作的长链路任务时,就很容易因为没有现成模板可抄而陷入僵局。
第三步:强化学习——闭关刷题与“打分表”法则
真正拉开模型推理深度与工程可靠性的,是第三个阶段:强化学习(Reinforcement Learning,简称 RL)。到了这一步,老师把所有的标准答案和范文全部收走,直接把模型扔进真实或高仿真的考场与沙盒环境里,让它自己去试错。
强化学习的运行机制可以用六个字概括:做对给糖,做错挨罚。面对一道复杂的算法题,或者一个包含数十万行代码的真实软件仓库,模型需要自己生成解题思路、编写代码、在终端里运行测试。如果它跑通了测试、拿到了正确答案,系统就会给它一个正向的奖励信号(Reward);如果它胡说八道、修改了不该动的配置文件,或者陷入死循环,系统就会给予负向惩罚。
在成百上千万次的自我博弈与试错中,模型为了拿到更高的分数,会自发涌现出一些人类未曾硬编码教给它的高级能力——比如在写到一半发现思路不对时主动停下来反思、回溯检查前面的步骤,甚至在工具报错时根据日志自我修正。
这里藏着大模型训练中最核心的一条规律:你的“打分表”(奖励函数)怎么设计,模型就会长成什么性格。如果打分表偏重人类主观的阅读体验,模型就会学会把排版做得极其漂亮、语气极其自信,但代价是偶尔为了迎合用户而“一本正经地胡说八道”;如果打分表严格绑定客观可验证的结果(如数学答案是否正确、代码编译是否通过),模型就会进化成极其犀利的解题高手;如果打分表被嵌入真实的多步工具沙盒,并且重罚“自作主张”和“隐瞒错误”,模型就会被打磨成一个恪守边界、遇到模糊指令会老实确认、在无人盯防时也能稳步推进工程任务的“资深工程师”。
在复杂的多步自动化任务中,单步可靠性哪怕只差几个百分点,经过几十步的连乘放大后,最终的成功率也会产生数倍的鸿沟。强化学习阶段的打磨,本质上就是在压缩那几个百分点的失误率。
从文字接龙到数字工匠
回看这三步走,大模型的炼成其实是一场极具美感的递进:预训练赋予了它知识广度,让它看遍人类文明的文本沉淀;监督微调赋予了它行为规范,让它学会理解人类意图并得体地表达;强化学习赋予了它决策深度与可靠性,让它从“模仿答案”走向“独立解决问题”。
每一次你在屏幕上看到模型深思熟虑地推演逻辑、或是有条不紊地调用工具完成复杂工作时,背后都是这三层训练历练共同作用的结果。