工业智能技术深度观察|2026年11月16日
开源项目:NVIDIA Cosmos Data Factory
官方仓库:https://github.com/NVIDIA/cosmos-data-factory
一、缺陷样本不足,视觉质检模型怎样训练
在不少制造企业,讨论视觉检测时第一个问题是选择什么算法:目标检测、语义分割、异常检测,还是视觉语言模型。真正进入现场之后,团队会遇到更朴素的现实:产线中的合格品很多,真正具有代表性的缺陷样本却很少;研发阶段新产品尚未投产,更没有稳定缺陷数据;某些极端缺陷只能在故障、调机或破坏性试验时获得。工业视觉的长尾分布十分明显,小概率缺陷可能具有很高的质量代价,但以自然生产方式采集需要长时间等待。产品规格一变,器件封装、表面反光、焊点位置、照明角度就会发生变化,原来训练的数据集又可能面临重新标注与重新覆盖。
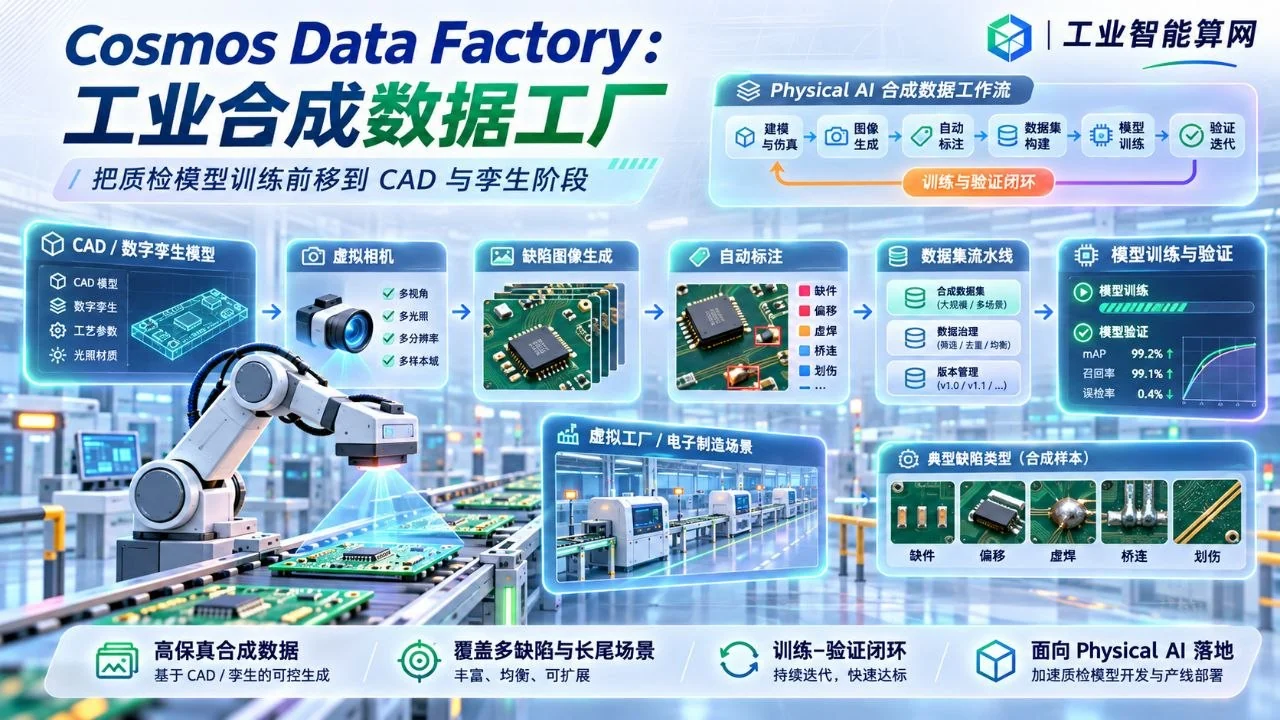
这正是合成数据近年受到重视的原因。借助CAD、产品数字孪生、图像生成模型和物理渲染器,可以在实际样品不足时先构造训练样本,把部分视觉算法开发从真实物料到位之后前移到研发阶段。NVIDIA公开的Cosmos Data Factory(CDF)提供了更完整的数据生产框架:它不是单独的图像生成模型,而是一组由智能体驱动的参考工作流和可组合技能,能够执行数据整理、检索、增强、标注、生成与评估,既可以使用自有GPU本地运行,也支持企业选择的云环境。仓库中的缺陷图像生成蓝图覆盖PCB、金属和玻璃部件参考图,体现了Physical AI数据工程从“模型能力”走向“可复用生产管线”的趋势。[1]
二、数据工厂与普通文生图最大的区别是什么
普通文生图的成功标准通常是视觉上符合描述;工业合成数据的成功标准是能够改善下游识别、检测、定位或控制任务。二者之间至少隔着三道关。第一,几何和语义必须保持正确:一个电子元件能有多种合理光照,却不能随意改变引脚数量;一条裂纹可以有不同走向,却不能无视材料表面结构;一个装配缺陷可以是位置偏移,却不能把整个产品结构幻化成不存在的新零件。第二,需要可训练的标签:缺陷框、像素掩膜、异常类别和关键点必须与生成图像严格对齐。第三,需要分布控制:生成样本既要覆盖真实现场可能发生的变化,又要避免大量不合物理的样本干扰模型。
Cosmos Data Factory的架构围绕这些问题组织。官方README列出多个参考蓝图,包括自动驾驶数据集生成、缺陷图像生成、事件视频生成、图像属性增强和视频数据增强;通用能力包括检索与整理、自动标注、仿真渲染、异常合成、增强以及工作流编排。部分视觉场景可以利用Isaac Sim和Omniverse Replicator从三维场景输出带标注的图像,另一些流程则使用生成式模型在已有图像上产生受控变化。这样一来,工业企业可以围绕某项质检任务选择最合适的数据来源,而不是假设一种生成模型能同时负责精确几何、真实缺陷、标签和所有工况覆盖。[1]
三、PCB缺陷生成为什么是一个很好的工业切入口
PCB与PCBA视觉检测具有强结构性:元件封装、焊盘、走线和器件位置通常能从设计资料中获得相当明确的先验。与自然场景相比,这种先验有利于构建可控的合成数据。以一块新设计的PCBA为例,企业可从CAD、Gerber、BOM和3D组件模型获取布局信息,通过渲染器生成不同相机视角、光照和材质条件下的正常样本,再按缺陷语义加入器件偏移、缺件、表面异常或特定焊接外观变化,生成同时包含图片与标签的数据。实际上,不同缺陷的可信生成方式应有所区别:器件偏移适合利用几何变换和3D渲染,表面污染可采用纹理合成,某些焊点内部问题则无法仅靠普通可见光图像可靠表征。
CDF的Defect Image Generation工作流被描述为把PCB、金属和玻璃部件参考数据转换为合成SMT部件图像,再进行图像增强和缺陷生成。它为构造稀缺缺陷集提供了起点,但并不意味着系统已经知道每种企业产品的全部缺陷机制。实际设计时需要由工艺、质量和设备工程师共同定义缺陷分类及其可观测特征,例如极性错误、移位、虚焊、翘脚、少锡、污染、划伤和异物。每类缺陷都要明确检测手段、对应工位、缺陷尺寸范围及验收标准。生成系统接受的应是这些经过工艺审查的缺陷规格,而不是一句笼统的“再造一千张坏板照片”。
四、为什么合成数据不应脱离CAD、BOM和工艺文件
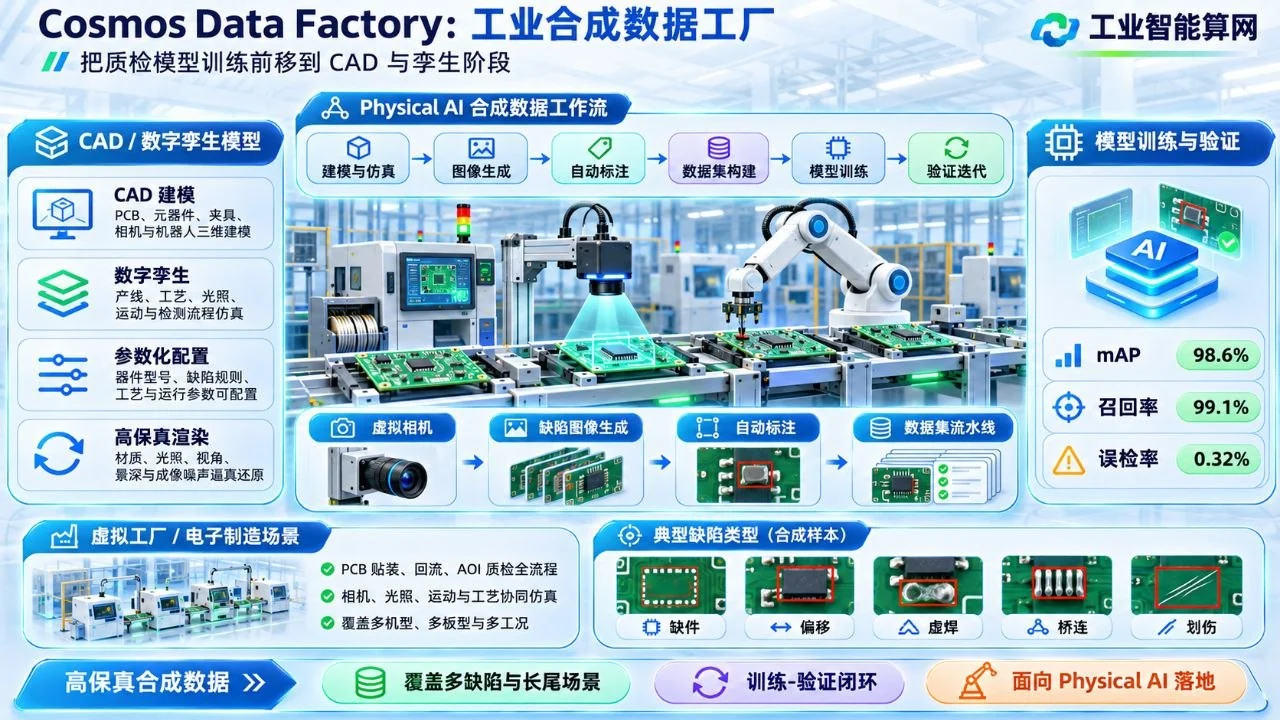
想让模型在实际产线上有效,图像生成过程需要理解产品结构。CAD与三维模型提供可见几何,BOM告诉系统有哪些器件和物料,工艺文件提供组装顺序与位置容差,检测规范定义哪些偏差属于缺陷,AOI设备配置则决定相机、光源和分辨率。缺少这些约束时,视觉模型可能在合成数据中学到无意义的背景纹理和生成伪影。一个更可靠的工业数据流程,应从产品版本开始建立主线:产品版本确定场景资产,工艺版本确定缺陷规则,检测设备版本确定成像参数,数据版本确定训练集和标签范围,最终训练模型也必须追溯到相应版本。
这种结构天然可以与工业智能体结合。设计智能体负责从PLM和CAD读取经批准的产品结构,质量智能体维护缺陷分类和检验规则,仿真智能体生成不同光照与视角下的图像,数据智能体执行去重、标注校验与数据切分,训练智能体输出检测性能报告。关键不在于把各模块统称为多智能体,而在于每一阶段都留下可验证的产物。比如某张合成图像必须能回答:对应哪个PCB版本、哪种器件、什么缺陷参数、哪套渲染配置、哪次随机种子、由哪个流程生成,以及是否通过人工或规则检验。没有这样的可追溯性,几万张生成图会变成难以治理的文件堆积。
五、CDF怎样把分散的模型能力装配成流水线
官方仓库将参考蓝图组织为Airflow DAG,由CDF Orchestration统一调度,Kubernetes为各参考蓝图提供部署支持;某些视频类工作流还支持OSMO后端。企业可以把每个阶段理解为一个有输入输出契约的可复用技能,例如素材检索、图像增强、自动标注、缺陷生成与质量评估。相对于脚本串接,这种编排方式更方便管理重复任务、产物目录、任务失败与资源分配。仓库说明部署需要Kubernetes集群、对象存储、镜像仓库以及相应服务访问凭据,GPU要求则随具体蓝图变化,因此它不是一个无需工程准备即可离线运行的轻量小程序。[1]
从信息系统设计角度看,应建立数据血缘与任务元数据:每个DAG运行关联输入数据集、生成模型版本、超参数、软硬件配置、标签模式和质量门槛。数据量庞大时,还需记录资源成本,例如生成每千张合格图像所需的GPU时间、人工复核成本与合格样本保留率。这样,企业才能判断“多生成一些图片”究竟对质检效果有多大帮助,或者哪些缺陷类别应改用真实采集。更进一步,可以把误检、漏检和人工复判结果反馈到数据管线,优先补充对决策边界影响最大的难例,形成受实际生产质量数据驱动的迭代闭环。
六、合成图像看起来真实,并不等于训练有效
合成数据的评价需要两个层次。第一个是样本自身质量,检查是否存在物体形变、异常背景、错误标注或违背物理直觉的现象。CDF提供Cosmos Evaluator,用于对合成视频或内容进行物理合理性、物体一致性、属性准确性等检查。第二个层次更重要:用这些数据训练出来的检测器,面对从未参与训练的真实产线图像究竟表现如何。前者是数据生成质量,后者才是业务效果,两者相关但并不等价。生成器即使输出非常逼真的图像,也可能持续遗漏一类关键缺陷;反过来,一些视觉风格并不完全写实的样本,若精确保留任务相关几何特征,也可能改善模型泛化能力。[1]
建议采用清晰的消融实验:只用真实数据训练作为基线;真实数据加普通几何与光照增强作为第二组;真实数据加CDF合成数据作为第三组;再设置不同合成占比及不同缺陷类别覆盖的对照。测试集必须由独立的真实样品构成,最好跨批次、跨设备和跨时间窗口。评价不仅看mAP,还要给出按缺陷类别划分的召回率、误报率、漏检率、每块板的复判工作量以及产线节拍影响。对于极端稀缺的严重缺陷,还需研究是否可以用受控试验样本和工程判据补强评估。这套方法能够回答合成数据是否真的帮助了质量工作,而不是只证明图像生成管线跑得通。
七、开源许可证、部署边界与数据主权如何理解
核查官方仓库的LICENSE文件,可以确认其对文档和Skills采用CC-BY-4.0,对源代码采用Apache-2.0,并非没有许可证。企业仍需逐项检查模型权重、示例数据、第三方依赖和商用服务的具体授权,因为仓库源代码许可不自动覆盖所有外部资产。CDF官方描述支持在自有GPU上本地部署,也支持用户选择的云环境;对于强调数据不出厂的制造企业,可将原始图像、CAD、训练资产、标注结果和模型评估报告保存在本地对象存储中,通过本地编排集群统一执行。是否能够完全离线、有哪些模型或容器需要预下载,应根据选定蓝图逐项核实,而不宜直接把“支持本地运行”理解为“所有能力天然零外网依赖”。[2]
这也涉及企业数据安全的实质问题。PCBA设计与高精度设备图像可能包含敏感产品信息,即使合成图像不是原始照片,也可能重现结构细节。工业数据管线需要对输入、输出、日志和缓存实施一致的权限管理,明确训练与测试数据的保留期限,防止为了生成样本而无意扩散设计资产。相比把所有素材发到未知外部API,具备本地计算、可审计编排和模型版本锁定的工作流更适合进入长期工业生产体系。
八、从“数据不足”转向“数据生产能力”
Cosmos Data Factory值得关注的地方,不是生成式AI又多了一种图像玩法,而是工业视觉正在出现专门的数据生产基础设施。未来产品研发一旦形成新版本,系统有机会自动检索CAD和工艺规范,识别缺少的质量场景,生成候选训练数据,完成标签与物理合理性检查,再触发检测模型的再训练与回归测试。对于多品种小批量、产品迭代快的装备制造企业,这条路线可以显著改变视觉质量系统的准备方式;实际收益有多大,则必须用各自工艺和真实测试集回答。
合成数据应进入工业研发数据集和产品数字主线,并与检验结果一起维护。其上游是CAD、PLM、BOM、工艺和仿真,其下游是AOI、质量追溯、设备调试与MES生产记录,中间用可执行、可追溯的数据工作流串联。这样,工业智能体才能把“新产品尚未上产线”转化为“先完成部分质量检测准备”的现实能力。数据工厂真正生产的不是图片数量,而是可验证、可复用、能持续改善检测质量的数据资产。
九、数据生产管线如何和持续质检形成闭环
合成数据部署后的运行机制也值得专门设计。企业可以在AOI检测系统中收集误报样本、漏检复盘、人工复判结论和新产品变更事件,在获得批准后自动触发特定缺陷类别的数据补充任务。新增图像先进入候选数据池,经过重复样本检查、标签一致性验证和真实样本匹配,才进入下一轮训练。模型上线采用版本化灰度验证:在相同工位、同一批真实图像上对比新旧模型,而不是依赖合成训练集内的分数。上线之后继续按产品版本和缺陷类别追踪表现,如果效果下降,可以准确找到对应的数据生成批次和模型变更。这样,Cosmos一类工具才会从一次性实验变成真实的质量数据基础设施,也使数据工程师与工艺质量工程师之间的协作具有可执行的接口。
对于工业数据集,还需要把“缺陷的真实性”和“缺陷可观测性”分开。某些内部焊接缺陷即使在物理上确实存在,也未必能从普通外观相机中直接识别;在生成图像中人为添加可见纹理,反而可能教会检测模型识别现实里不存在的视觉信号。因此,缺陷生成前应由质量工程师确认对应检测手段:外观、X射线、三维轮廓、热像或电测试各自具有不同的物理可观测范围。跨设备数据集还应记录分辨率、焦距、曝光和光源配置,防止模型借助某一种摄影条件区分“正常”和“缺陷”。如果能通过检测物理机制与数字资产共同约束生成过程,合成数据才能真正成为工业智能体可调用的质量工程工具。
参考资料
[1] NVIDIA. Cosmos Data Factory: Synthetic Data Generation Workflows for Physical AI. GitHub项目README. https://github.com/NVIDIA/cosmos-data-factory
[2] NVIDIA. cosmos-data-factory/LICENSE,CC-BY-4.0与Apache-2.0条款:https://github.com/NVIDIA/cosmos-data-factory/blob/main/LICENSE
[3] NVIDIA CDF缺陷图像生成蓝图:https://github.com/NVIDIA/cdf-orchestration/blob/main/skills/cdf-defect-image-generation/SKILL.md
本页两张配图均为概念示意,图中数字和流程不构成真实运行或实机验证数据。