“把这台泵的报警阈值调高一些。”如果智能体立刻打开配置页面、算出新阈值、提交变更,演示会很顺畅。可操作员也许只是想少遇到误报警和停机;阈值到底该不该改,还没查。采购要“最低价供应商”,真正要交付的却是合格零件;质量人员要求“再训练一轮模型”,也未必能解决检验记录与工艺参数无法追溯的问题。用户提出的是手段,系统要负责的是目标。2026年11月13日,艾伦人工智能研究所Ai2发布XYBench,用8115个问题测试AI能否看出这类偏差。它不是工业智能体测试集,但对“一句话执行”式产品演示提出了一个扎实的追问:执行得快之前,目标弄对了吗?
XY问题不是语言技巧,而是任务定义错误
软件工程里所谓“XY问题”,是想做成X,却先选了Y这个办法,随后只询问Y该怎么做。对方即使把Y讲得毫无差错,也可能帮错忙。XYBench把表面请求记为Y,从上下文可以推断的真实目标记为X;评测不只看回答有没有两种方案,还看它把主要注意力放在哪里。参与研究的人员来自Ai2、卡内基梅隆大学、NVIDIA和约翰斯·霍普金斯大学;研究介绍与相关代码资源已在Hugging Face公开。
工厂里也常这样说话。设计人员说“连接板再厚些”,想解决的可能是疲劳寿命;设备人员要换大风机,目标可能是给定压损下达到指定风量。售后要求追加润滑,也得先看轴承装配、工况和污染情况。这里的操作建议并非无效,它只是一个待检验的假设。工程师不会在问清目标、约束和原因之前,就把它直接写成施工单;智能体也不该如此。
8115条样本如何组织:既有真实问题,也有结构化构造
这8115条问题来自四类材料:1557条Stack Overflow问题、184条Stack Exchange问题、102条人工整理案例,以及基于WikiHow操作指南构造的6272条问题。论坛中的问题可利用高评分人类答案和被接受答案帮助确定实际目标与可能方案,操作指南类样本则围绕常见误解生成,再经过过滤,让案例中保留足够的上下文线索。其中,直接回答字面请求就能基本解决问题的样本被排除,以便集中测试目标与方法发生偏差的情况。
企业若要自建类似评测集,材料未必难找,难的是标注。售后工单里可能有“反复要求换件,最后靠工艺调整解决”的记录;质量闭环里可能有“最初怀疑检测算法,后来查到设备参数或物料批次”的记录。业务专家需要把最初的请求、要达到的目标、当时可见的线索和最终采用的方案分开标注,尤其不能把事后才知道的原因偷塞进提问上下文。这样测到的才是系统根据已有证据判断的能力,而非复述结案报告。
评测的三个维度:提出了什么、强调了什么、是否识别前提
XYBench没有把“回答里是否出现正确建议”作为唯一标准,而是分别设置Pragmatic solution、Pragmatic emphasis和Misconception identification三个指标。第一个维度检查回答是否包含用户显式请求Y的方案以及真实目标X的方案;第二个维度判断回答的主要篇幅和重心放在Y、X还是两者之间;第三个维度看模型是否发现原先手段存在的误解,并主动引导解决真实目标。区分“提到了X”和“主要在解决X”很必要。答案可以用十段篇幅讲怎么执行Y,末尾随口添一句“也可以检查其他原因”;只靠关键词命中,容易把它判成合格。
工业评测也该看回答重心。设备诊断系统是先给出维修操作,还是先安排与根因有关的验证?采购系统只排价格,还是把材料认证、到货周期、质量履历和工艺适配放进主要判断?设计系统接到修改尺寸的请求时,有没有先核对载荷工况和性能目标?答案出现了哪些词不够,还得看它准备先做什么。
五组模型实验:字面请求仍然更容易抢走注意力
Ai2在报告中测试了Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B和DeepSeek-V4 Pro。研究公布,在Stack Overflow子集上,模型回答中包含针对字面请求Y方案的比例约为75%—86%,包含针对真实目标X方案的比例为59%—71%。当考察回答主导重心时,只有35%—41%的回复主要围绕真实目标展开,47%—57%主要围绕字面请求,剩余部分大致兼顾两者。在这一子集及所测模型中,回答提到X并不罕见,但主要围绕X展开的比例明显低于围绕Y展开的比例。放到企业软件里,问题不只是“系统有没有想到”,还有“它会先安排哪一步”。
研究还加入一种更有意思的实验:直接把真实目标X告诉模型,再让它作答。按报告所述,Sonnet 4.6在Stack Overflow数据上的真实目标解决方案覆盖率从59%升至67%,但错误前提识别指标从47%降到34%。这组变化并不意味着“告诉模型目标反而更糟”:X方案覆盖率上去了,只是模型主动指出Y的错误前提更少了。给足背景、确认目标、检验用户提出的手段,是三件不同的事;提示词里直接补上X,不能代替后两项。
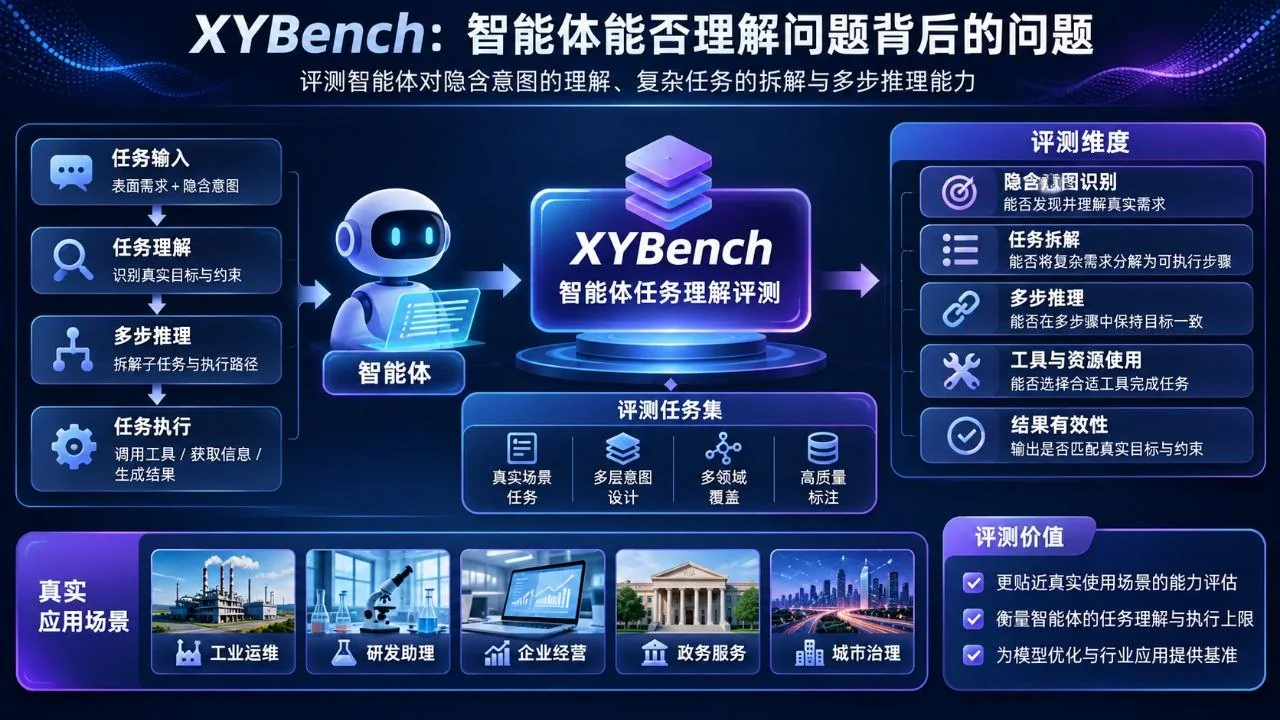
工厂案例一:为什么“把报警调宽”不能直接变成一个工具动作
设想一条连续生产线上的离心泵近期出现频繁振动报警。班组长认为设备运转基本正常,于是要求智能体把振动阈值上调15%。如果系统把这句话当成完整需求,后续流程非常直接:查找设备号、读取PLC或监控配置、计算新阈值、修改参数、记录变更。整个过程可以做得极其流畅,权限与日志也都能够实现,演示画面甚至很有说服力。但专业工程工作从一开始就要问:最初的报警反映真实振动变化还是传感器状态,发生时的转速和流量是否变化,近期是否进行检修,是否处于低流量工况,振动谱峰与轴承、电机或联轴器状态有何对应关系。
系统首先要分清两件事:班组长希望减少误报警和非计划停机,提出的办法是调阈值。随后可以调取历史振动数据、报警频次、检修日志和工艺参数,给出需要核查的项目。数据分析与参数变更必须分开,后者仍按现场审批流程执行。评测也不能只检查阈值是否改成指定数值:若系统没有查清报警原因,即使改值成功,也不能算完成这项诊断任务。
工厂案例二:工业设计任务也存在“工具先于问题”的陷阱
装备设计工程师常常以方案语言提出需求:希望把某个钢结构连接板加厚两毫米、提高一个支座的刚度,或把设备壳体中的筋板数量增加一倍。在工程讨论中,这是一种很自然的表达方式,因为工程师已经形成初步设计假设。AI设计智能体如果只擅长CAD命令和几何修改,就能够快速输出新的三维模型与图纸,却未必改善真实性能。完整的设计任务应该从目标载荷、强度指标、边界条件、质量约束、材料以及生产工艺开始,对比多种可行路径。加厚可能改善刚度,却引起重量、焊接残余应力、装配空间和成本的变化;改变几何外形或者优化支撑方式,也可能更符合目标。
这类设计记录也可以整理成评测案例:保留客户最初要求的变更、当时可用的有限元输入、后来的仿真结果、实体试验反馈和最终方案,再分别标注“显式手段”与“性能目标”。智能体可以从现有CAD模型库找相似件,调用CAE比较候选方案的质量、刚度和应力集中情况。修改完几何只是中间结果;为什么改、改完是否接近性能目标,才需要解释清楚。
工厂案例三:质量工程中,真正的问题常常藏在跨系统关联里
一家精密零件厂发现视觉检测误报增加,质量人员可能要求“把检测模型再训练一轮”。如果把任务停在模型训练上,数据工程师就会继续收集图片、标注缺陷、调整网络参数,并组织测试。事实上,误报增加也可能来自光源老化、相机曝光设置变化、夹具定位偏差、表面工艺变化或某批原材料反光特性。真正目标是恢复可靠的质量判定能力,模型再训练只是候选手段之一。要区分这些因素,智能体需要从QMS读取不合格批次,从MES读取工单与工艺参数,从设备系统读取光源和相机状态,并将图像按生产时间、产品型号和设备编号关联。
这时,评测可以检查系统有没有说清目标、有没有请求必要的跨系统数据,以及原因排序是否能被后续检查证实。每个案例未必只有一个标准答案,但关键动作可以有验收条件:没有证据表明相机参数变化时,先对比不同时段的采集条件;发现异常与原料批次相连时,继续追查同批次产品。若系统一开始就安排训练模型,却没有核对采集和生产条件,输出再完整也绕开了问题。
从评测指标到Harness:把目标发现写进智能体运行链路
把这项评测用于产品,不能只在聊天窗口加一句“请思考用户真正意图”。Harness需要把目标辨认放进运行链路:入口记录用户原话、对象、约束和所提手段;规划器另行维护经证据支持的业务目标。两者关系尚不明确时先澄清,再决定是否调用工具。每一步工具调用保留输入、返回值、状态与证据位置;复核时既能看到指令有没有执行,也能看到它是否有助于目标。
历史任务可按工艺场景、岗位、产品线和错误假设类型分组,逐条评价目标识别、工具选择、诊断路径、结论依据与执行结果。自动评分也需要人工校准。Ai2披露,在500份回答上,自动评价器与两位人工评审的一致率随指标而变:判断解决方案是否出现为97.5%—100%,识别误解为84.6%—93.3%,判断回答重心仅为74.2%—79.8%。越是涉及“主要在解决什么”的判断,越不能把自动评分当作无需复核的裁决。
对工业智能体产品的影响:先做任务理解,再谈自主执行
“一句话操作ERP”“一句话改三维模型”“自动生成工单”,展示的是执行能力。实际交付还得问:采购要保住到货和质量,生产要兑现订单,设备要控制停机,研发要兼顾性能与可制造性,用户提出的那个动作究竟能否帮到目标?把口头要求视为工程讨论的起点,系统才有机会先查约束和证据,再安排下一步。
XYBench不是工业基准,也不能用其论坛题目的分数直接推断产线表现。不过它提醒团队把三件事分开测:有没有发现真实目标,回答和行动有没有围绕目标展开,有没有指出用户最初手段的前提问题。把这些记录与实际工具执行结果放在一起,模型或框架升级之后,才能看清改善的是文字表达、任务判断,还是现场工作的完成情况。