设备旁的屏幕能显示报警、弹出工艺卡片,也能播放预录提示。可一旦报警内容、维护提醒要随现场情况变化,语音功能往往又被接到云端服务,或被安排在算力更强的工业电脑上。网络断了怎么办,调用费用怎么算,控制器能不能常年稳定运行?这些问题比演示时的声音是否悦耳更难回避。2026年11月13日,独立开发者Nguyen Ngoc Thien在Hugging Face公开越南语文本转语音模型TiHon-TTS:100118个参数,FP32网络权重约402KB,支持四种声音,并给出微控制器CPU与Arm Ethos-U NPU分担计算的方案。开发者报告x86单核可达到40倍实时速度,Apple M4单核为83倍。它没有证明所有工业终端都该部署语音模型;它至少把一个值得认真算的账摆在眼前:终端只需念出指令和报警时,究竟需要多少模型能力?
从巨型语音模型到402KB:先重新定义任务
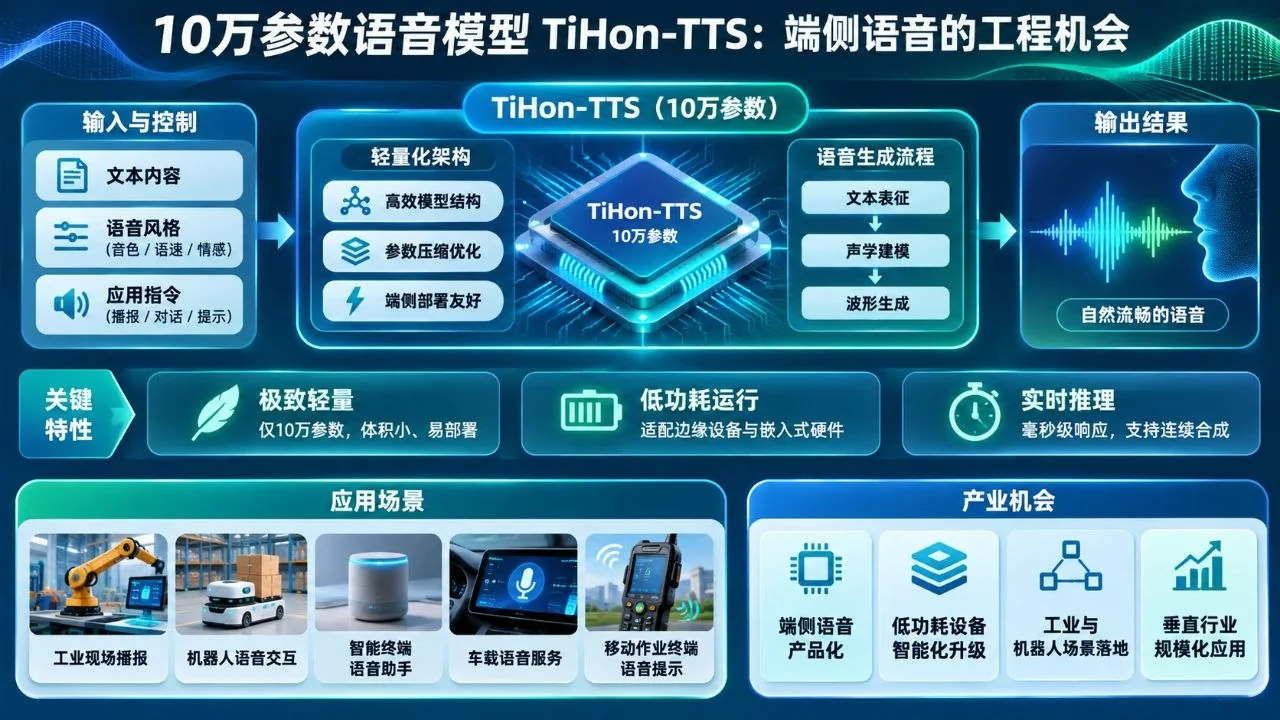
通用语音模型要处理转写、理解、生成,有时还要兼顾音乐、噪声、音色与情绪;TiHon-TTS只做一件事:把越南语文本念出来。任务收窄后,开发者没有让网络直接生成波形,而是让它预测音高、清浊声状态与谱包络,音频合成则交给传统数字信号处理。网络学难以手写的语言—声音映射,确定性算法做可以明确描述的重建工作。这不是把一个通用语音模型缩小,而是从输入到输出重新划分工作。
原始技术介绍列出相当详细的参数账本:输入Token嵌入4200个参数;共享的卷积门控编码模块20328个参数;双向GRU上下文模块14560个参数;时长与音高预测器6722个参数;扩张深度卷积解码器45584个参数;输出头3762个参数;合成器只有145个参数;四种声音各增加1176个参数。这份参数账本有意思的地方,是它从设计时就限制了模型该承担什么:共享结构,拆分任务,能用语言规则解决的先不用网络学。做温度控制不必采购全功能仿真工作站;读出一条报警,也不必默认从通用大模型开始选型。
不用神经声码器,为什么能省掉大量计算
传统神经语音合成通常包含声学模型和神经声码器。前者决定语音应该怎样发音、持续多久、音调如何变化;后者将声学特征还原成实际声音。很多神经声码器本身就有千万级参数,需要在高时间分辨率下连续计算。TiHon-TTS将这一步替换为谐波加噪声合成器,内部只有80个谐波相位参数和65抽头FIR滤波器。网络输出给出足以驱动合成器的控制信息,后者通过数字信号处理生成波形。这样处理显著缩小模型规模,也使波形计算能够直接利用成熟的CPU DSP指令与嵌入式数学库。
同样的分工可以拿来审视工业AI方案。故障报告需要识别设备、部位和故障类别,排版与字段校验却可以写成程序;工艺方案要找相似的历史案例,几何尺寸换算和加工参数边界仍应按明确规则计算。电机诊断里,复杂频谱模式可交给网络识别,电流有效值、频带能量和基础阈值则由DSP处理。要不要用模型,最好逐步问到算子和字段,而不是把一整条业务链路统称为“AI推理”。
越南语输入结构,展示了领域知识如何直接降低模型成本
越南语的音节结构和声调体系比较明确,开发者没有让小网络从大量文本中自行归纳全部语言规则,而是将音节拆成声母、介音、韵核、韵尾和韵律五类信息,再把声调带入相关音素。网络输入从原始文字转成结构化语言单元,提前解决了许多发音歧义。对于数字、日期、时间、金额、百分比和电话号码,前端用规则展开成可朗读形式。这些看似朴素的文本规则,替小模型做掉了本来要靠数据反复学习的工作。
企业自己的数据也有类似的结构。设备型号、零件编码、报警代码、工艺单位、材料牌号和图纸版本,通常都不是随意起的名字。如果系统每次都让模型猜“P-204A”是泵号、产品系列还是供应商简称,既耗推理资源,也容易把后面的检索带偏。把资产编码、字段含义、单位和业务约束先整理成机器可读的输入,往往比一味增加模型参数更直接。所谓领域知识,有时是一套设备字典、一张工艺参数表,以及几条必须严格执行的编码规则。
四种声音共享一个网络:如何让能力扩展不随规模线性增长
TiHon-TTS提供四种声音,却没有为每种声音训练一个独立的模型。四种声音共享主要声学网络,每种音色增加1176个参数,使用独立的Token嵌入与FiLM缩放、偏移参数调整解码器特征。开发者还为声音分别记录音高统计参数。这样新增一个声音需要扩展的权重约占整个模型的1%,音色差异通过少量条件参数进入共同的发音结构。这给终端语音设计提供了一种选择:共用发音主体,只为不同声音保留较小的条件模块。至于多语言,需要按各语言的输入结构另做前端,不能直接从“四种越南语声音”推导出多语言能力。
机床厂商可能需要中文、英文和海外市场的本地语言;同一条报警在不同工厂还可能对应不同的话术、语速与优先级。如果每增加一种声音都要复制整套模型,固件交付与版本维护会越来越重。共性网络与条件模块分开后,新声音的数据、训练和测试可以分别管理。TiHon-TTS目前只实现越南语四种声音;跨语种产品要重新设计文本前端与训练数据,参数共享只是可借鉴的办法,不是现成的跨语言方案。
文本蒸馏与合成训练:少量资源如何形成专用能力
训练方式也值得细看:学生模型没有直接利用人工录制的语音进行常规训练,而是通过教师系统进行文本蒸馏。冻结的教师由约1710万参数的声学模型与Vocos声码器组成,在训练期间根据文本即时生成目标音频、时长和音高信息,学生模型学习这些输出。训练数据包含78700段越南语句子片段,共运行80000步,四种声音各自分配训练步骤,末期还进行了对抗阶段训练。教师模型在训练时承担计算开销,最终终端只部署极小的学生模型。计算开销留在训练阶段,交付到设备上的是小模型。
工业AI的数据与模型部署也可采用类似分工。中试中心与仿真团队可以调用高精度CFD、多物理场求解器和大型分析模型生成标准化结果,然后将这些结果用于训练面向特定设备、特定工况的小型代理模型;企业中心服务器负责模型开发、验证与更新,产线侧的轻量模型专注稳定的预测、分类或特征提取。如果研发中心能够完成仿真与试验验证,泵阀、压缩机、工业风机、工业炉和精密装备就有机会在出厂后用有限的算力执行高频判断。不过语音蒸馏与工业代理模型的训练目标并不相同,能否落地仍取决于各设备的工况覆盖和验证成本。
CPU与NPU各做擅长的事,模型才能真正进入低功耗设备
TiHon-TTS的微控制器部署方案没有强迫所有运算进入NPU。卷积类编码器、预测器和解码器在Arm Ethos-U上以INT16图执行;双向GRU、Gaussian上采样和合成器则留在Cortex-M CPU。开发者使用Vela 5.2映射运算,在Corstone固定虚拟平台上给出了每秒合成音频约660万条CPU指令、470万NPU周期的统计;具体数量因NPU配置有所变化。这组数字来自仿真环境,作者还提供了模型、转换图和示例代码,方便开发者复现计算结构。部署实现将音频按约一秒的窗口处理,并为窗口左右配置上下文帧,以固定内存预算处理不同长度的输入。
参数少不等于一定好部署。边缘硬件里的CPU、DSP、NPU和可编程逻辑各有长短;算子能否映射,CPU与加速器之间是否反复搬运数据,播报会不会占用控制任务的关键时隙,缓冲区如何定额,都要在目标硬件上测。语音合成可以封装成同一应用接口,再针对有无NPU选择执行后端,但上层接口一致并不能替代底层实时性测试。
看懂性能数字:速度、可懂度、硬件资源分别对应不同价值
公开结果中的“40倍实时”指合成一秒语音所需的计算时间约为0.025秒,“83倍实时”对应约0.012秒的实时因子。对设备交互来说,用户体验当然包含输入文本预处理、模型加载和实际音频播放,但这些速度数据说明计算本身有相当大的空间。作者利用越南语ASR模型对合成后的测试音频进行转写,再计算字符错误率,不同声音在PyTorch和TFLite版本的公开测试中大致处于1%到2%多的区间。每种声音的测试集合只有36条保留句子,这组字符错误率只能说明指定测试条件下的可辨识程度,不宜当作现场噪声、专业术语和不同播报长度下的保证。模型文件大小、实时吞吐与运算量则是下一步硬件选型可以直接核对的数字。
对于工业产品经理来说,一套端侧语音组件是否值得采用,需要转换成更接近产品形态的指标体系。例如整机固件增加多少容量、从冷启动到第一段播报需要多长时间、设备持续工作时占用多少CPU时间、多个告警是否可以按优先级排队、离线升级如何兼容旧工艺词典、长时间运行时内存占用是否稳定。这些都可以写进自动化测试:逐条核对错误码的播报文本,专项检查设备型号和计量单位,对不同工况下的播报优先级做回归测试。听起来不错,只是语音功能验收的起点。
先选岗位任务,再决定要不要说话
一个化工装置的巡检终端可以离线朗读工艺确认项,操作员通过实体按键或简单语音输入记录检查结果;一个动力设备控制柜可以在触发特定报警后准确播报设备号、报警等级与操作指引;一个远程售后手持终端可以将服务工单和拆装步骤转为语音提示,让工程师空出双手完成操作。这些场景的共同特点是任务边界清晰、提示内容可结构化、终端资源有限、需要长期稳定运行。是否真的需要语音交互,还得看现场噪声、操作规程和设备资源。若这些条件允许,播报内容可结构化、流程边界清楚的任务,才值得考虑把小型语音组件放进终端。
TiHon-TTS没有回答工业语音系统的全部问题:现场词典、噪声环境、冷启动、控制任务抢占和长期维护,还得在产品里逐项测。它提供的是一套清楚的分工:大模型在研发阶段当教师,规则处理文本结构,小网络预测声学信息,CPU与NPU分别执行合适的运算。工业终端要不要沿用这条路,最后应由设备任务和实测结果决定,而不是由模型参数量决定。