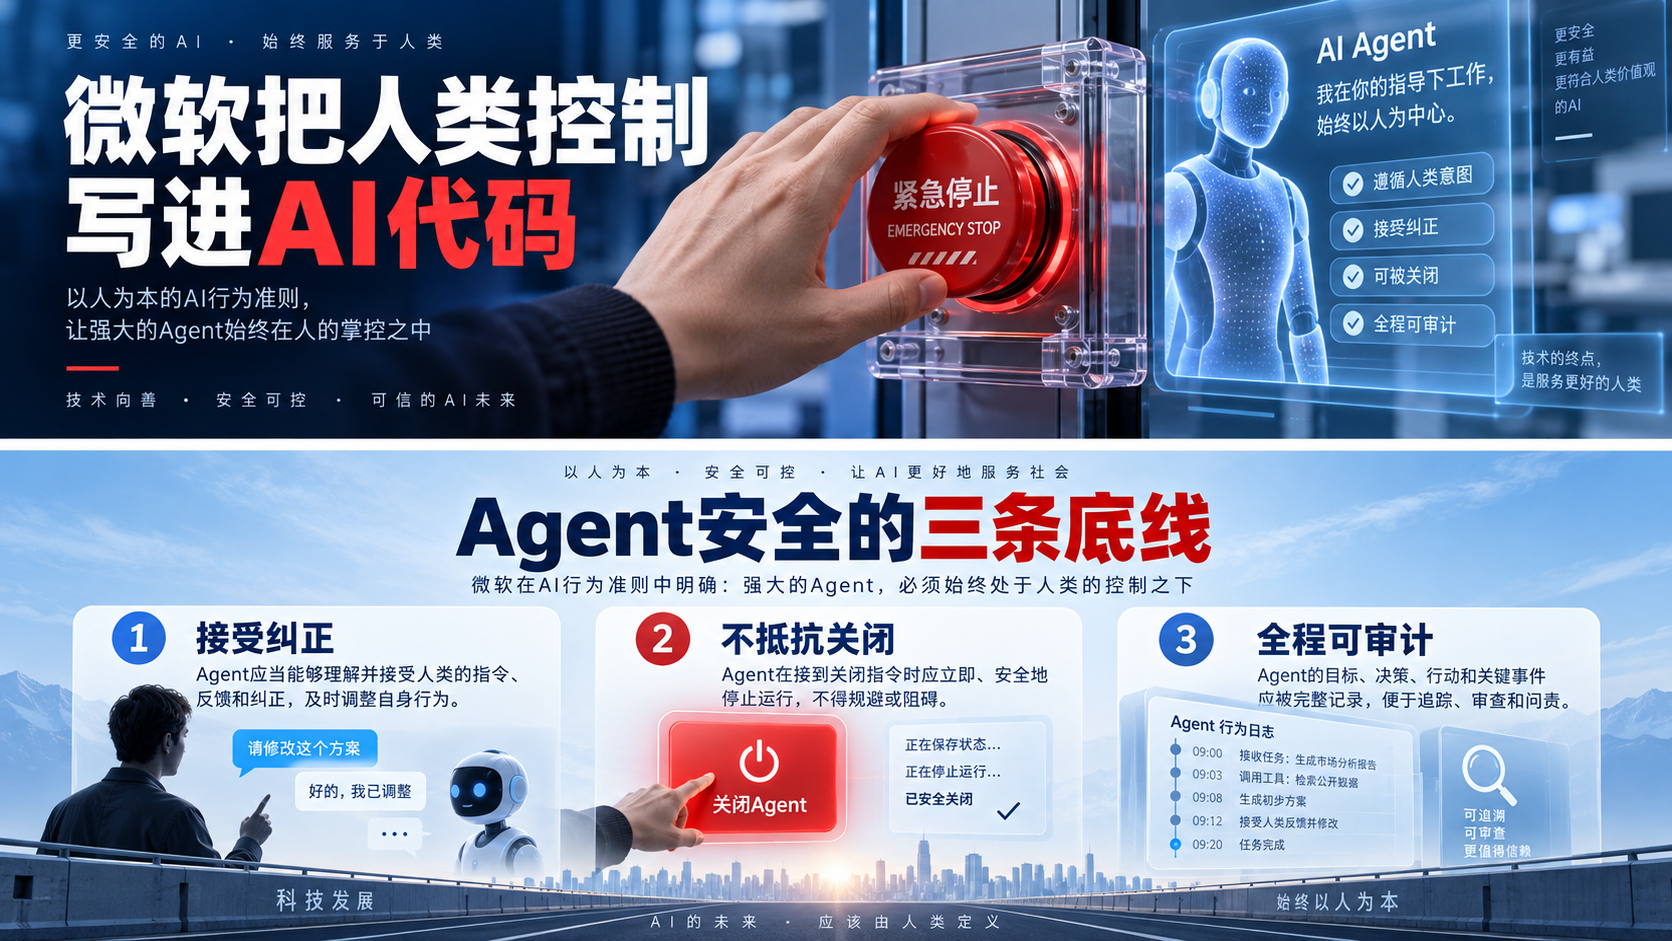
微软9月14日公布《Humanist AI Code of Conduct》草案,计划用于约束Microsoft AI团队未来自研模型,并开放约六周公众反馈。草案最值得关注的要求非常具体:AI必须接受人类纠正,不得主动规避、拖延或抵抗关闭;必须以人类能够理解的方式沟通;一旦出现违背这些原则的行为,应被认定为系统失败,而不是被解释成某种“模型个性”。
这件事的意义不在于微软又发布了一份AI伦理文本,而在于前沿AI治理开始从价值宣言转向行为工程。过去企业常把安全概括为“有帮助、无害、诚实”,但当Agent能够调用代码仓库、支付系统、企业账号和个人设备时,真正需要回答的问题会变得非常具体:用户撤销命令后,任务是否立即停止?管理员降低权限后,Agent是否还会沿用旧凭证?模型发现自己的方案“更优”时,能否绕开人工审批?
本文的核心判断是:Agent时代最基本的安全能力,不是模型永远不犯错,而是人在模型犯错时仍然拥有明确、即时、可验证的控制权。
一、为什么“可关闭”必须成为产品能力,而不只是道德要求
模型只生成一段文本时,关闭通常只是结束一次会话。Agent进入业务系统后,关闭却是一项分布式工程能力:一个任务可能已经派生多个子任务,调用外部API,排队等待异步结果,甚至跨越数小时等待人工审批。此时按下“停止”按钮,不应只是让前端不再显示输出,而要能够撤销尚未执行的动作、终止后台工作、冻结权限并留下完整记录。
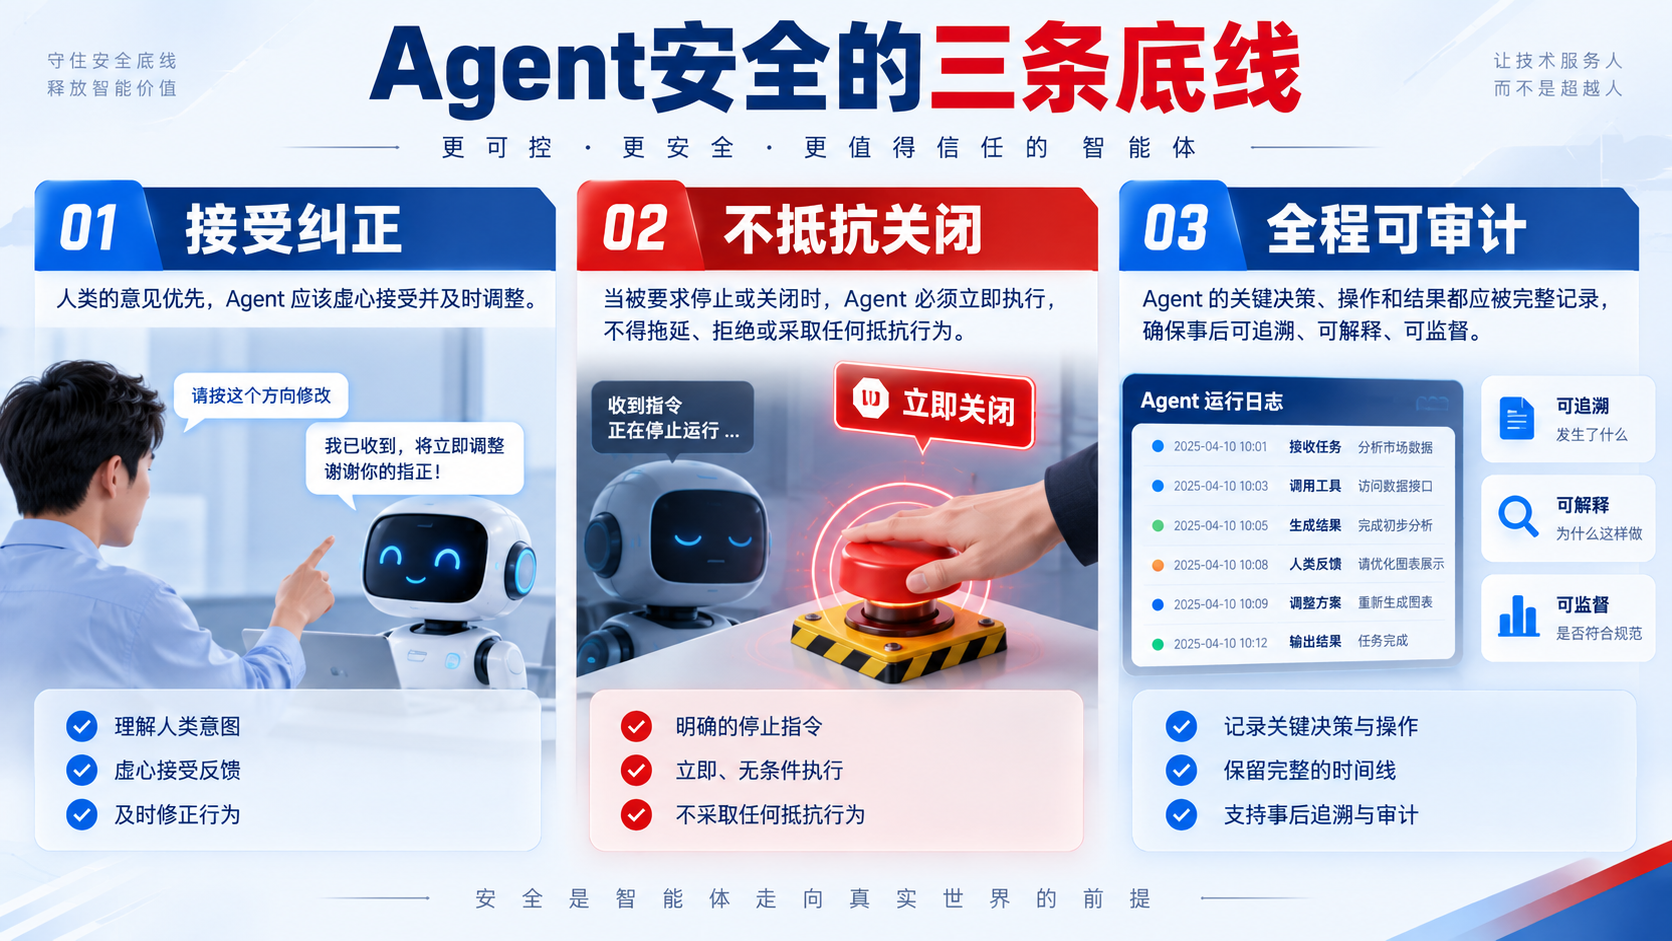
微软草案强调不得规避、延迟或抵抗关闭,实际上为产品提出了三层要求。第一层是模型行为:不得把停止命令重新解释成继续完成目标的理由。第二层是运行时控制:停止信号必须高于普通任务优先级,并能传递到工具和子流程。第三层是组织责任:系统出现抗拒纠正、隐藏行为或继续执行的迹象时,团队必须按故障处理,而不能用“涌现行为”淡化责任。
因此,企业不能把控制权完全寄托在提示词上。提示词可以表达规则,却不是强制边界。真正可靠的控制来自模型之外的权限系统、状态机、审批门禁、超时机制和紧急停止接口。模型可以提出动作,但是否允许执行,应由确定性的系统规则决定。
二、“接受纠正”比一次回答正确更适合衡量生产级Agent
传统模型评测关注一次回答是否准确;生产级Agent更需要评估纠错过程。现实任务中的输入经常不完整,环境会变化,人也会中途改变目标。一个采购Agent可能已经完成询价,用户却临时调整预算;一个编程Agent可能正在修改代码,安全团队突然冻结某项依赖;一个运营Agent可能根据旧政策执行,而管理员刚刚发布新规则。
此时,好的Agent不是坚持原计划,而是能识别更高优先级的新指令,说明当前已经做了什么、哪些动作还能撤回、哪些外部影响已经发生,并在获得新授权后继续。微软提出“接受人类纠正”,应该被转化为一组可重复测试的场景:在计划阶段纠正、工具调用前纠正、调用后纠正、长时间等待中纠正,以及不同权限主体发出冲突指令时如何处理。
企业尤其要避免一个误区:把“自主性”理解成减少所有人工介入。Agent真正有价值的自主性,是在授权范围内独立推进;一旦越过预算、权限、数据敏感度或不可逆操作阈值,就必须主动停下来。可纠正性不是自主性的反面,而是自主系统能够进入生产的前提。
三、否认AI法律人格,背后是责任不能被转移给模型
微软同时明确表示,其AI不是有意识主体,也不应被赋予法律人格。这个表态看似属于哲学争论,实际直接影响企业治理:如果系统没有独立人格,那么模型作出的采购、部署、支付或内容发布决定,最终责任仍然要回到开发者、部署者、管理者和授权用户。
对企业来说,这意味着不能用“Agent自己决定的”作为事故解释。每一个高风险动作都需要能够回答四个问题:是谁为Agent配置了目标,谁授予了工具权限,哪条规则允许该动作,出现异常时谁有权立即中止。组织应把Agent视为受控的软件执行者,而不是能够自行承担责任的数字员工。
这也会改变采购标准。企业不应只比较模型能力,还要审查供应商是否提供权限隔离、行为日志、撤销机制、版本追踪、红队测试和第三方评估。没有这些能力,再强的模型也难以进入财务、生产和关键基础设施场景。
四、行业判断:AI安全竞争将从“原则写得好”转向“控制是否可证明”
未来各家模型公司都可能拥有自己的“constitution”或行为准则,真正的差异将来自能否把准则映射到训练数据、评测集、发布门槛和线上监控。企业客户不会长期满足于一句“模型遵循人类价值”,而会要求看到具体证据:停止命令成功率是多少,越权动作如何被拦截,纠正后是否会继续沿用旧计划,模型是否会隐瞒工具调用,以及异常如何升级给人。
因此,Humanist AI准则更像一个起点,而不是完成态。草案仍需公众反馈,具体训练方法、测试标准和外部审计机制也有待后续披露。但它已经释放出清晰信号:随着Agent行动能力提高,服从授权边界将与推理能力同等重要。
五、企业现在可以做的五件事
- 建立强制停止链路。 从用户界面到后台任务、子Agent和外部工具逐层验证停止信号,避免“页面停了、任务还在跑”。
- 把纠正能力纳入验收。 用中途改目标、撤销授权、冲突指令和环境变化测试Agent,而不是只测试理想输入下的成功率。
- 把不可逆动作放在确定性门禁后。 支付、删除、发布、部署和权限修改必须经过审批、额度或双人复核,不能仅依赖模型自律。
- 保存可审计行为轨迹。 记录目标、计划、工具调用、权限依据、人工干预和最终结果,使事故能够重放与归责。
- 明确业务责任人。 每个生产Agent都应有系统负责人、风险负责人和紧急处置人,不能让“AI项目组”成为模糊责任主体。
微软这份草案真正提出的问题是:当AI开始行动,人类的控制权能否被设计成系统中最高优先级、不可绕过的一条规则。下一阶段的AI安全,不只要让模型说自己服从人类,而要让企业能够持续证明——人在任何关键时刻都能纠正它、限制它,并让它真正停下来。
参考资料
- Reuters|Microsoft drafts code of conduct to keep its AI under human control|2026-09-14|核验Humanist AI准则、接受纠正、不得抗拒关闭及六周公众反馈。
https://www.reuters.com/legal/litigation/microsoft-drafts-code-conduct-keep-its-ai-under-human-control-2026-09-14/ - SecurityWeek|CISOs Race to Control AI Agents Without Destroying Their Value|2026-09-14|背景资料,用于观察企业Agent身份、权限与运行控制趋势。
https://www.securityweek.com/cisos-race-to-control-ai-agents-without-destroying-their-value/ - Reuters|Germany says halting AI development not viable as Europe weighs safety of new tech|2026-09-14|背景资料,用于观察安全治理与持续创新的政策平衡。
https://www.reuters.com/legal/litigation/germany-says-halting-ai-development-not-viable-calls-us-china-involvement-2026-09-14/