一位材料研发工程师想找到更适合高温工况的涂层,真正困难的环节往往不在于查到多少篇文献,而在于让文献里的化学式、材料配比、合成温度、微观组织和性能测试变成可以反复使用的工程数据。下一步还要选择实验条件,安排测试设备,调用模拟程序,把计算出的性能与实际试样对比,最后决定下一批样品如何调整。这个过程涉及文献、实验、仿真和设备,任何一个环节只输出漂亮的文字,都无法替代研发流程的推进。2026年11月16日,NVIDIA在芝加哥SC26大会推出Nemotron for Science,将开放模型、领域数据集、评测、后训练和CUDA-X计算工具组合成一套科学智能体技术体系。这次发布把科学领域的AI产品设计从单个模型推向了一条可以连接真实研发工具的工作链。
NVIDIA官方发布的核心组件包括Nemotron 3.5 Super VL开放视觉语言模型、面向化学推理的LitmusBench v0.2、领域后训练配方,以及可以由智能体调用的加速计算工具。公司介绍,Nemotron 3.5 Super VL和化学数据已在Hugging Face提供,模型也针对128GB内存的DGX Spark进行了本地运行优化。发布会列出的参与机构和企业涉及Argonne国家实验室、RIKEN、Terray Therapeutics、Lila Sciences、Therna等科研和产业团队。它们并非同一个统一的量产产品,而是展示了围绕同一开放模型建立不同专业工作流的方法:有人把论文反应式转换成化学数据,有人生成自动化实验协议,有人将模型用于特定生物医药问题。对于工业研发团队,这种结构与“仿真试验数据组—工业设计智能体组—智能工厂组”的能力组织具有直接对应关系。
从读懂论文到形成可计算的实验对象
许多工程研发团队已经习惯用大模型阅读论文、归纳技术路线,但高价值的信息往往藏在论文中的图表和附录里。例如一个材料合成反应会描述反应物、产物、溶剂、催化剂、温度、压力、持续时间和最终产率;一个零件疲劳测试会同时涉及材料状态、试样尺寸、载荷谱、循环次数和失效位置。知识问答只需要给出一个自然语言摘要,实验数据系统却必须把每个字段映射到明确的单位、关系和来源。研究人员要比较不同论文的结果,就需要知道“40”究竟指40摄氏度、40兆帕还是40小时,某项性能改善来自材料差异还是工艺条件的变化。
NVIDIA列出的Terray Therapeutics案例体现了这条链路。企业对Nemotron进行后训练,使模型能够从科学图示中提取反应物、产物及反应条件,并报告在RxnScribe基准上按照指定匹配标准恢复了约76%的标注反应。这个数字是特定任务和测试口径的结果,工程意义则在于把过去主要由科研人员手工整理的化学反应转换成标准化结构。对于企业材料研发数据库,类似的抽取技术可以把文献中的牌号、成分、热处理参数、力学曲线和显微组织关联到统一的数据模型。形成结构化数据之后,材料工程师才能系统比较不同工艺窗口,智能体也才能调用下游计算程序而不反复重新阅读原文。
工业领域的知识并非只有学术论文。设备说明书、PLM模型属性、实验室LIMS记录、MES生产批次、质量检测报告以及工程师长期积累的Markdown文件,共同构成产品和工艺知识。一个有用的科学智能体必须将这些来源纳入可追溯的对象体系:原始文件保留在企业控制的存储空间,提取后的实体和数值成为检索入口,每条关键结论保留出处、版本和关联试验条件。重点不在建一个巨大的向量数据库,而在让模型能够先定位相关资料,再依据当前任务形成可计算的数据对象。
模型负责组织研究,专业工具负责给出物理结果
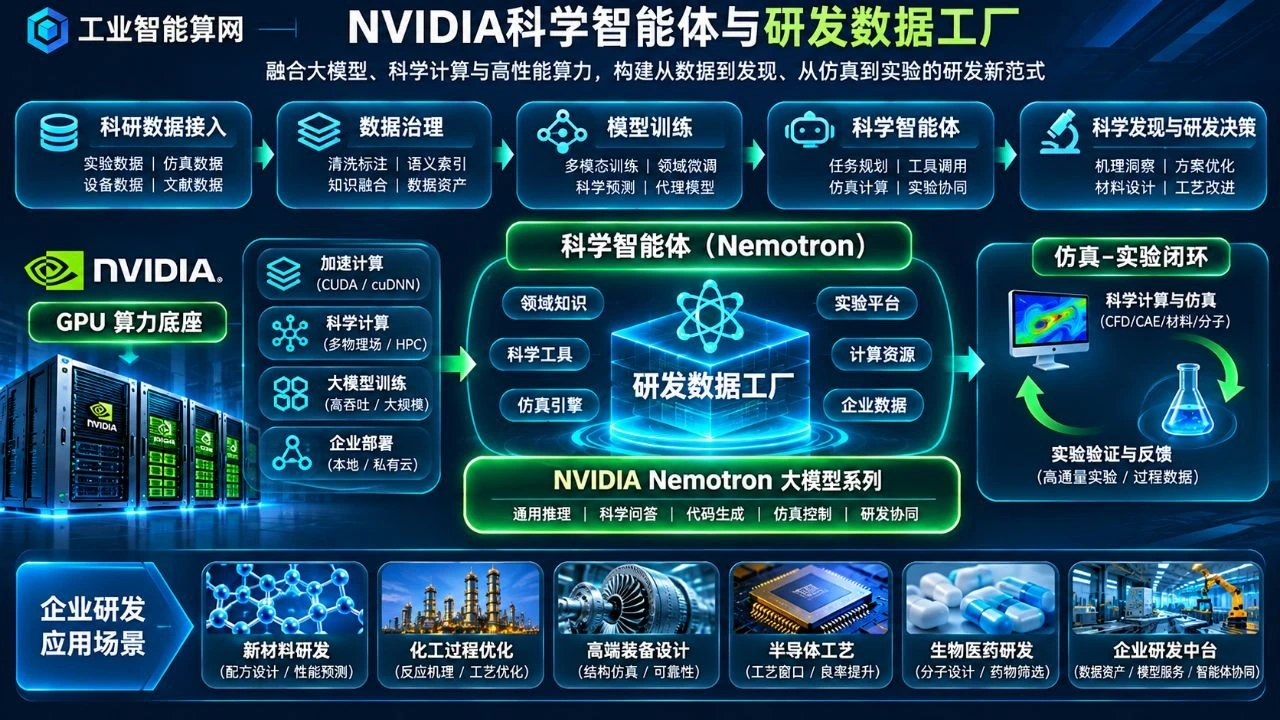
研发问题与普通信息检索的区别,在于很多答案需要通过计算或实验才能得到。流场问题要解Navier–Stokes方程,结构强度分析涉及材料本构和有限元离散,材料相变与微观组织演化需要处理时间、温度及成分之间的多尺度关系。大模型可以帮助提出假设、选择求解器、准备输入卡片和解释结果,却不能仅凭语言生成代替数值计算的物理约束。NVIDIA此次把Nemotron for Science与CUDA-X工具体系并行展示,实际是在产品层面把两种能力连接起来:前者理解研究目标和数据,后者执行高性能计算。
11月16日同时发布的CUDA-X科学计算更新,涉及cuPhoton、cuPotential、cuSpa等组件,覆盖大规模天文数据、分子模拟和单细胞分析。NVIDIA介绍,面向VASP量子计算的Daviator批量GPU内核在其测试工作负载上最高实现22倍加速,相关成本最多降低75%。这些数字属于特定厂商展示的计算配置与测试口径,但这一机制值得工业软件借鉴:当一轮仿真从小时级缩短到分钟级,算法团队就有能力把过去无法承受的大量候选参数纳入自动搜索。智能体可以生成几十种配方或者几何方案,计算平台批量评估,再把结果交给工程师比较,逐渐形成数据驱动的设计空间探索。
在泵阀、换热器、压力容器和电驱动设备等行业,最值得建设的是可复用的仿真任务模板。比如泵的叶轮设计需要指定流量、扬程、转速、工作介质、几何边界、网格策略和湍流模型,计算结果再关联到效率曲线、气蚀性能及试验台记录。一个“仿真工程师智能体”可以读取相似产品的历史模型,提出参数化修改,生成计算任务并调用现有CFD工具;计算完成后,对比实验台的实测曲线,形成结构化偏差记录。长远来看,这些偏差数据又可以用于训练降阶模型或PINN代理模型,在不牺牲真实验证体系的前提下缩短方案筛选周期。
自动化实验室把智能体变成任务协调者
另一条重要线索来自Lila Sciences。NVIDIA发布稿介绍,Lila Sciences使用Nemotron设计能够交给自动化实验室执行的实验协议,随后利用实验反馈对模型进行专业调整。在量子点制备任务中,企业报告后训练后的任务准确率接近翻倍至61%,并给出了与其他模型及推理成本的对比。这个数字来自企业公布的试验体系,值得研究的是其组织方法:模型并非只在聊天窗口回答“应该怎样制备量子点”,而是把目标材料性质翻译成仪器能够理解的参数、操作步骤和检查条件,再让实验结果反过来修正下一轮决策。
材料实验通常包含取样、称量、配液、加热、搅拌、反应、冷却、表征和数据记录等一系列任务。传统研发系统把这些任务拆散在实验记录本、设备软件和数据文件夹里,自动化实验室则需要建立统一的样品身份和过程状态。科学智能体进入其中,可以读取材料目标和历史实验结果,在经过工程规则约束后生成候选实验计划,并将计划转换成设备脚本、作业单与采样安排。仪器执行完成,数据回流至项目数据库,科研人员对结果进行分析与复核。这里的智能体更像一个熟悉实验室业务和工具接口的任务协调者,而不是一个替科学家下最终结论的文本助手。
如果将这一模式移植到工业中试平台,会形成非常有价值的专业能力。中试与实验室小样的区别,不只是生产规模不同,还包括物料传输、混合均匀性、反应热、设备控制和连续运行条件。模型提出的某种配比在烧杯里有效,不代表在连续化设备里具有相同的温度场和反应动力学。中试团队可以把物理仿真、试验台运行、传感器采集和材料表征组织成统一的数据管线,使每次放大都伴随真实的工程证据。对客户来说,这类平台交付的是经过设计、计算、试验和验证的工艺数据资产,而非一次AI演示。
本地化部署的重点是数据、工具和权限一起交付
NVIDIA同时强调Nemotron开放模型可以经过后训练适应具体科学领域,并通过DGX Spark等本地设备部署。对于半导体、精密机械、化工和能源企业,这一点具有实际商业意义:客户通常可以接受公开论文和非敏感材料资料进入外部模型,却需要把CAD几何、工艺参数、产线历史、实验配方以及尚未申请专利的研发成果留在企业控制的环境内。一个工程化科学智能体因此需要把基础模型、企业数据存储、工具调用代理、用户权限和审计日志分开设计。
企业可以采用文件夹与数据库共同管理知识资产:标准文献和公共研究资料通过外部检索补充,本地工程数据通过受控目录、结构化表格和专业系统接口提供;智能体只获得完成当前任务所需的文件范围与工具权限。对于CAD和CAE软件,还要记录使用的软件版本、求解器设置、网格划分、模型参数以及中间产物。这样当计算结果被用于下一轮设计或客户报告时,工程师能够沿着任务链回到原始模型与测试记录。数据不出厂、企业级权限和可追溯报告在此不是宣传口号,而是研发软件和工程服务产品能否被客户长期采用的基础架构。
在具备Teamcenter或其他PLM能力的企业中,可以进一步建立产品BOM、工程变更、材料规范、实验样品和仿真任务之间的关系。科学智能体收到“提高某型设备在高温介质下的运行效率”这样的需求,先确定产品版本和设计约束,再调用材料知识、已有模型和试验结果,最后产生待审核的方案、仿真结果与工程更改草案。整个过程将自然语言入口转化为已有工业软件与研发数据的协调层,也使跨团队的专业劳动从重复查找文件转向更高价值的试验设计和工程判断。
科学智能体的竞争将落在可复制的专业数据资产
从2026年11月16日这轮发布可以看到,科学智能体开始形成几类可以产业化的产品:专业文献与图表结构化服务、面向材料和工艺的领域后训练数据、可调用的物理计算工具、自动实验协议生成、跨设备数据采集,以及研发结果的可追溯管理。每一项能力都可以独立形成软件产品,也可以组合成一个更完整的研发平台。工业软件厂商需要先梳理清楚哪些工艺知识、仿真工具和试验数据可以变成稳定的服务接口。
未来真正有竞争力的研发数据集,也不会仅仅是把海量文件集中存放。它必须同时包含对象、条件、过程和结果:一个零件在什么几何版本下经过何种热处理,在何种载荷和测试标准下得到怎样的性能;一个设备的模拟值与中试验证值相差多少,差异来自参数还是模型假设;一条工艺路线为什么在特定材料批次上失败。智能体越是能把这些专业信息组织成清楚的工程证据,企业积累的数据就越可能转化为可持续的设计、仿真和制造能力。NVIDIA Nemotron for Science提供了一个重要信号:AI正在走向科研工具链的深处,而拥有真实实验条件、专业知识和工程数据的团队,正在获得新的软件产品化机会。
从研发数据集到工业智能算网:一种可交付的实施路径
如果要把上述理念转化为客户能够购买和验收的平台,可以将工程交付分成三个连续层次。首先是针对一个设备族或者材料族建立对象和数据标准,完成CAD模型、材料牌号、工艺参数、试验记录和质量报告的关联,确保每条数据能够找到原始文件和采集条件。其次是对最常使用的专业工具进行服务化封装,例如有限元计算、CFD分析、材料性能拟合、热处理仿真、图像表征和中试设备数据读取,让智能体可以提交任务、获得任务编号、查询进度、下载结果。最后是构建一个面向岗位的工作台,将设计工程师、仿真工程师、材料工程师和质量工程师的任务按照权限组织起来,形成从需求提出到计算验证的连续工作流程。
这种实施方式也改变了项目经济性。传统工业软件项目往往把大量预算消耗在一次性接口和报表开发上,每换一条产线、一个品牌的设备或者一套软件版本,就要重做适配。把仿真和试验能力封装成标准服务后,项目团队可以复用计算模板、数据校验、任务状态和报告生成机制,新增成本更多集中在客户特有的工艺模型与现场连接器。对职业院校与科研机构,同一平台还能形成实验课程:学生根据实际零件提出设计变量,智能体组织求解,仿真结果与实验台架数据对比,最后提交可以追溯的数据报告。这样既支持工业客户,也能支撑教学、科研和区域公共技术服务。
由此形成的工业智能算网不应只被理解为服务器与GPU的集合。算力负责运行模型和数值求解,网络负责连接工程系统和实验设施,智能体负责将人的业务目标翻译为工具任务,而经过中试验证的专业数据则不断增加平台的行业深度。把这些要素作为统一产品设计,才有机会让“科学智能体”成为真正能够在设计、仿真、试验与制造之间工作的数字工匠。
参考文献
- NVIDIA, NVIDIA Introduces Nemotron for Science to Accelerate Discoveries With Agents, 2026-11-16. https://nvidianews.nvidia.com/news/nvidia-introduces-nemotron-for-science-to-accelerate-discoveries-with-agents
- NVIDIA, NVIDIA CUDA-X Libraries Give Agents the Tools to Accelerate Scientific Discovery, 2026-11-16. https://blogs.nvidia.com/blog/cuda-x-libraries-agents-accelerate-scientific-discovery/
- NVIDIA, NVIDIA Expands Vera CPU Platform to Accelerate Scientific Discovery, 2026-11-16. https://nvidianews.nvidia.com/news/nvidia-expands-vera-cpu-platform-to-accelerate-scientific-discovery
- OpenAI, Science at the frontier, 2026-11-16. https://openai.com/index/science-at-the-frontier/