从加州理工、普林斯顿的神经科学实验室,到百度硅谷AI实验室,再到OpenAI与Anthropic——大模型时代一个重要的技术信念,是怎样在语音识别项目里逐渐形成的。
今天提起达里奥·阿莫迪(Dario Amodei),许多人首先想到的是Anthropic、Claude,以及他对人工智能能力增长和安全风险的判断。把时间往回拨十多年,画面却有些出人意料。2014年11月,一个在普林斯顿研究过神经回路、在斯坦福医学院研究过癌症相关蛋白质的年轻科学家,加入了百度位于美国桑尼维尔的硅谷人工智能实验室。他的新工作既不是大语言模型,也不是聊天机器人,而是教计算机听懂人说话。大约一年后,百度发布了《Deep Speech 2:英语与普通话端到端语音识别》,论文署名的最前面就是Dario Amodei。
这段经历今天看起来像是一个巧合:以中文互联网业务起家的百度,在美国建立AI实验室;从物理学转向生物学的研究者,进入工业界研究语音;一场原本为改善搜索输入体验而进行的技术攻关,最终让他对神经网络的规模化能力建立了长期信念。2024年,在Lex Fridman的访谈中,当主持人请他解释Scaling Law的来历时,他几乎没有铺垫,直接从2014年底在百度与吴恩达共事、研发语音识别系统讲起。比起给成功者补写一段充满必然性的传奇,这个亲口讲述的起点更值得仔细追问:他当年究竟做了什么?为什么偏偏是那场语音识别实验,让他看到了后来改变AI产业的一条路线?
一、在成为AI研究者之前,他研究的是真正的大脑
达里奥并不是从计算机科学的标准培养路径走出来的。他早年曾在加州理工学院求学,后来在斯坦福大学完成本科阶段的物理学训练,之后进入普林斯顿大学攻读博士。赫兹基金会的研究者档案显示,他于2007年成为Hertz Fellow,研究生阶段关注生物物理学、神经回路的统计力学以及神经电信号的测量。他的博士论文题目是《Network-Scale Electrophysiology: Measuring and Understanding the Collective Behavior of Neural Circuits》,可以理解为“网络尺度电生理学:测量和理解神经回路的集体行为”。这份题目与十多年后他讨论的大模型,有一种令人回味的呼应:一个复杂系统由大量相互作用的单元组成,研究者能否从它们的集体活动里,找到可观察、可测量的规律?
在普林斯顿,他在Michael Berry教授的研究团队里研究视网膜的神经活动。视网膜当然与视觉有关,但它更是研究神经系统信息处理的一扇窗口:光信号进入眼睛后,大量神经细胞会以电活动的形式编码和传递信息。想知道这些细胞如何协同,仅靠观察单个神经元远远不够,还得尽可能同时记录多个细胞,并用数学模型解释数据。2025年,Alex Kantrowitz在对达里奥及其同事的采访中提到,达里奥对现有测量手段的限制并不满意,因而参与开发新的传感装置,以获取更丰富的神经信号。他的博士工作后来获得赫兹基金会博士论文奖。科学问题在这里与工程能力连在一起:想理解复杂系统,首先要能采集到足够好的数据;数据规模上来了,还需要新的分析手段。
他转向生命科学,还有一段更私人的背景。达里奥的父亲在2006年因长期患病去世。根据他后来在采访中的回忆,相关疾病的治疗方法在此后几年取得了重要进展,时间上的错失给他留下很深的印象。他希望科学进步能够更快地转化为治疗能力,这份急迫感推动他把研究兴趣从理论物理转向生物学。离开普林斯顿后,他来到斯坦福大学医学院从事博士后研究,在Parag Mallick的团队中关注肿瘤相关蛋白质、质谱分析和潜在的癌症生物标志物。面对极其复杂的生命系统,他越来越感受到人类研究者在处理海量关联信息时的局限。在那时,机器学习正在迅速改善图像和语音任务的表现,AI看起来有可能成为突破这种研究瓶颈的工具。
如果仅仅把这段履历理解为“物理学博士转行写代码”,就错过了它真正有趣的地方。他先是在真实的神经系统里寻找集体规律,然后在生物医学里遭遇了数据和复杂度的边界;到了人工神经网络领域,他所熟悉的实验思维终于遇到一项可以快速放大规模的技术。这个转变并不是命中注定,却能够解释为什么他后来如此重视实验曲线,而不只迷恋某个精巧的算法构想。
二、2014年的百度,正在硅谷搭建一支特殊的AI队伍
2014年5月16日,百度宣布吴恩达(Andrew Ng)出任首席科学家,领导包括北京和硅谷实验室在内的百度研究体系。彼时深度学习刚刚经历新一轮突破:ImageNet带来的视觉革命已经引发产业关注,语音识别则依旧高度依赖复杂的专用技术流程。对于拥有搜索、移动输入和庞大中文用户场景的百度来说,让机器更准确地理解自然语言语音,是一项非常具体的业务需求。硅谷实验室因此既要做前沿研究,也要面对真实系统的性能和部署问题。
吴恩达开始招募研究团队时,达里奥并非最典型的候选人。Alex Kantrowitz在2025年的专访中还原了当年的一个细节:吴恩达与达里奥联系后,达里奥申请加入百度;团队成员最初对他的生物学背景有些拿不准,因为他缺少传统机器学习履历。研究人员Greg Diamos看过他在斯坦福时期写的代码后,认为这个人的工程能力非常值得重视,支持聘用他。达里奥最终于2014年11月加入百度。对于今天习惯了把AI研究者简历按大模型论文和排行榜来评估的人来说,这段招聘过程颇有意味:百度当时看中的,不仅是已有的机器学习履历,还有研究复杂问题的能力和扎实的工程实现能力。
他刚加入时,团队也绝非从零起步。2014年12月17日,百度团队已经公开第一代《Deep Speech: Scaling up end-to-end speech recognition》,论文由Awni Hannun等研究人员署名,探索用深度循环神经网络取代传统语音识别流水线中的大量人工设计组件。达里奥并不在这篇第一代论文的作者名单里,这个时间点应当记清。等到2015年12月8日,Deep Speech 2的预印本上线,才出现了他参与、并在署名列表中排在首位的第二代成果。这两篇论文连起来看,才能理解他究竟进入了一支怎样的队伍:深度学习思路已经被验证,接下来的任务是把模型、数据、算力和工程系统同时推向新的规模,并让它在英语之外学会普通话。
三、他在百度到底做了什么?把一个想法推到能工作的规模
传统语音识别长期采用一条颇为复杂的技术链:前端特征提取、声学模型、发音词典、隐马尔可夫模型、语言模型以及诸多针对口音、噪声和说话人的补丁。系统的每一个环节都有专家经验,但环节之间相互依赖;换一种语言、换一种噪声环境,往往又需要大量调整。Deep Speech系列提出的挑战很大胆:能不能让神经网络直接学习从语音信号到文字序列的映射,把原本由工程师手动设计的大量中间步骤交给数据驱动的训练?
Deep Speech 2将这一思路向前推进。它仍然是以循环神经网络为核心的技术体系,而不是今天的Transformer大模型;团队研究了更深的网络、卷积结构、循环层的批归一化、CTC序列训练以及不同的解码和部署方案。技术细节听起来零散,却围绕着同一个目标:让更大模型能够稳定训练,让海量语音真正转化为识别精度,让实验不必因为计算太慢而停顿几个星期。2018年微软研究院为达里奥访谈提供的官方简介,明确称他曾“参与领导”百度开发Deep Speech 2的项目。再结合他2024年对Lex Fridman的回忆,可以比较有把握地说,他参与的重点是大规模深度语音系统的研究,以及模型层数、参数规模、数据和训练计算之间的关系。至于具体某一项算子优化究竟由他个人编写了多少,公开材料并不足以支持给个人精确划分功劳。
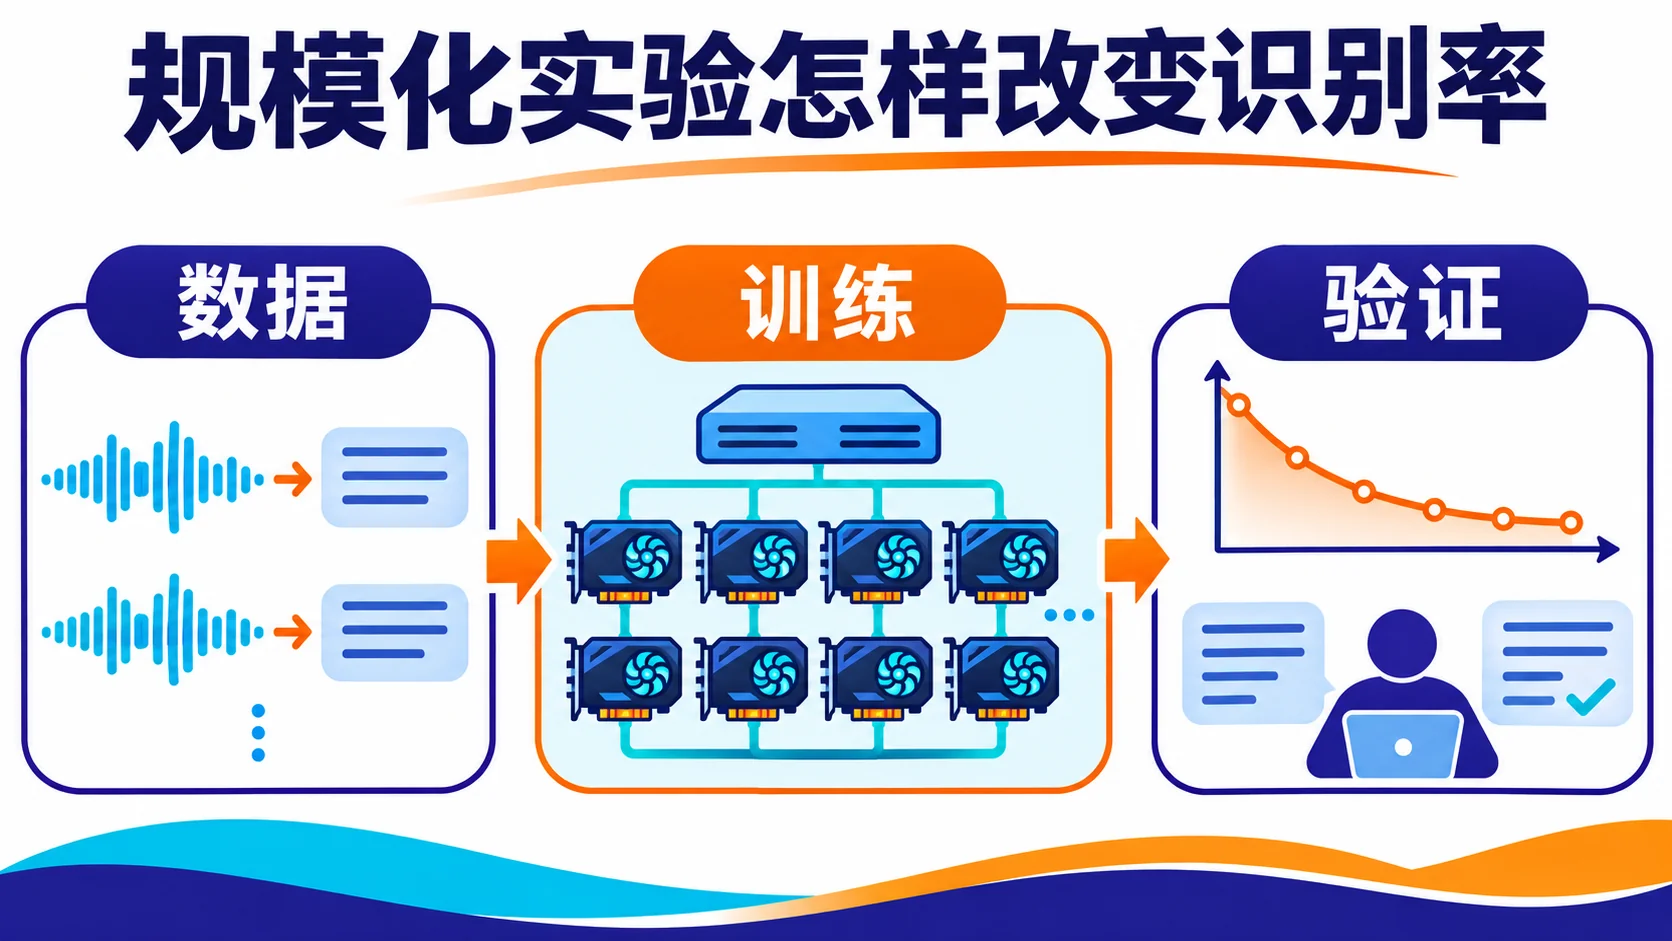
真正令人吃惊的是数据规模。Deep Speech 2长版论文写明:英语系统使用了11,940小时带标注的语音,而普通话系统使用了9,400小时、约1,100万条语音片段。普通话语料来自百度内部数据,包括朗读语音和自然说话语音,也涵盖标准普通话及带口音的普通话。9,400小时是什么概念?如果不间断地播放,也要将近392天;它不是一个研究生在实验室里录几百段句子就能凑出来的数据量。更重要的是,训练样本还得带有可用的文字标注,噪声、片段切分和识别错误都会影响模型学习。论文还写到了如何把较长、标注不够精确的录音对齐、分段、筛选为更适合训练的短片段。规模化首先是一套数据工程能力,其次才是模型参数的竞赛。
硬件同样是关键。团队使用8或16块GPU协同训练一个模型,并优化了训练计算和数据处理流程。论文报告相对于先前系统获得约7倍的计算提速,让部分原本需要数周完成的实验缩短到数天。这里的“7倍”说的是相关训练计算效率改进,不能理解成所有语音识别任务都快了7倍。对于科研团队而言,这种加速比单次跑分更重要:一个月里可以尝试的模型结构、超参数与数据方案多了数倍,研究者就能更快看见规律。实验速度提高,往往也会改变一个团队敢于提出什么样的问题。
还有一个经常被忽略的事实:Deep Speech 2是规模庞大的集体工作。正式会议论文署名数十位研究人员,同时列出百度硅谷AI实验室与北京语音技术团队。作者列表整体接近按姓氏字母顺序排列,达里奥的名字恰好排在很前面,因此不能仅凭“第一作者”三个字,就把中文数据、网络训练和系统优化全部算在他头上。另一方面,微软研究院的2018年介绍确实明确提到他参与领导项目。对他作用的准确描述应该同时保留这两件事:他是重要参与者和领导者之一,Deep Speech 2则是横跨研究、算法、数据与工程的团队成果。
四、9400小时中文语音,真的让模型比中国人听得更准了吗?
这篇论文在中文互联网最容易传播的句子,是“模型识别普通话,比普通话母语者还准确”。原文确实给出了非常醒目的比较,但实验的边界也同样清楚。研究团队挑选了100条随机短语音,让五名人工标注者共同进行转写,人工的字错误率为4.0%,模型为3.7%;另一个比较使用250条随机语音,单名人工转写者的字错误率为9.7%,模型为5.7%。在这些短语音查询测试里,模型表现优于参与对照的人工标注者。到了2015年,这已经是一个足够震撼的工程成绩。
但是,这些数据来自特定的测试集和人工转写流程,样本规模并不大。“超过人类”也不是对所有语言环境的总判断。Deep Speech 2在英语干净朗读语音的一些基准集上表现很好,在复杂口音、真实嘈杂环境中则仍然有明显短板。例如论文列出的CHiME真实噪声测试,模型字词识别错误率为21.79%,而人工为11.84%。把这个结果与中文短语音测试放在一起看,反而更有价值:同一个技术方向已经在部分场景接近乃至超越人类对照组,但模型的鲁棒性、数据覆盖和实际部署依旧决定着边界。科学研究真正精彩的地方,往往就在这种不整齐的进步之中。
为什么当年的普通话识别如此受关注?因为它对一套主要在英语上发展起来的系统提出了不同挑战。普通话书写采用汉字,存在大量同音字和依赖上下文消歧的问题;口音、语速、噪声和移动搜索的短指令场景又增加了困难。Deep Speech 2的价值,并非中文和英语可以用完全相同的一组权重直接解决,而是团队证明了相近的端到端学习框架可以迁移到两种差异很大的语言,在获得足够数据和计算支持后达到很强的识别能力。这比单次“机器赢了人”的宣传更具有长期技术意义。
五、一条不断下降的误差曲线,如何改变他的判断
2024年11月播出的Lex Fridman Podcast第452期,达里奥在开头谈到Scaling Laws时,回忆起他刚到百度的心态。他说,自己那时算是深度学习领域的新人,看到团队在用循环神经网络做语音识别,就产生了一个直觉:如果把网络做得更大、层数加得更多,同时增加训练数据,会怎么样?在他看来,模型大小、数据量和训练量像几个可以独立调节的旋钮。随后团队观察到,随着数据增加、模型扩大、训练持续,识别效果不断改善。他还特别补充,当时并没有对这些规律进行今天这种精密的定量测量,而是一种由反复实验形成的经验判断。
这一点很关键。许多介绍把故事浓缩成一句“达里奥在百度发现了Scaling Law”,听上去就像某天晚上他写下一条公式,随后整个大模型时代按公式发生。他的公开回忆描述的是逐渐形成的经验判断。2014年前后,深度学习业界已经广泛注意到数据、算力和模型容量的重要性,甚至百度第一代Deep Speech论文的标题就含有“Scaling up”。达里奥当时获得的,是对这种方法论的强烈个人确信:在不少复杂任务上,与其始终等待一个天才式的算法跳跃,不如系统地扩大资源投入,观察误差是否继续按照稳定趋势下降。他在访谈中说,那些曲线给他留下了深刻印象,后来才逐渐相信类似规律可能跨越单一语音任务,适用于更广泛的智能能力。
Deep Speech 2论文有直接的数据证据支撑这份体验。在英语模型规模实验中,研究者保持网络深度等条件基本不变,扩大模型宽度。表格显示,同为GRU结构的一个模型,从约1,800万参数增至约1亿参数时,噪声开发集上的词错误率由21.38%下降到14.17%。当然,不同架构下结果并不完全一致,规模增加还伴随着训练和部署成本问题。但看到一条相对平滑、反复出现的改善曲线,对实验科学家来说意味着什么?它意味着下一次实验的方向能够被预期,算力和数据的投资可以开始依据经验规律进行规划,研究正在从“偶然撞上一个好模型”向“可重复地改进模型”移动。
这种研究习惯,和他早年在普林斯顿的经历或许存在一种方法论上的延续。在神经科学实验室里,理论可以很漂亮,但最终必须靠电信号测量和统计关系说话;到了百度,关于人工神经网络能否变强的争论,同样可以通过扩大样本、增加计算并画出实验曲线来推进。不同的是,真实大脑不能随意增添几千万个神经元做对照实验,人工神经网络却可以在GPU上重复构造和训练。AI研究的可扩展性,在某种程度上让这位从生物物理学转行的研究者,找到了格外适合自己的实验空间。
六、从百度的经验直觉,到2020年写成公式的Scaling Law
故事并没有在2015年结束。2017年,百度研究人员Joel Hestness、Sharan Narang、Greg Diamos等发表《Deep Learning Scaling is Predictable, Empirically》,对机器翻译、语言建模、图像处理和语音识别中的规模规律进行经验分析,指出泛化误差与训练数据规模之间在多个任务上存在幂律关系。这篇论文很值得放进同一条技术史中,因为它说明百度实验室关于规模化的经验并不是只留在某个人的记忆里,而是有研究者继续把它变成系统性测量。不过,达里奥并不在这篇2017年论文的作者名单中,不能把它写成他的个人成果。
达里奥此时已离开百度,短暂加入Google Brain,随后进入OpenAI。Transformer在2017年提出,OpenAI于2018年公开第一代GPT研究;语言数据规模、预训练和可并行计算的结合,给他此前在语音领域形成的判断打开了更大的舞台。2024年的访谈中,他把自己从2014年到2017年前后逐渐形成的认识描述为一个过程:起初以为“大模型加更多数据”或许只是语音任务的特点,后来逐渐相信语言模型也能够沿着类似道路不断改善。这里需要保留一个时间细节:他回忆自己在2017年接触早期GPT-1相关结果,而GPT-1的正式公开发布是在2018年。回顾性访谈与论文公开日期应分别理解,不能用前者改写后者。
到了2020年1月,OpenAI正式发布《Scaling Laws for Neural Language Models》,作者包括Jared Kaplan、Sam McCandlish、Tom Henighan、Tom Brown、Alec Radford和Dario Amodei等。论文研究了语言模型损失与参数数量、数据规模、训练计算量之间的经验幂律关系,并讨论在给定计算预算下怎样分配模型规模和数据。这时,早年在百度语音识别项目里通过反复试验形成的直觉,才与更明确的数学拟合和计算预算分析接上了轨道。它不是达里奥一个人发明的理论,也不是百度某个项目能够独占的发现,却确实构成了他个人技术思想的一条连续线索:从语音识别的经验曲线,到语言模型的可预测增长,再到大模型成为巨额算力投资的中心。
Scaling Law本身也并非“只要无限堆GPU,智能就会无限增长”的保证书。训练数据质量、模型架构、优化算法、推理预算、任务环境和评测方式都会影响结果;实验中观察到的幂律关系存在适用区间,超出区间后的表现需要新的证据。行业后来围绕数据与计算的最优配比进行了大量修正和补充。真正值得继承的不是对规模的盲目信仰,而是一套更有纪律的研究方法:在足够宽的实验范围里测量性能变化,判断瓶颈来自模型容量、数据、计算还是算法,再用连续的证据决定资源应投向何处。
七、从Google Brain、OpenAI到Anthropic:他越来越相信力量,也越来越在意风险
离开百度后,达里奥先在Google Brain担任研究科学家,随后于2016年前后加入OpenAI。他在谷歌时期已开始参与AI安全相关研究,后来在OpenAI领导安全工作,并逐渐走到语言模型研究的核心位置。2017年的《Deep Reinforcement Learning from Human Preferences》探索如何用人的偏好反馈指导强化学习;2019年的GPT-2和2020年的GPT-3则让预训练语言模型的通用能力越来越直观。OpenAI在2020年12月发布的组织公告明确提到,达里奥将离开研究副总裁岗位,他此前参与领导GPT-2、GPT-3研究,并与Ilya Sutskever共同制定研究方向。
2021年,他与妹妹Daniela Amodei及其他研究人员共同创办Anthropic。公众往往把达里奥的两种形象放在一起:一方面,他高度相信模型扩展会带来强大的能力;另一方面,他不断强调对这种能力进行解释、评估和控制。表面看上去有些矛盾,从经历中却能够看到一条相当自然的逻辑。如果你亲眼见过性能随着规模扩展而持续改善,又认为这种规律可能通往远超过今天水平的系统,那么如何避免模型伤害现实世界,就不可能是临时补上的公关议题。个人经历无法独自解释一家公司全部的安全理念,但百度时代的规模化经验,显然构成了他理解未来AI能力的一部分。
也正因此,我们今天回头读Deep Speech 2时,看到的不只有一个早期语音识别技术成就,还能看见现代AI产业结构的一些雏形。模型研究与数据工程被放进同一体系;训练计算效率影响研究速度;跨地域团队共享数据、算法与基础设施;实验结果不再只是学术论文里的数字,还需要考虑在线服务的成本和时延。这些问题到了大模型时代依然熟悉,只是规模从几块、十几块GPU,扩大到了前所未有的计算集群。
八、百度那一年的产业遗产
今天围绕大模型的叙事经常聚焦在少数科技公司和明星创业者身上,十多年前的百度硅谷AI实验室反而容易成为人物简历上的一行小字。实际上,那是一个值得认真书写的交汇点:美国顶尖高校培养的跨学科研究人员、吴恩达带领的深度学习团队、北京与硅谷之间的语音技术协作,以及中文互联网巨大的业务数据场景,共同推动了一套新的工程方法成熟。中文语音数据在其中发挥了很实际的作用,它使研究者能够检验端到端模型在不同语言上的泛化能力,而不是只在英语测试集里取得成绩。
这段历史还有一种更现实的启发。产业界常常把突破想象成某个神奇算法的诞生,却忽略了能够让思想发挥作用的组织条件。没有大规模可标注的语音数据,研究者很难知道模型变大之后是否继续受益;没有稳定、高效的GPU训练系统,实验迭代慢得足以让人丧失耐心;没有同时理解研究和工程的团队,即使学术指标提高,也未必能把模型部署给真实用户。Deep Speech 2研究语音识别,也展示了数据、算力、算法和工程组织之间如何相互促进。
我们也不必把历史写得过于戏剧化。达里奥不是某个偶然闯入百度的天才,凭一个人发现了整个大模型时代的秘密;百度也并没有在2015年提前造出今天的Claude。更准确的故事反而更精彩:一位在神经科学里训练出的实验研究者,进入了一个正在快速扩大数据与计算规模的语音项目;他和同事们看见神经网络性能沿着可观察的方向持续改善;此后的十年里,这种认识被不同团队反复检验、量化、修订,并逐渐改变了人工智能产业对研究投入和技术进步速度的预期。
回到2014年11月的那个节点,达里奥当时面对的只是一项足够具体的工作——让机器在各种口音、噪声和语言环境里,更好地听懂人类。谁也无法从那间实验室里直接推演出后来的一切。但有时推动一场技术革命的早期证据,并不诞生在最宏大的命题里,而是藏在一个工程师反复画出的错误率曲线中。对达里奥而言,百度的那一年或许让他更加相信:人工智能能力的进展,可以通过可测量、可重复、可扩展的工程过程来观察。
这个信念并不只属于达里奥,也不只属于硅谷。它曾经在一支有中国互联网公司背景的国际化研究团队里,被大量中文语音、数十位研究者和持续运行的GPU反复检验。重新认识这段历史,正好提醒我们:真正改变产业的突破,常常既有实验室里的思想,也有数据中心里不眠不休的工程。
参考资料
- Lex Fridman Podcast #452, Dario Amodei: Anthropic CEO on Claude, AGI & the Future of AI & Humanity,2024年。访谈中03:14起讲述在百度研究语音识别及Scaling的早期经验:https://lexfridman.com/dario-amodei-2/;全文转录:https://lexfridman.com/?p=6075。
- Dario Amodei,个人官网(教育及职业经历):https://darioamodei.com/。
- Hertz Foundation,Dario Amodei, PhD(本科、普林斯顿博士及论文题目、斯坦福医学博士后):https://www.hertzfoundation.org/people/dario-amodei/。
- Alex Kantrowitz,The Making of Dario Amodei,Big Technology,2025-07-29(采访本人、导师及百度同事,含2014年11月入职细节):https://www.bigtechnology.com/p/the-making-of-dario-amodei。
- 百度投资者关系公告,Baidu Opens Silicon Valley Lab, Appoints Andrew Ng as Head of Baidu Research,2014-05-16:https://ir.baidu.com/news-releases/news-release-details/baidu-opens-silicon-valley-lab-appoints-andrew-ng-head-baidu/。
- Awni Hannun 等,Deep Speech: Scaling up end-to-end speech recognition,2014:https://arxiv.org/abs/1412.5567。
- Dario Amodei 等,Deep Speech 2: End-to-End Speech Recognition in English and Mandarin,arXiv,2015-12-08;ICML 2016。9400小时中文数据、1100万条语音、模型规模与人工测试见原文:https://arxiv.org/abs/1512.02595;会议版:https://proceedings.mlr.press/v48/amodei16.html。
- Microsoft Research,Fireside Chat with Dario Amodei,2018-09-10(明确称其参与领导Deep Speech 2项目):https://www.microsoft.com/en-us/research/video/fireside-chat-with-dario-amodei/。
- Joel Hestness 等,Deep Learning Scaling is Predictable, Empirically,2017-12-01:https://arxiv.org/abs/1712.00409。
- OpenAI,Improving language understanding with unsupervised learning,2018-06-11(早期GPT公开发布时间):https://openai.com/index/language-unsupervised/。
- Jared Kaplan 等,Scaling Laws for Neural Language Models,OpenAI,2020-01-23:https://openai.com/index/scaling-laws-for-neural-language-models/。
- OpenAI,Organizational update from OpenAI,2020-12-29(达里奥离任及其GPT-2/GPT-3研究职责):https://openai.com/index/organizational-update/。
说明:文中人物思想发展的关联属于基于公开访谈、论文和履历的评论性分析;个别科研动机和情绪变化不应理解为对个人内心的直接事实认定。