工业智能前沿技术深度解读|2026年10月26日
核心论文:Microstructural Generative Inverse Models for Additive Manufacturing Digital Twins(arXiv:2610.30404,2026年10月21日提交)
关键词:增材制造、晶体塑性、扩散模型、微观组织、逆向设计、不确定性量化
摘要
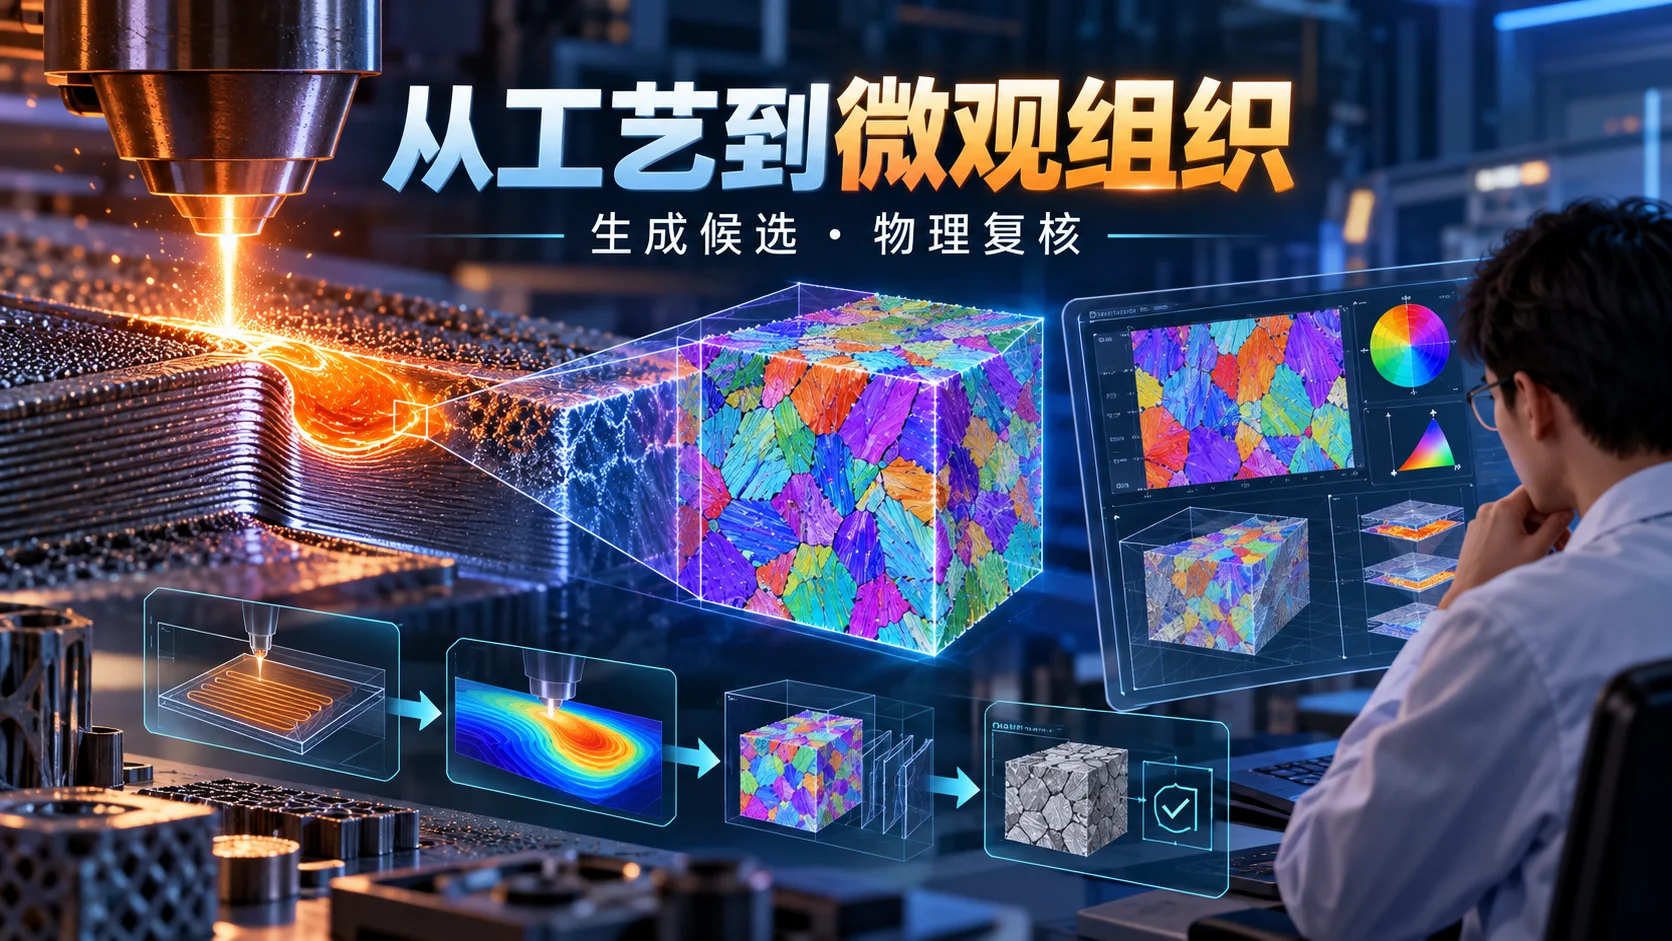
金属增材制造能做出复杂构件,零件长期服役是否可靠,却要看组织、缺陷、残余应力和工艺历史。近期一项研究用去噪扩散概率模型(DDPM)学习晶粒形貌和晶体学织构,再用无分类器引导(classifier-free guidance,CFG),按工艺条件或目标性能生成候选组织。这给“工艺—组织—性能”建模增加了一个概率抽样工具。二维切片的信息缺口、晶内取向伪影和相互冲突的条件也随之显现。工业软件要用好它,仍需把生成、物理筛选、预测区间与试验追溯接进集成计算材料工程(ICME)流程。
一、为什么增材制造的难点仍在材料组织层
激光粉末床熔融、电子束增材制造及定向能量沉积等工艺的共同特点,是材料经历局部熔化、快速凝固和复杂的热循环。层间重熔和扫描路径会改变晶粒生长方向,产生柱状晶、等轴晶、择优取向和空间上高度非均匀的组织。即使两件零件的外形与名义合金成分完全相同,只要能量输入、扫描策略和局部散热条件不同,其弹性响应、屈服行为、疲劳寿命和裂纹扩展特征就可能显著不同。因此,高端装备的难题常常落在性能证明和过程一致性上。
传统流程依赖金相、电子背散射衍射(EBSD)、拉伸、疲劳及断裂试验建立统计规律。工程人员需要知道制造波动对应的性能分布;一张“典型组织图”给出的单点结果不够。大型构件、不同空间位置、不同批次与不同机台形成了高维组合空间,逐一制样和测试的成本无法随组合数线性扩张。ICME通过热过程计算、组织演化、晶体塑性有限元(CPFEM)与宏观结构分析连接不同尺度,但其可信度又受制于输入的代表性体积单元(RVE)是否足够真实和多样。
Neper、DREAM.3D一类传统重构工具通常要求使用者先指定晶粒尺度、长宽比、取向分布或相关函数,再构造满足这些摘要统计量的组织。这类重构透明、可控,但有限的统计量可能遗漏晶粒之间的空间关联、局部异常和多峰分布。生成式模型试着学习组织样本的联合概率分布,让工程师在不逐项指定几何细节的情况下取得一组候选。
二、论文的数据链条:exaCA、EBSD表征与CPFEM如何衔接
模型的主要训练数据来自细胞自动机工具exaCA生成的、带晶体取向信息的数值组织,并非大规模真实打印件的显微照片。作者使用六组与工艺参数相对应的代表性体积单元,原始数据尺寸约为401×401×577;在此基础上随机截取1500个64³子体积,并通过晶体取向同步旋转和图像增强扩充变化。模型训练输入是64×64的XY二维截面,每个像素以三个欧拉角表示晶体取向;输入形式类似三通道RGB图像,每个通道在这里却承载取向信息。
性能标签取自三维晶体塑性计算。论文对64³离散结构实施沿Z方向的单轴载荷模拟,设置应变率5×10^-3 s^-1,累计到约5%的应变,并提取有效弹性模量与屈服强度,再将这些宏观属性关联到相应的二维组织切片。这样构成了工艺类别、组织形貌、织构统计量以及力学性能之间的训练联系。三维RVE的整体性能被赋给对应的二维截面。这种弱配对便于训练,但单张切片无法完整呈现决定力学性能的三维结构。
论文将纹理信息编码为20维广义球谐系数相关特征,将工艺条件表示为6维one-hot变量,力学条件为包含屈服强度与弹性模量的2维向量;形貌信息则保留64×64的两点空间自相关表征。模型因此能够接受“指定工艺”“指定强度与模量”“指定晶粒统计形貌”等不同条件,甚至同时输入多个条件。相比“细晶、强度高”这样的文字要求,这些条件能以明确的数值或结构输入计算。
三、扩散模型怎样从性能目标反推组织
DDPM的基本思想是在训练阶段逐步向真实组织数据添加高斯噪声,训练一个网络根据带噪状态、时间步与条件信息预测去噪方向;推理阶段从随机噪声出发,连续应用反向转移,最终得到一张可能的组织表示。论文使用U-Net作为去噪主干,给出的扩散时间步数为1000,条件经向量和空间特征网络投影后注入多个U-Net层。论文列出8块A100 GPU、批量32、学习率10^-4、条件丢弃率20%及80/20的数据划分。复现该原型还要考虑训练资源与数据管理。
无分类器引导的价值在于,同一模型既学习带条件的去噪方向,也学习不带条件的方向,推理时通过引导权重调节“满足目标”和“维持合理分布”之间的比例。写成概念式为:
[
\hat\epsilon=\epsilon_\theta(x_t,t,\varnothing)+w\left[\epsilon_\theta(x_t,t,c)-\epsilon_\theta(x_t,t,\varnothing)\right]
]
其中,$c$代表工艺、组织或性能约束,$w$代表引导强度。提高$w$能够促使生成结果更接近指定条件,但过度引导可能使样本集中在少数形态、损失分布多样性,甚至降低真实性。论文在工艺条件实验中观察到,引导权重增大初期FID改善,到约$w\approx2$附近后继续增加反而使指标恶化。调节引导权重时,目标性能、制造可达性和训练数据中的组织分布会互相牵制。
“性能→组织”也不同于常规监督回归。给定相同弹性模量和屈服强度,可能存在多种织构、晶粒排列和热处理历史;如果只输出一个平均组织,往往会失去物理意义。扩散模型能够从条件概率分布中抽样形成一组候选,再通过CPFEM等物理求解器复核每个候选,估计同一目标条件下的多样性与风险。材料设计因而更适合检查一组经复核的候选,而非只拿一张“最优图”。
四、实验指标说明了什么,又没有说明什么
论文比较了生成与参考组织的晶粒形貌、空间相关性及晶体学织构,并对条件生成设计不同目标。形貌引导实验能够区分柱状晶和等轴晶等结构特征,但其投影到主成分空间后的结果仍存在明显散布。作者在五组不同目标上分别生成候选样本,还利用每个工艺条件的大量样本进行类别内FID比较。FID基于自然图像的Inception特征,衡量的是图像分布相似性;晶界是否符合物理规律、组织能否制造、断裂性能是否一致,须另行检查。
力学性能条件生成呈现了一个值得深究的现象。对于所研究的面心立方晶体织构,沿特定加载方向,接近<001>与<111>的晶体取向通常对应不同的弹性和塑性响应。论文观察到,随着给定性能条件改变,生成组织的主导织构也发生变化,提示模型学到了部分组织与性能的关联。但这一关联仍是通过数值组织和特定载荷路径学习得到的,尚不足以推导到任意合金、复杂多轴载荷或真实工厂工艺。
论文同时主动展示了失败案例。生成组织中出现了训练数据原本没有的晶粒内部连续取向渐变,这与扩散网络处理连续数值图像的方式有关;而当用户指定互相不相容的织构和力学性能条件时,模型可能优先满足织构、牺牲力学性能条件。模型在训练数据所覆盖的关联范围内生成,无法代替守恒方程、热力学相图或力学验证。它适合提供待检查的候选,认证结论仍需独立证据。
五、材料数字孪生真正需要的是概率闭环
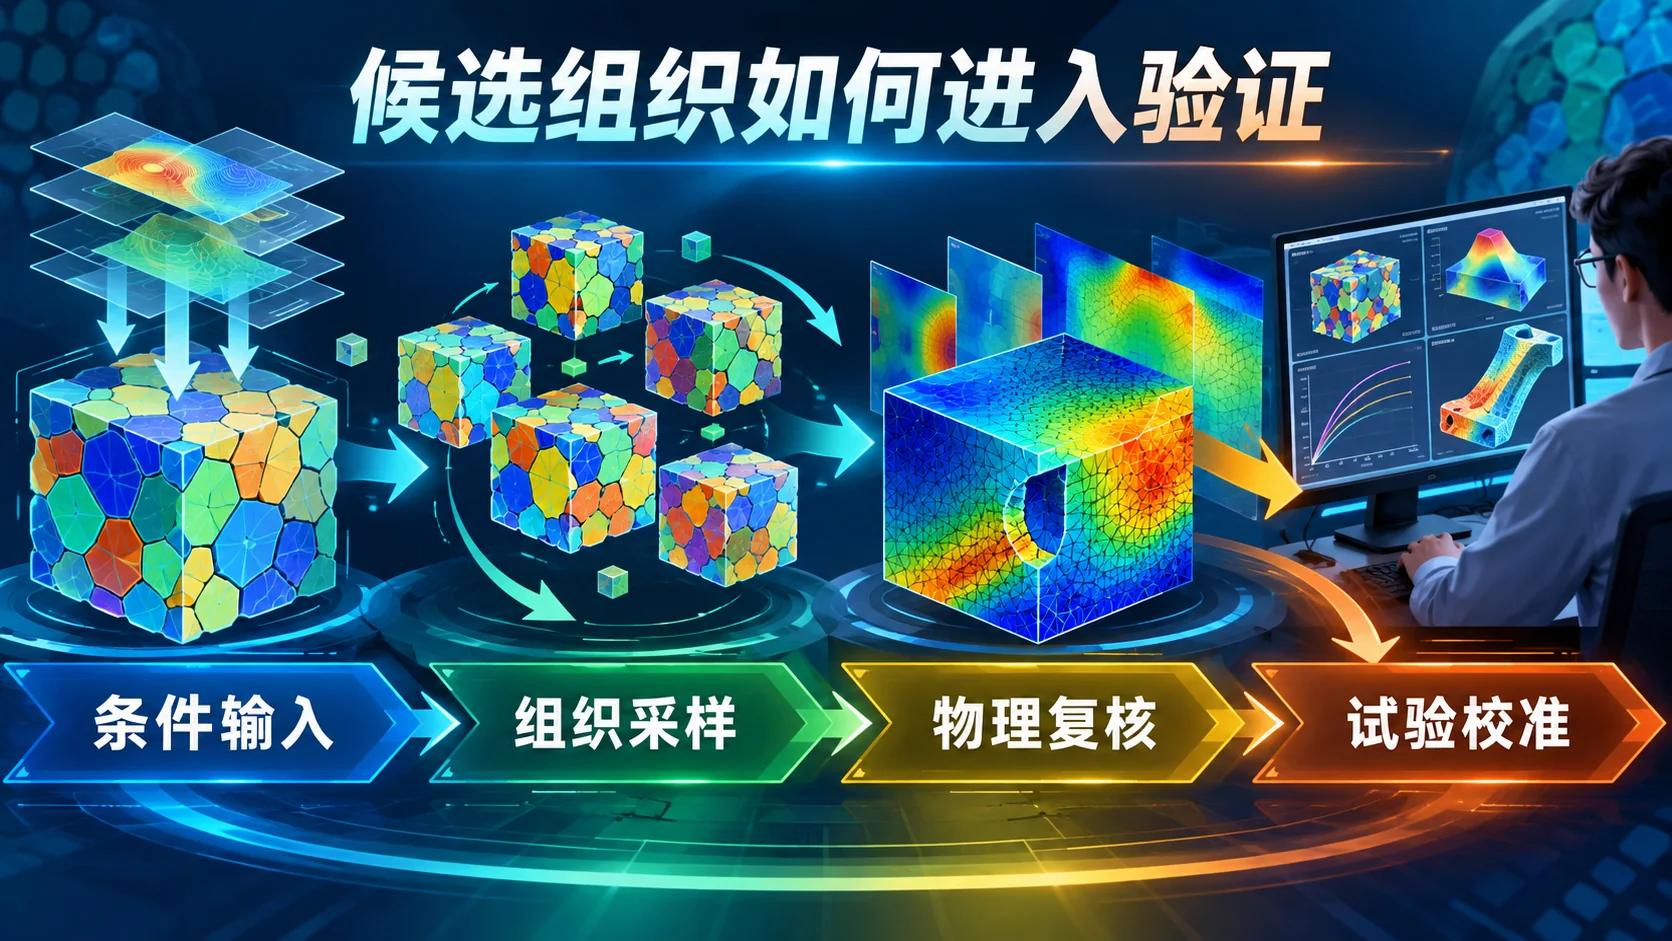
工业现场可把流程拆成六个环节:首先从设备获取激光功率、扫描速度、道间距、铺粉厚度和温度等制造履历;然后把这些记录映射为有版本标识的工艺特征;第三步生成符合工艺条件的组织候选集合;第四步用CPFEM、均匀化算法或训练良好的性能代理计算候选性能;第五步根据少量真实金相和力学试验对预测分布持续校准;最后将工艺窗口、失效边界和可信度反馈到工艺规划或质量审查。每一步都要保留构件编号、材料批次、设备、工艺配方及模型版本。缺少这条记录链,后续就难以追查某张组织图对应哪一次制造。
不确定性至少包括制造过程波动、模型参数不确定、数据覆盖不足和试验测量误差四类。若对每一个候选组织直接给出一个屈服强度数值,而没有样本方差、置信或预测区间、超出训练分布的检测,以及来自物理求解器的交叉验证,工程审查便难以判断这些数值有多可靠。一个可实施的试点可先聚焦同一合金、同一打印工艺和有限机台,选定弹性模量及屈服强度为起步指标,在确认组织抽样质量和重复性后再延伸到疲劳、蠕变与损伤。由简单性能到复杂寿命指标的推进顺序,也更符合认证证据形成的成本规律。
六、面向工业智能软件的工程化设计
从产品架构看,微观组织生成服务可独立于求解器部署,输入规范化的工艺和目标条件,输出组织场、统计描述、随机种子、模型版本及质量检查报告。计算服务随后调用DAMASK或其他CPFEM计算任务,完成网格适配、边界条件加载、后处理与结果回传。知识库用于管理合金牌号、晶体结构、材料本构参数、试验标准和历史工艺窗口;工作流引擎则管理“生成—评价—筛选—复验”的多轮过程。候选量一大,缓存已计算的RVE、挑选代表性样本和分层使用代理模型,就会影响每次迭代的成本。
数据治理还得记录文件之外的约定。应将晶体取向角的单位和约定、参考坐标、体素尺度、晶界阈值、样本切分、训练验证划分规则与工艺标签建立固定模式,并记录数据是否源于仿真、真实EBSD还是混合标注。对于由同一个三维RVE裁出的多张二维切片,随机按切片拆分训练集和验证集可能造成数据泄漏,进而夸大泛化能力。更稳妥的独立验证应按工艺配方、原始RVE甚至设备批次隔离,最终接受跨批次的盲样试验。
系统还应设置“拒绝生成”和“需人工审查”两种状态。当请求落在训练工艺窗口之外,或者指定的目标性能组合与已知物理关系冲突时,系统应给出可追踪的告警、备选条件和需要追加的实验,避免把超出能力范围的请求包装成一张貌似合理的组织图。材料认证涉及法规、工艺资格和数据可追溯性,生成模型可以帮助缩减实验搜索空间,却不能自行宣布某种材料已经合格。
七、进一步发展的研究路线
当前研究以二维取向图像作为扩散目标,但实际裂纹萌生、晶粒连通、孔隙聚集和晶界网络都是三维问题。下一步可尝试三维取向体素生成,或在分层生成中约束切片之间的连续性;同时把晶体对称性与周期角表示引入网络,减少欧拉角空间产生非物理渐变的可能。更进一步,可在采样后引入晶界拓扑修复、相场演化以及局部热力学筛选,使生成结果从“统计上像组织”逐渐接近“物理上可解释的材料状态”。
近期更可行的用法,是在已有工艺窗口内生成统计上等价的组织,改进少样本下的性能分布估计,再借助主动学习选择值得制样的工况。直接自动寻找最优打印参数,还需更多验证。如果能够证明在相同置信水平下减少了物理仿真调用或实验批次数,便能形成可验证的投入产出关系。反之,若生成器的训练和验证成本已经超过传统统计重建,其工程收益就需要重新评估。
结语
论文把工艺条件、织构、形貌和部分力学性能放进同一生成框架,并用诊断指标观察到条件冲突和不合理组织。眼下适合在ICME平台中试用的,是概率RVE生成与逆向设计:给定条件、生成候选、交给物理计算和试验筛选。材料资格认证还需三维组织、真实试验数据、物理一致性检验及独立复现。
参考资料
- Falcon, P. L. 等,Microstructural Generative Inverse Models for Additive Manufacturing Digital Twins,arXiv:2610.30404,2026。https://arxiv.org/abs/2610.30404
- arXiv HTML全文(方法、实验参数、条件生成与研究局限)。https://arxiv.org/html/2610.30404
- DAMASK,晶体塑性与材料仿真平台。https://damask-multiphysics.org/
- DREAM.3D,材料组织数字表征与合成工具。https://www.dream3d.io/
研究状态:截至2026年10月26日,论文为预印本;材料认证是后续应用方向,尚无行业认证结论。