一家团队训练了两年的语音模型,代码写在 PyTorch 上,推理服务接着现成的部署工具。云平台提供另一种加速器,看上去单位算力更便宜。工程师把模型权重搬过去,却发现真正消耗工期的是算子行为、编译时间、分布式通信、性能分析和上线后的故障排查。采购价再有吸引力,若迁移占去一个季度,账也未必划算。
10月19日,亚马逊介绍 TorchNeuron,拟于10月20日 PyTorch Conference North America 将它作为 Apache 2.0 开源项目公开发布,并提供公开测试版。PyTorch 官方博客也在同日给出技术细节:它是面向 AWS Trainium2 与 Trainium3 的原生 PyTorch 后端,利用 PyTorch 的 PrivateUse1 扩展机制,把硬件注册成 neuron 设备,支持即时执行、torch.compile 与标准分布式接口。[1][2] 它降低的是已有 PyTorch 程序迁往 Trainium 的框架适配成本;对仍依赖 CUDA 专有内核的程序,企业要逐项核算另行改造的工期。
从换一行设备名,到完整跑通业务
PyTorch 官方文章给出很直观的示例:model.to('neuron') 指定设备;已经按 torch.accelerator 写成设备无关形式的程序,框架层代码甚至不必为设备切换再改一遍。[2] 对训练人员来说,模型定义、优化器和常见张量操作可以保留熟悉的写法,调试时也可先用 eager 模式逐步运行。这个入口降低了试用门槛,却只解决了“程序怎么开始跑”的问题。实际系统还有数据读取、算子覆盖、数值精度、保存检查点、批量推理、监控报警等环节。
TorchNeuron 并非 Trainium 第一次支持 PyTorch。AWS Neuron 的历史文档区分了2019年面向 Inferentia 的 torch-neuron、2022年以来基于 PyTorch/XLA 的 torch-neuronx,以及此次强调原生接口的 TorchNeuron;文档还称后者在2025年已有初始版本。[3] 包名 torch-neuronx 在新旧实现中沿用,迁移项目不能凭包名推断自己正在运行哪条后端路径。审查 Python/PyTorch、Neuron SDK、驱动、实例型号和编译器版本,应成为试用前的第一项工作。
硬件范围同样具体。PyTorch 与亚马逊发布材料写明新后端面向 Trainium2 和 Trainium3。[1][2] 旧训练集群若是 Trn1,或者推理服务落在 Inferentia,不能直接把此次宣称的兼容性套上去。开发者还应检查存储、网络和跨节点通信:本地单卡脚本可以启动,只说明迁移迈出了第一步;上百卡训练和高并发服务需要独立验收。
两种运行模式,适合不同的工作阶段
原生 eager 模式按 PyTorch 通常的方式逐个调度操作,方便打印中间结果和断点排错。PyTorch 官方解释,这条路径每个操作可能编译为各自的 Neuron Executable File Format 文件、启动并在高带宽内存中传递中间结果;实验性的 adaptive eager 尝试减少调度开销、融合操作。[2] 因此团队可以先用 eager 核对模型输出和反向传播,再看是否启用实验性优化。调试时看能否定位错误;生产时看吞吐和延迟。这两份测试报告分开写。
稳定负载可尝试 torch.compile(model, backend="neuron")。按官方技术说明,TorchDynamo 抓取计算图,AOTAutograd 处理反向图,后端经 Torch-MLIR、StableHLO 和 Neuron 编译器生成在硬件上运行的文件。[2] 图编译带来的优化空间与编译启动成本要一起记账。原始仓库的兼容说明提醒,首次调用包含编译时间、不同输入形状可能重新编译,当前所列后端仅支持 dynamic=False 且要求连续张量;这些细节会让“短任务测一次”和“固定形状持续推理一小时”呈现不同结论。[4] 上线前用实际长度分布做预热、分桶和缓存实验,比只测一条漂亮的吞吐曲线有用。
算子行为还有隐藏账。AWS Neuron 当前技术文档解释,在 eager 路径中,缺少 Neuron 实现的算子可回退 CPU 并给出警告;torch.compile 捕获的操作若后端无法降低,默认可能编译失败。[5] 前一种情况表面上“跑通”,却可能频繁跨设备传数据,拖慢整条链路;后一种情况直接挡住部署。团队应把 CPU 回退次数、graph break、重编译次数、设备间复制量列入测试报告,并逐一查兼容表,而不是以单元测试绿色作为性能完成的标志。
精度也要复核。官方文档提到 bfloat16、float16 和 float32 等数据类型;其当前页面另说明 float64 以 float32 运行。[2][5] 对大多数模型,容忍微小数值差异是常见工程实践,但医疗、金融或科学计算链路若依赖较高精度,就需要逐项设定误差范围并复核核心输出。训练收敛曲线、固定样本的推理结果和业务指标都应保留对照,不能只盯着一步的损失值。
开放的是框架入口,性能仍要自己做功课
TorchNeuron 支持 PyTorch 常见分布式 API,包括 DDP、FSDP2、DTensor、张量并行和流水并行;官方说明节点间通信使用 AWS Elastic Fabric Adapter,性能分析可借助 torch.profiler 和 Neuron Explorer 把框架事件关联到设备活动。[2] 这使熟悉 PyTorch 的团队可以沿用已有调试方法。但一套训练程序在新硬件上的通信拓扑、梯度累积、检查点写入和故障恢复,仍会决定每轮训练的真实耗时。
高性能热点可以进一步交给 Neuron Kernel Interface(NKI)编写自定义内核。PyTorch 文章还介绍公开的 NKI-lib,其中有注意力与 MoE 等优化算子;对于持续占用绝大多数计算时间的层,这种工作值得投入。[2] 选择也就变得清晰:先用标准 PyTorch 接口尽快跑通和定位,再对 profiler 指向的少数热点动手。全项目一开始就手写硬件内核,往往又把迁移成本带回来。
公开案例适合用来提出问题,不能替自己作决策。PyTorch 官网刊载的 Deepgram CTO 说法是:在双方评估的基准中,Trainium 每美元处理的输入音频秒数比其现有 GPU 基线约多60%。[2] 这个指标来自特定模型、软件版本和比较基线,采购方需要索要输入长度分布、批量大小、延迟约束和实例费用。对实时语音,单美元吞吐变好而尾部延迟超标,用户体验仍可能恶化。
为什么“能装上”仍旧很难变成“敢上线”
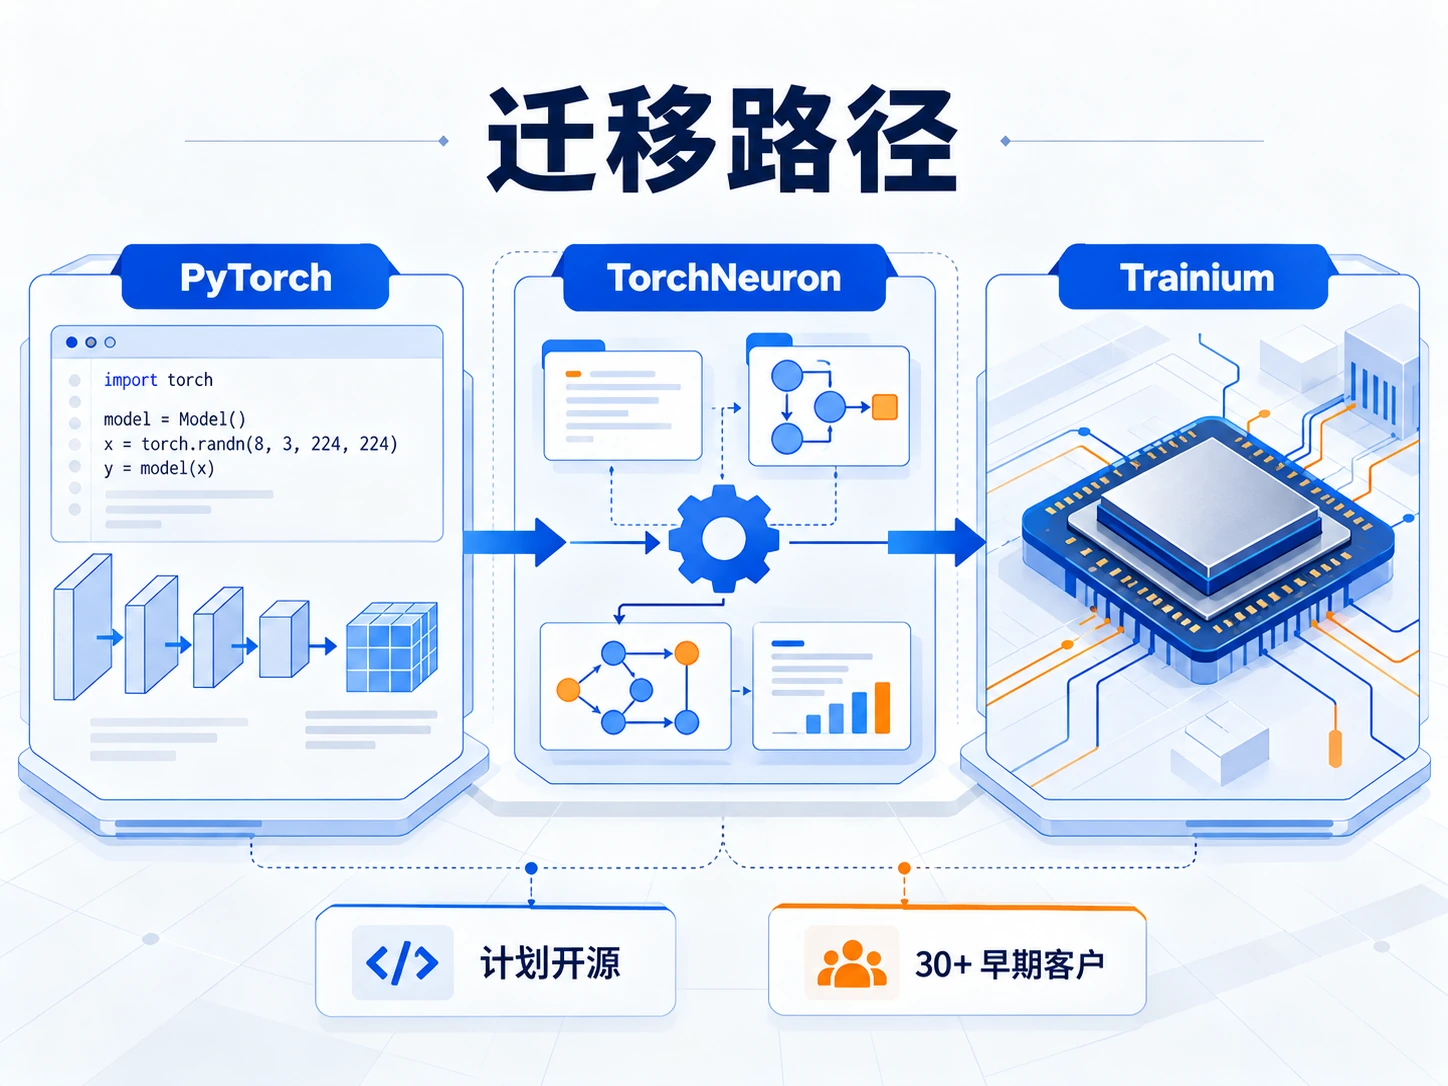
完整迁移要跨过开发、交付和运维三个现场。开发人员拿到 neuron 设备后,先处理 Python 环境与依赖锁定,核查模型里有没有特殊自定义算子;交付人员要确认容器镜像、实例配额、模型文件和编译缓存怎样进入部署流水线;运维人员则需要在资源紧张或实例故障时看得懂性能曲线,能够回滚。一项框架适配若只让第一组人轻松,后两组仍会在迁移期付账。
尤其应给已有 GPU 优化代码做清单。有些项目表面上使用 PyTorch,推理时却调用专门的 CUDA 内核、定制插件或与特定 GPU 内存布局绑定的库。此类代码的模型定义或许能切换设备,性能关键路径却没有自动转换。团队可先运行标准算子版本建立功能基线,再看是否可以用现有 NKI-lib 内核覆盖热点;若必须自己写 NKI,应把代码评审、编译维护与人员培训算入项目,而非写成零迁移成本。
版本管理也别留到最后。AWS Neuron 的旧文档将 XLA 方案和新原生后端分别列出,[3] 而新项目仓库提示早期版本 torch-neuronx 属于另一套实现。[4] 同一个依赖名称在不同 PyTorch 版本下的路径可能不同。测试记录须贴上镜像摘要、驱动、编译器和 PyTorch 的具体版本;升级一个组件便复测小样本正确性和性能。否则半年后问“为什么这次比上次慢”,没人能还原当时究竟用了哪个后端。
把等待编译的时间摊进真实流量尤其重要。一条常驻语音服务可能只需在发布时预热,一项处理不同尺寸视频的服务则容易碰到更多新形状。相同硬件报价下,热态大批量吞吐与冷态单请求延迟有可能得出相反的采购结论。拟迁移的业务若受峰值波动影响大,测试就要模拟重启与扩容,而不只让已经预热的实例跑完一次基准。
给企业的一张迁移验收表
第一阶段只取两类负载:一条稳定、算子成熟的训练或推理主链路,以及一条含自定义操作、动态形状或多卡通信的困难链路。前者用来测常见场景的迁移收益,后者尽早暴露工程上限。选用团队目前的 GPU 基线,固定模型权重、数据、服务质量门槛、预算和测量时间。记录工程师从环境搭建到首次正确输出用了多少小时,逐项说明代码修改、依赖调整与不支持算子的解决办法。
第二阶段把功能和性能分开:训练任务对比收敛、稳定性、每轮耗时、达到目标质量的总时长;推理任务对比正确率、吞吐、首包和 P95/P99 延迟。分别统计冷启动编译时间与热态运行结果,并记录容量利用率、CPU 回退、缓存命中、网络和存储开销。多节点任务再加入节点故障重启和断点续训。公司账单应包括实例、存储、跨区域或跨可用区流量、工程迁移与运维,而非只对比芯片标称性能。
第三阶段决定是否规模化。如果标准模型能以少量改动达到既定质量、延迟和综合成本目标,就保留一条 Trainium 路径,作为容量与价格谈判的真实选项;如果关键算子要大量重写,或者工作负载变化频繁导致持续重编译,应如实计算下一版本维护代价。也要写好回退条件:某次 Neuron 升级造成正确性差异、编译退化或服务尾延迟越线时,流量如何回到现有路径。拥有第二种硬件选择的价值,来自可以持续运行的备用方案,而不只是发布会上那行设备切换代码。
试点报告最好由使用团队自己写,而不是让供应商演示稿填空。把不能运行的算子、需要修改的代码行、首次部署耗时、连续运行一周的异常和人工介入次数一并公开给内部采购委员会。对于服务型业务,还要核算迁移期间双套环境并行的费用;对于训练型业务,则问清数据驻留地点和检查点迁移所占时间。若跨云迁移使数据出网、合规审批和灾备复杂化,较便宜的算力租金可能不足以补偿这些支出。
也可以先不做全量迁移。一个有现实意义的落点是把计算图相对稳定、能离线排队的任务放在 Trainium 上,把最依赖既有 CUDA 插件、延迟紧张的服务留在原平台。两条路径长期维护确实有成本;但只要版本、模型制品和验收规则一致,逐步搬迁比一次性大切换更容易发现哪里真正省钱。
最后一道检查是商业连续性。现在的公开测试版能证明社区愿意开放代码,也方便用户查看接口与提交问题;生产合同仍需确认具体版本的支持期限、修复响应和芯片实例在目标区域的供应情况。某个区域当月有空闲容量,并不意味着高峰时能临时开出同等规模的集群。项目组可安排一次完整的扩容与回退演练,让负责数据、模型和云平台的三组人同时在场,按秒记录环境创建、模型加载、首个合格结果和切回旧服务的时间。
真正有说服力的结果往往很朴素:某条业务线迁移用了十二个工作日,推理尾延迟守住约定值,一周内未出现未解释的数值漂移,每千次请求的综合成本比原方案低多少。这些数字要靠企业自己的账单和日志回答。TorchNeuron 提供了让试验更容易开始的入口,验收仍在业务现场完成。平台负责人还可把本次迁移留下的测试脚本沉淀为常规回归:以后升级 PyTorch、Neuron 或推理框架,都拿同一批生产形态的样本跑准确率与延迟。这样一来,新增算力平台不再依赖某位熟悉底层的工程师口头保证。谁能值班、谁能定位错误、谁有权回滚,都应该在扩容前写进交接单。否则,一条周五晚上突然变慢的推理服务,会把白天测出的算力优惠消耗在漫长的跨团队排障中。
TorchNeuron 改变了 Trainium 进入 PyTorch 项目的起点:团队可以从熟悉的模型定义和调试接口出发。[2] 接下来真正决定市场竞争的,是它能否在复杂负载、长期维护和可比的总成本里站住脚。企业先小范围迁移并公开内部测量口径,才知道这项兼容性为自己节省了多少时间。
参考资料
- Amazon News,《Amazon opens its AWS Trainium AI chips to every PyTorch developer, no rewrite needed》,2026-10-19 查阅(页面正文未标独立发布日期)。发布计划、授权、目标芯片和应用案例。原文
- PyTorch 官方博客,《Introducing TorchNeuron: Native PyTorch backend for AWS Trainium》,页面标记最后更新 2026-10-19。扩展接口、两种执行模式、编译链、分布式、内核与客户引述。原文
- AWS Neuron Documentation,《About PyTorch on AWS Neuron》,版本 v2.32.0,2026-10-19 查阅(页未标发布日期)。三代 PyTorch 集成的历史、旧后端与包名区分。原文
- AWS Neuron GitHub,《aws-neuron/torch-neuronx》,2026-10-19 查阅(仓库持续更新)。公开代码仓库与其 README 中的限制、首次编译、动态形状。原文
- AWS Neuron Documentation,《What is TorchNeuron?》,2026-10-19 查阅(持续更新页面,页内出现 Neuron 2.33.0;作为技术机制参考,不据此倒推19日软件发布状态)。算子 CPU 回退、编译路径、精度与 profiling。原文