在一块 65×65 的网格上求泊松方程,解不难算;难的是让神经算子只看方程、不看解,也学会稳定地算。Shizheng Wen、Siddhartha Mishra 与 Marius Zeinhofer 合著的 2026 年 9 月 28 日预印本《Preconditioned Physics-Informed Neural Operator Training》把病灶定位在训练损失的数值条件上:同一个有限元离散系统,监督误差能顺利下降,原始物理残差却可能在低频误差上磨很久。作者把多重网格放进损失函数,对泊松、Allen–Cahn 和定常 Stokes 做了实验。摘要称,相比此前物理约束算子学习方法,精度提高约 4—25 倍,无标签训练可与监督训练相当。这个说法要连同具体方程、指标和对照组一起读,不能理解为任意 CAE 模型都能免费获得同样倍数。

我认为这篇论文最值得带走的判断是:物理残差很小,与解的误差易于被优化器消掉,是两回事。给残差选一个合适的度量,可能比继续加深 FNO 更有效;但这个度量是否有效,取决于能不能为目标方程造出便宜、稳定的预条件器。
误差为什么会被残差「染色」
以零边界泊松方程 $-\Delta u=\rho$ 为例。离散成 $A\mathbf u=\mathbf f$ 后,网络输出 $\mathbf u_\theta$,真实离散解为 $\mathbf u^=A^{-1}\mathbf f$。监督训练最直观的损失是 $\frac12|\mathbf u_\theta-\mathbf u^|2^2$;不生成解标签时,可以直接最小化 $\frac12|A\mathbf u\theta-\mathbf f|2^2$。两者在理想情况下有相同的零点,但后者等于 $\frac12|A(\mathbf u\theta-\mathbf u^*)|_2^2$:误差先被微分算子放大,才交给优化器。
拉普拉斯算子对频率为 $\omega$ 的模态大致乘以 $\omega^2$。细网格纳入更多高频模态,原始最小二乘残差关于输出 $\mathbf u$ 的 Hessian 是 $A^\top A$。论文在相应的椭圆问题假设下给出条件数随网格宽度 $h$ 缩小约按 $h^{-4}$ 增长,而监督损失关于输出的 Hessian 是单位阵。优化器不得不兼顾梯度尺度差很多的方向:高频方向被放得很响,平滑的低频误差却可能长期留在解里。这是输出空间里的条件数分析,不是「神经网络参数 Hessian 已经被证明良态」;作者在泊松消融中也指出,预条件器改善到一定程度后,网络参数化自身的困难仍会限制收益。
于是改写损失:$L=\frac12\mathbb E_\rho|P(A\mathbf u_\theta-\mathbf f)|2^2$。如果 $P=A^{-1}$,它恰好退化成上述监督误差;实际不会为每次训练残差做一次昂贵的精确反解,而让 $P$ 近似 $A^{-1}$。更一般地,论文用 $\frac12\mathbb E\rho|P R_h(\mathbf u_\theta,\rho)|_B^2$,其中 $B$ 是正定权矩阵。若 $P$ 可逆、$B$ 正定,残差为零的位置不变,变的是不同误差方向的权重。注意这只是损失几何的说法:有限模型容量、有限训练步数下,两种损失得到的预测当然可能不同。
一次 V-cycle 在训练里干什么
多重网格把尺度分工做得很朴素:在细网格上平滑高频误差,把剩下的慢变误差限制到粗网格上求校正,再插值回细网格。本文泊松实验用规则网格的几何多重网格,一个 V-cycle 近似施加 $A^{-1}$;论文附录给出的实现是双线性延拓、加权 Jacobi 前后各两次平滑、最粗层直接求解。它不是先运行求解器生成一堆标签,然后偷偷做监督学习,而是在每次训练的前向残差与反向传播路径里改变误差的度量。作者称残差和预条件器在 GPU 上通过可微有限元栈组装和施加。推理时只运行神经算子,预条件器不进入模型前向,因此没有额外推理成本;训练端的组装、显存和 V-cycle 则不能被抹掉。
有一个容易漏看的细节:神经算子输出先插值到有限元空间,再计算离散残差。插值属于训练损失的接口,不必把网络架构永久锁在这张网格上;但测试时若换网格,插值误差、积分精度和边界节点映射都得重新核验。网络若输出了边界条件之外的自由度,只给 PDE 内部残差加权也救不了边界错误。论文的泊松对照直接把输出边界置零,PINO 基线同样如此;这比用柔性边界罚项更容易比较。物理约束在这里是明确的离散方程约束,不是一个自动识别单位、材料参数和工况语义的黑箱。
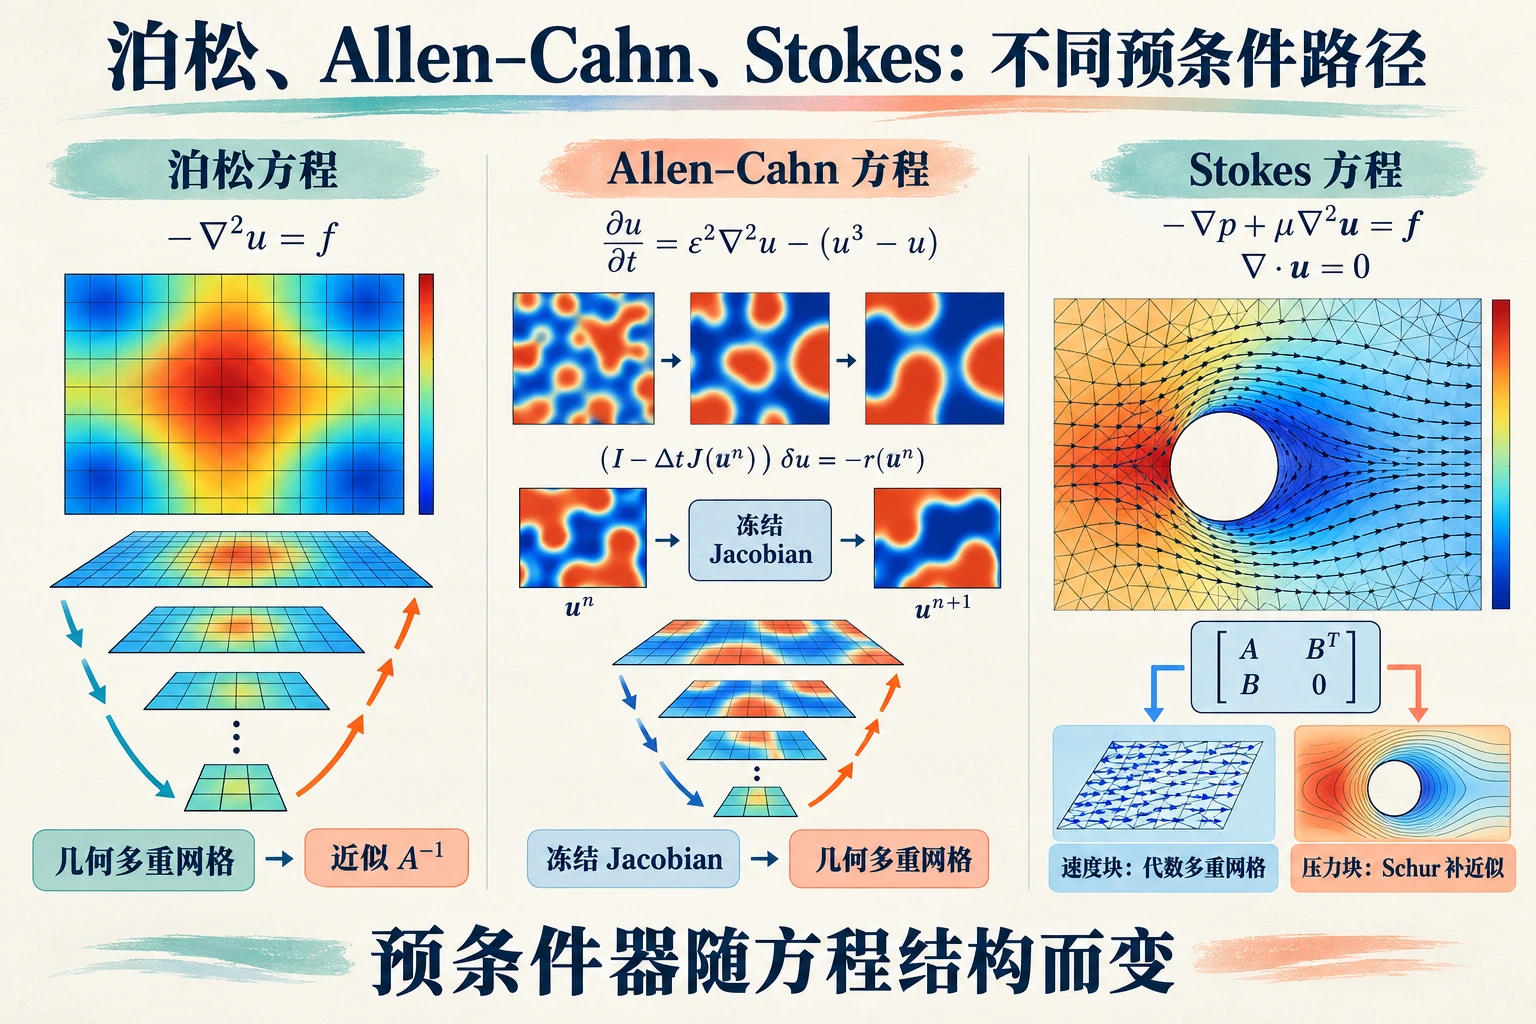
这套说法也不是「一个 $P$ 通吃所有 PDE」。Allen–Cahn 是非线性时间步进。论文对隐式残差的 Jacobian 做近似,以冻结在 $u^2=1$ 的矩阵 $((3\varepsilon^2+\tau^{-1})M+A)$ 构造几何多重网格预条件,而不是直接照搬泊松的 $A^{-1}$。Stokes 更不同:速度、压力构成不定的鞍点系统,作者在带圆孔的非结构三角网格上用 Taylor–Hood $P_2/P_1$ 元、GAOT 神经算子;速度块用代数多重网格,压力 Schur 补用集块压力质量矩阵的逆近似。其损失是按块预条件器给残差加权,并非宣称整个 Stokes 矩阵已被求逆。论文分析中,这里的条件数从未预处理时约 $h^{-4}$ 改善到约 $h^{-2}$,不像椭圆例子那样达到网格无关。
看表时,先问「跟谁比」
论文表 1 报告三个随机种子上的测试集平均相对 $L^2$ 误差(百分数,附半极差)。泊松的预条件物理损失为 5.1±0.8%,监督参考为 4.7±0.8%,PINO 为 33.1±1.1%,物理约束 DeepONet 为 21.4±4.7%。Allen–Cahn 在训练时域终点 $t=0.1$ 的结果分别是 3.2±0.3%、2.0±0.2%、5.3±1.6% 和 90.0±1.7%;时间步进本来比定常椭圆方程好训练,所以这里的 PINO 差距只有约 1.7 倍。Stokes 分开报速度与压力:预条件方法为 1.6±0.2% 与 0.85±0.04%,监督为 3.3±0.2% 与 1.79±0.16%,物理 DeepONet 为 39.7±2.1% 与 36.7±0.6%。作者自己说不清为何 Stokes 超过监督,读者不该把这个反超写成普遍规律。Allen–Cahn 还有另一层容易误读的时间尺度:网络学习的是一步映射,用预测的状态递推十步,表中数字是在 $t=0.1$;论文也画了延长到 $t=1$ 的自由滚动曲线。短时刻的单点误差与长时积分稳定性是两张成绩单。论文观察到物理损失的长时滚动较稳,并将原因暂时归于对前一步预测的自洽性;这仍是作者的解释性猜想,而非对所有反应扩散系统的稳定性证明。
「4—25 倍」来自作者对若干物理约束基线的总体概括,不能拿它覆盖 Allen–Cahn 的 PINO 对比;也不是相对误差普遍降低 4—25 个百分点。表中相同 PDE 的监督训练需要解标签,预条件训练不用;对照还涉及不同残差离散:本文有限元弱式残差、PINO 有限差分强式残差、DeepONet 对坐标自动微分。泊松对照共用 FNO 骨干并各自调学习率,但 DeepONet 架构不同。于是这些数值支持的是「论文所设协议和分布上的方法比较」,而不是单独剥离预条件器后的纯因果效应;后者应另看未预处理最小二乘和预条件强度消融。
如果只复制一行「无监督胜过有监督」,还会遗漏训练数据的特殊性。泊松实验中的输入不是任意厂房载荷图,而是低频截断正弦级数,附录给出系数独立均匀抽样的生成式;这种分布可以廉价地产生新样本,也能构造验证参考解。在同一分布测试是合规的基准,却没有检验传感器噪声、尖峰载荷、材料跃变或者几何外推。监督与无标签的差异主要是训练时是否拿到对应解,不是测试时放弃数值解作金标准。把「不需要标签」误读为「不需要可信求解器验收」,会在工程部署时付出代价。
成本也得对齐口径。表 1 单张 RTX 4090 的每轮耗时,泊松预条件为 1.2 秒、监督为 1.1 秒;Allen–Cahn 为 46 秒与 40 秒;Stokes 为 3.9 秒与 2.9 秒。每轮时间没有计入监督方案事先制作解标签的全部成本,也不等于达标总训练成本。论文另做了泊松固定 32,000 次更新、batch 32 的数据量实验:有限训练集增至 2,048 时,两种损失接近;每步抽新样本的无标签方式测试误差为 2.1%,最大有限集的监督方案为 2.8%。这是该输入分布下在线采样的优势,绝非证明任意参数分布都能无限生成有效工况。
CAE 工程师可怎样做一次小复现
先选一个可控的参数化泊松问题,而非上来就试三维流固耦合:单位正方形、零 Dirichlet 边界、规则 65×65 节点,载荷从截断正弦级数独立抽样。用同一 Q1 有限元离散组装刚度矩阵 $A$ 和载荷向量 $\mathbf f(\rho)$,令 FNO 输出在边界节点严格为零。为每个 batch 分别训练两版相同的 FNO:一版最小化 $|A\mathbf u_\theta-\mathbf f|^2$,另一版把同一残差先送入从零初值开始的一次几何多重网格 V-cycle。测试集的参考解要独立用可靠线性求解器生成,仅用于验证,不回流为无标签训练的目标。再增加一个用这些参考解训练的监督对照,才能回答「接近监督」而不只回答「比未经预处理好」。
记录每个方法三次种子的相对 $L^2$ 误差、最好验证检查点、每步耗时、峰值显存和达到同一误差阈值的总墙钟时间;再把网格细化至 129×129,检查收益是否随 $h$ 改变。画误差随更新步数下降的曲线时,最好同时画原始残差范数与预条件残差范数:两者尺度本来不同,不能拿最终损失值的绝对大小判胜负。用相同测试解计算标量解场误差,再把边界附近和区域内部的误差分别查看,能防止一个全局平均数遮住局部问题。还应报告训练载荷的随机种子与留出测试集的构造方法;若测试样本只是训练级数系数的重复,误差改善无法说明泛化。网格加密时既要维持物理载荷分布,又要按新网格重新组装矩阵及多重网格层级,不能直接拿旧网格上的损失值横向比较。学习率分别调优但公开搜索范围,固定载荷分布、边界处理和更新次数。额外做一次精确求解器校验:把 $P r$ 与 $A^{-1}r$ 的差、V-cycle 的收缩及反向梯度数值检查出来。如果需要辨别究竟是有限元弱式残差还是多重网格起作用,最好再加入同一有限元残差、仅去掉 $P$ 的消融;如果要比较强式 PINO,另列差分阶数和边界处理。不要把两种变化一次捆在一起,然后把差额全部记在预条件器账上。这里是我建议的复现实验设计,不是声称已经跑过这些实验,更不是论文中所有设置的逐行复制。
进入 CAE 流水线前,还要问具体工况能否按这种方式抽样。真实几何通常变化、网格质量不齐,边界条件未必能像示例那样硬编码;Stokes 的压力零均值约束、混合元稳定性也不能省。强对流、激波、高频波动或接触非线性未必有这样廉价而有效的预条件器,论文结论也明确把对流主导和高频波列为尚待解决的情况。预测的 $L^2$ 误差低,不自动保证局部峰值、守恒通量或设计安全裕度可靠。对于需要上生产线的代理模型,我会先用目标网格和目标载荷分布做上述对照,再单独验收工程关心的量;若预条件器本身难以构造,这篇工作的漂亮误差表不能替你省掉那部分数值分析。
原论文(2026-09-28 预印本):https://arxiv.org/abs/2609.36216 ;全文与实验附录:https://arxiv.org/html/2609.36216v1
配图为概念示意。