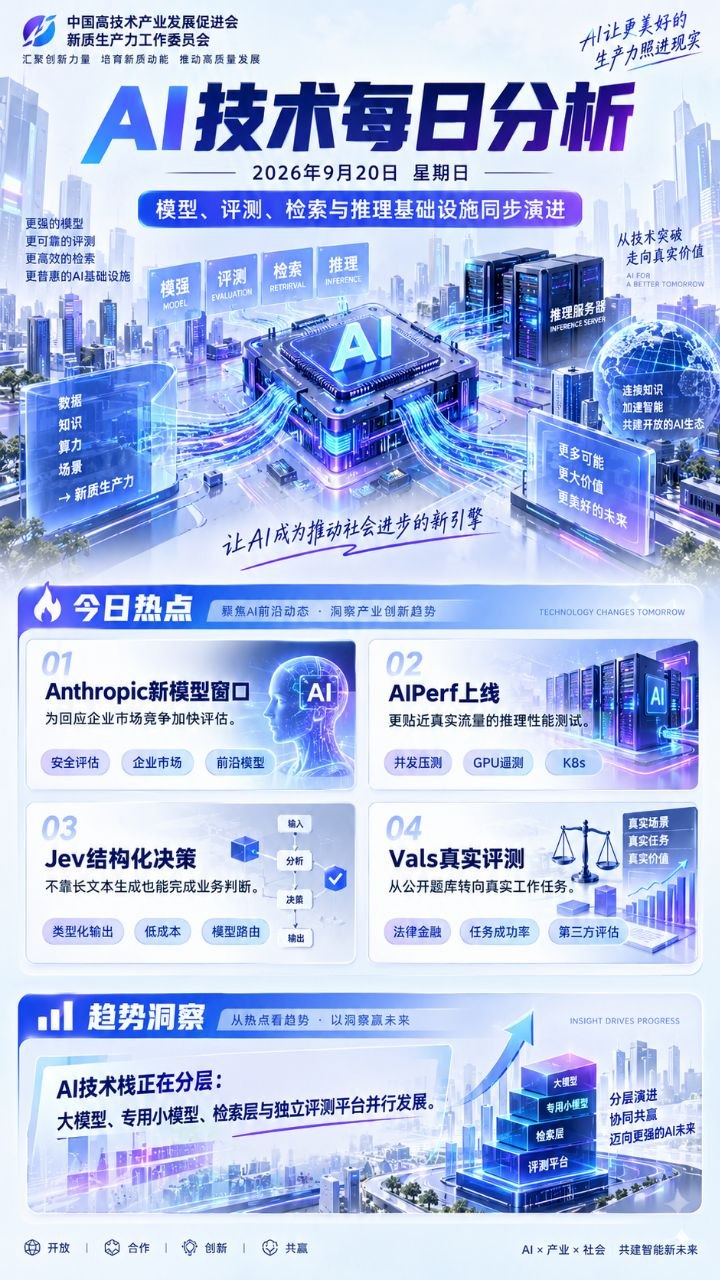
今天AI技术方向值得关注的不是单一模型榜单,而是模型、评测、推理基础设施和检索架构同时出现新的“分工化”趋势。Anthropic被曝正在评估提前发布新模型,以应对OpenAI GPT-6 Astra在企业市场快速取得份额,说明前沿模型竞争仍在高压推进;NVIDIA推出AIPerf,用更接近生产环境的流量模式、分布式压测和GPU遥测替代单机式推理Benchmark;TypeSafe AI发布Jev,尝试绕开自然语言生成,直接输出带校准概率的结构化决策,以更低成本嵌入软件自动化;Linkup Research开源149M参数的SPARSEUP,把“稀疏检索”重新带回Agent和RAG基础设施;Vals则把AI评测从公开题库转向法律、金融、编程等真实工作任务,并持续扩展到网络安全、生物安全等高风险领域。AI行业正在从“一个模型包打天下”转向更细分的技术栈:前沿模型负责复杂推理,小模型和专用模型负责路由与决策,检索模型负责上下文,独立评测平台负责验证真实能力。
日期:2026年9月20日 星期日
9月19日,Reuters援引三名知情人士报道,Anthropic正在考虑比原计划更早推出一款新模型,以回应OpenAI GPT-6 Astra近期在企业市场获得的快速采用。报道同时指出,新模型仍在进行安全评估,Anthropic尚未正式确认发布日期。
值得注意的是,这一动作发生在Anthropic CEO Dario Amodei公开呼吁行业放慢更强模型迭代速度之后,因此它折射出前沿实验室当前最真实的矛盾:安全治理要求降低发布速度,资本市场和企业客户竞争却要求持续提高模型能力。Reuters援引Ramp数据称,Astra上线后很快占到其追踪企业AI支出的约13%,Anthropic的Claude Fable系列约为8%;OpenRouter近期的消费数据也显示OpenAI重新取得领先。
这条新闻的重要性并不只在“又有一个新模型”。随着前沿模型能力差距缩小,企业采购正在越来越快地根据推理能力、工具调用、成本和稳定性切换供应商。模型厂商因此必须同时维持研发、基础设施、产品集成和安全评测四条高投入战线。
如果Anthropic最终提前发布新模型,2026年第四季度的竞争重点很可能不再是单纯参数规模,而是长任务完成率、Agent工具使用、企业数据边界以及单位任务成本。
NVIDIA最新发布AIPerf,用于大规模LLM和Agent推理性能测试,定位为GenAI-Perf的下一代工具。AIPerf不再把“单个请求最快完成”作为唯一目标,而是支持常量、Poisson、Gamma等不同请求到达模式,以及真实Trace Replay,以模拟生产系统中突发、高并发和长尾请求。
AIPerf能够统计TTFT(首Token时间)、ITL(Token间延迟)、请求总延迟、输出吞吐量及不同分位数,并通过DCGM和pynvml获取GPU利用率、显存、功耗等遥测信息;同时支持多节点和Kubernetes环境,适合测试大规模推理集群。
这一变化很重要,因为企业AI正在从“实验室Benchmark”进入容量规划阶段。真实Agent系统的压力往往不是平均延迟,而是P95/P99延迟、并发峰值、缓存命中率以及多轮任务持续运行后的吞吐稳定性。一个模型单请求跑得快,并不代表它在几千并发请求下仍然经济。
未来AI基础设施评测会越来越接近传统互联网SRE:不仅测模型精度,还要测队列、调度、KV Cache、GPU利用率、故障恢复和单位Token能耗。推理性能正在成为新的系统工程学。
TypeSafe AI近期发布Jev,一种基于Transformer但不以文本生成为目标的模型。Jev接收输入后输出预先定义的类型化结果和校准概率,而不是生成自然语言。创始人Diogo Almeida曾参与ChatGPT和RLHF早期研发,他认为很多软件自动化任务真正需要的不是一段自然语言,而是一个稳定、便宜、可量化置信度的判断。
例如,一个安全系统需要判断某条命令是否危险,一个邮件系统需要判断邮件属于哪一业务类别,一个模型路由器需要决定任务应该交给哪一种LLM。这些任务如果每次都调用大模型生成长文本,会造成延迟、成本和输出不确定性。
TechCrunch报道,多名开发者已开始测试Jev用于分类、安全检查和模型路由。有开发者称,在部分内部测试中Jev比通用LLM快数倍到十余倍、成本更低;这些结果仍属于开发者和厂商测试,尚不能等同于统一第三方Benchmark。
Jev代表一个值得关注的技术方向:AI系统未来可能像传统软件一样高度模块化。复杂推理由大模型承担,而分类、路由、置信度判断、风险检查交给专用小模型。这样既降低成本,也能让关键业务逻辑更可预测。
9月19日,Linkup Research发布SPARSEUP,一个149M参数、基于ModernBERT的开源稀疏Embedding模型,采用Apache 2.0许可证并公开模型权重。与普通Dense Embedding不同,SPARSEUP输出可以直接映射到词项维度的稀疏向量,能够使用传统倒排索引,同时保持一定语义检索能力。
Linkup公布的BEIR-13测试中,SPARSEUP取得56.4 nDCG@10。该成绩来自项目方评测,不能直接说明其全面优于Dense或Late Interaction方案,但它展示了另一个工程价值:稀疏检索更容易解释“为什么文档被召回”,索引结构也更适合已有搜索系统。
随着Agent需要调用越来越大的知识库,检索成本会逐渐成为主要基础设施支出。高质量Dense Embedding往往需要昂贵向量索引,而稀疏检索可以复用成熟搜索引擎生态,在企业已有Elasticsearch/OpenSearch体系里更容易落地。
未来RAG和Agent检索很可能不是“Dense取代关键词”,而是关键词、稀疏语义、Dense和重排序器组合使用,根据成本、可解释性和召回难度动态选择。
9月19日,TechCrunch报道AI评测创业公司Vals正在快速扩张。公司2024年成立,上月完成由Andreessen Horowitz领投的4000万美元A轮融资,目前员工从年初8人增长到约25人,收入同比增长约8倍。
Vals最重要的区别,是不公开具体测试材料,并且把法律、金融、编程等领域的真实复杂任务作为评估对象,而不是只测公开学术题库。公司还在扩展递归自我改进、心理健康、网络安全、生物安全以及武装冲突法等评测方向,并已启动面向美国联邦机构的模型评估项目。
这反映企业AI采购正在发生变化。公开Benchmark非常容易被训练数据污染,厂商也可以针对题库优化;真实业务则需要看模型能否完成多步骤任务、是否遵守领域规则,以及失败时会造成什么后果。
未来模型评测很可能类似云服务压测与安全认证:不同企业根据自身流程建立私有测试集,独立第三方负责执行评测,采购决策依据则从“排行榜第一”变成“我的业务成功率、错误成本和风险暴露”。
今天五条信息共同说明,AI技术栈正在快速分层:前沿模型继续争夺复杂推理能力;AIPerf把推理基础设施拉回真实流量;Jev探索低成本类型化决策;SPARSEUP重新强调可解释的检索层;Vals则负责验证这些系统在真实业务中的效果。下一阶段企业AI的核心问题将越来越具体:哪个任务需要大模型,哪个任务适合小模型,数据怎样被召回,系统在并发下是否稳定,以及最终结果能否被独立验证。
- Reuters|《Anthropic considers releasing new AI model ahead of IPO, sources say》|2026-09-19|核验Anthropic新模型评估、企业竞争与IPO背景。
https://www.reuters.com/business/anthropic-considers-releasing-new-ai-model-ahead-ipo-sources-say-2026-09-19/ - NVIDIA Technical Blog|《Benchmarking LLM Inference at Scale with AIPerf》|2026-09-18|核验AIPerf流量模式、分布式测试和GPU遥测能力。
https://developer.nvidia.com/blog/benchmarking-llm-inference-at-scale-with-aiperf/ - TechCrunch|《A new kind of AI model from a ChatGPT inventor is thrilling developers》|2026-09-18|核验TypeSafe AI、Jev定位和开发者测试。
https://techcrunch.com/2026/09/18/a-new-kind-of-ai-model-from-a-chatgpt-inventor-is-thrilling-developers/ - MarkTechPost / Linkup Research|《Linkup Research Releases SPARSEUP》|2026-09-19|核验149M参数、Apache 2.0与BEIR-13结果。
https://www.marktechpost.com/2026/09/19/linkup-research-releases-sparseup/ - TechCrunch|《Vals, backed by Andreessen Horowitz, is looking to become the gold standard for AI benchmarking》|2026-09-19|核验Vals业务、融资、员工及真实任务评测模式。
https://techcrunch.com/2026/09/19/vals-backed-by-andreessen-horowitz-is-looking-to-become-the-gold-standard-for-ai-benchmarking/ - Reuters|《Ten days that changed the course of AI》|2026-09-19|背景资料,观察前沿AI安全与能力竞争的最新张力。
https://www.reuters.com/business/media-telecom/ten-days-that-changed-course-ai-2026-09-19/ - Reuters|《Anthropic与Accenture投入至少20亿美元建设独立模型评估体系》|2026-09-18|背景资料,观察独立评测产业化。
https://www.reuters.com/business/anthropic-accenture-invest-2-billion-ai-model-evaluation-safety-concerns-rise-2026-09-18/ - Reuters|《OpenAI推出Astra for Law》|2026-09-17|背景资料,观察模型从通用能力向垂直行业产品延伸。
https://www.reuters.com/legal/litigation/openai-launches-legal-focused-ai-platform-escalating-race-law-firm-users-2026-09-17/ - TechCrunch|《PrismML小模型报道》|2026-09-17|背景资料,观察端侧、小模型和低成本智能趋势。
https://techcrunch.com/2026/09/17/prismml-hopes-its-tiny-llm-could-change-how-we-all-use-ai/ - Reuters|《OpenAI forecasts cash burn near $280 billion by 2030, FT reports》|2026-09-18|背景资料,观察前沿模型竞争的基础设施成本。
https://www.reuters.com/technology/openai-expects-burn-through-almost-280-billion-by-2030-ft-reports-2026-09-18/

关注高促会新质生产力工委会公众号

关注工业智能算网平台
发布日期:2026-09-20
发布机构:中国高技术产业发展促进会新质生产力工作委员会
本报告仅供行业研究参考,不构成投资建议