
本文选自 Horizon 2026年9月1日技术简报。
摘要
NVIDIA 展示了一条由 Claude Science 编排 BioNeMo NIM 微服务的蛋白质结构预测流程:智能体获取 UniProt 序列,调用 GPU 加速的 MSA Search,分别驱动 OpenFold3 和 Boltz-2,对单体及异源复合物进行预测,并保存输入、参数、结构和置信度。示例中,加入 MSA 后两个模型的界面置信度明显提高,去掉 MSA 后则大幅下降。这个案例的意义不只是“AI 调用另一个 AI”,而是展示科研智能体如何把异构模型、数据来源、计算环境和证据记录组织成可复查的实验流程。它也提醒人们:结构预测可以生成高价值假说,却不能代替生物实验。
科学计算的难点常在模型之外
科研人员使用蛋白质折叠、分子对接或组学分析工具时,通常要处理软件环境、数据库版本、输入格式、GPU 资源和参数设置。多个工具组合后,问题会迅速变成流程工程:上一步输出是否符合下一个模型的要求,失败后从哪里重试,数据来源和版本如何记录,两个模型的置信度能否直接比较。
通用语言模型可以理解研究目标,却未必了解每个专业软件的参数语义。仅给它一个命令行接口,容易产生“能调用但不会正确使用”的情况。BioNeMo Agent Toolkit 的做法,是把领域模型和流程封装成带说明、约束与操作范式的技能,由智能体发现并调用。NIM 微服务再把复杂运行环境封装为稳定端点,从而把“安装一个科研软件”转化为“调用一个有明确输入输出的服务”。
这种分层很适合工业智能体和科研智能体:语言模型负责理解目标、规划和解释,专业模型负责数值计算,运行时负责资源、安全与审计。三者职责分开后,系统更容易验证,也便于替换其中某个模型。
示例流程:从序列到两套独立结构预测
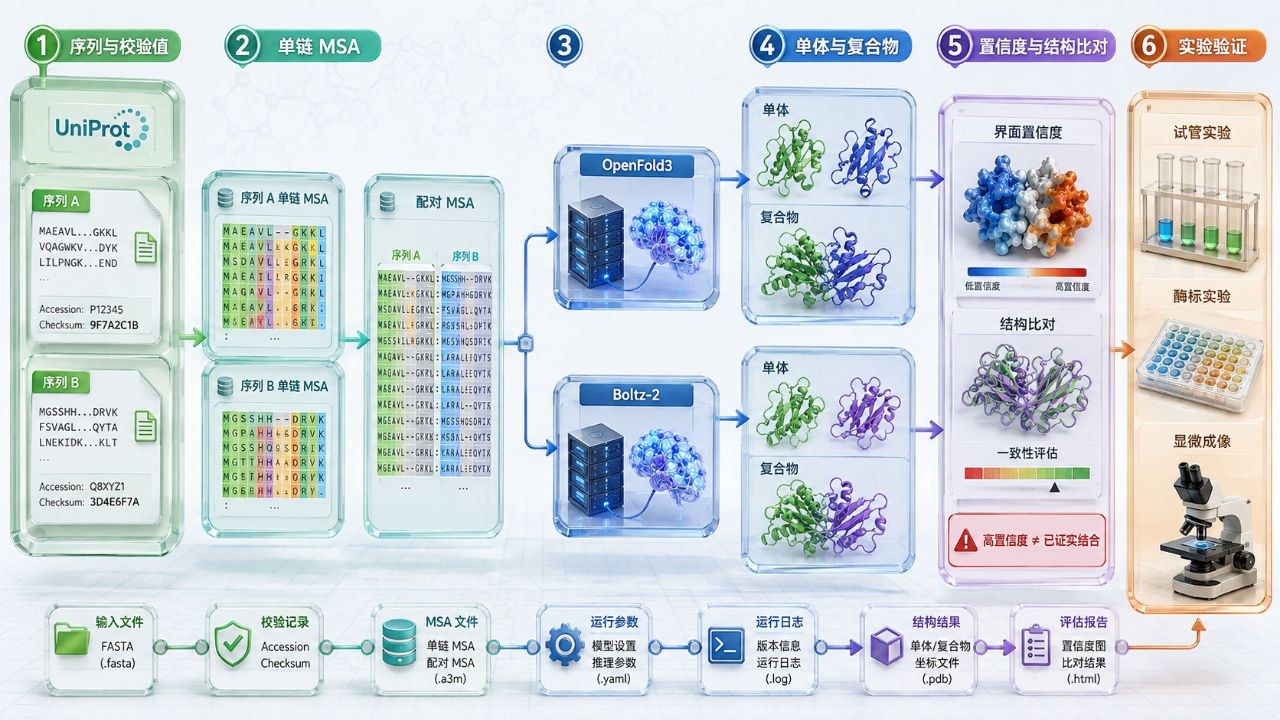
NVIDIA 示例研究真菌 Paracoccidioides lutzii 中的 Seh1 蛋白及候选 Mio 家族伙伴 C1HCX1。问题很具体:Seh1 单独建模时的结构,与它和候选伙伴共同建模时有何差异?智能体首先从 UniProt 获取两条 FASTA 序列,保存来源、访问号、长度、下载时间和校验值,随后用 MSA Search NIM 创建每条蛋白的非配对多序列比对,并构建物种配对的 MSA。
第二阶段把相同序列和 MSA 交给 OpenFold3,分别预测 Seh1 单体和双链复合物。第三阶段用 Boltz-2 重复实验。选择两个不同架构的模型,不是简单追求“多跑一次”,而是用独立模型检查结果是否具有一致性。所有结构以 mmCIF 等格式保存,同时记录实际返回的置信度字段和运行参数。
这套流程尤其强调失败边界:若配对 MSA 无法生成,应停止并报告,而不能悄悄改用另一种输入继续计算;模型的 confidence score 只能按该模型自身定义解释,不能随意跨模型比较;结构预测的高分不能表述为蛋白已经被证实结合。把这些限制写进技能和提示,比在结果生成后补一句免责声明更可靠。
MSA 为什么是“承重输入”
多序列比对通过同源蛋白序列展示进化约束。一个位置若长期保守,往往意味着它对结构或功能重要;两条相互作用蛋白中的位点若在不同物种中协同变化,可能透露界面关系。现代结构预测模型能够从这些统计模式中提取几何约束。
在示例中,有 MSA 输入时,OpenFold3 和 Boltz-2 对异源复合物给出的界面预测置信度较高;去掉 MSA 后,iPTM 分数从约 0.8 降至约 0.1—0.2。增加采样步数也没有弥补信息缺失。这表明计算预算不能替代关键证据:如果输入没有携带足够的进化关系,模型反复采样只是在信息不足的分布中搜索。
两个模型都将 C1HCX1 的部分 β 链置于 Seh1 的 WD40 开放边缘,并在核心区域得到较接近的结构。跨模型一致性提高了假说的可信度,但仍可能共享训练数据、MSA 偏差或相似归纳偏置。真正有说服力的证据仍需突变实验、共沉淀、冷冻电镜或其他生化方法补充。
智能体的价值在实验编排和证据保全
科研智能体最容易被夸大的能力是“自动发现”。短期内更现实的价值,是把研究人员已经会做、但步骤繁杂的流程可靠地执行一遍。它可以检查输入完整性,生成多个条件,调用不同模型,收集结构与日志,绘制对比结果,并把每个结论链接到原始文件。
如果只输出一段自然语言总结,这种系统的科研价值有限。可复现工作流至少应保存序列校验值、数据库版本、容器镜像、模型版本、参数、随机种子、硬件环境、原始响应、错误日志和结果文件。对每条解释性结论,还应标明来自模型分数、结构比对还是外部论文。
这与软件工程中的 CI 流水线相似:语言模型可以帮助组织任务,但可靠性来自明确接口、版本固定、自动检查和完整产物。科研智能体并不会消除科学方法,反而要求把隐含经验转化为机器可执行的步骤。
算力门槛与部署现实
教程要求 L40S 或 H100 等 GPU,MSA 数据库仅采用 UniRef30 配置也约 490 GB,完整数据集更大,加上模型容器和中间文件,单机需要约 700 GB 存储。这些数字说明,科研智能体的成本不只来自语言模型 token,还包括数据库、容器分发、GPU 占用和数据治理。
机构部署时可以把轻量交互界面放在研究人员终端,把结构预测端点放在 HPC 或私有云。智能体通过受控接口提交任务,调度系统负责排队和资源配额。涉及未发表序列、临床数据或药物研发数据时,还要限制外部服务访问,记录数据流向,并将密钥与运行环境隔离。
多个专业模型也会形成新的运维负担。端点升级可能改变输入格式或分数定义,数据库更新会影响结果,模型容器占用大量空间。平台需要模型注册表、兼容性测试和结果版本管理,不能把所有变化交给提示词吸收。
从蛋白质预测延伸到工业研发
这套模式也适用于 CAD、CAE 和工业软件。语言模型解析设计目标,专业求解器执行几何、网格和仿真,技能封装材料参数、边界条件和校核规则,智能体保存输入、求解日志、收敛曲线和报告。关键不是让语言模型替代求解器,而是让它理解何时调用哪一个工具,并把证据链组织好。
在工业领域,错误代价通常更高,因此应引入人工确认节点。模型可以提出边界条件,工程师确认后再启动昂贵计算;仿真完成后,规则引擎检查单位、网格质量和安全系数;只有通过验证的结果才能进入设计版本。科研智能体与工业智能体最终会在同一条工程原则上汇合:专业模型做专业计算,智能体做流程协调,人对关键判断负责。
结语
Claude Science 与 BioNeMo 的案例展示了科研智能体较成熟的一种形态。它没有宣称一次预测就完成科学发现,而是把数据获取、MSA、双模型预测、结果保存和谨慎解释串成一条可追踪链路。未来的竞争重点可能不在于谁能接入最多模型,而在于谁能把领域知识写成可靠技能,把计算过程沉淀为可复现实验,并明确区分“模型支持的假说”和“实验确认的事实”。
参考资料
- NVIDIA Technical Blog, Run NVIDIA BioNeMo NIM Microservices for Protein Structure Prediction in Claude Science
- NVIDIA, BioNeMo Agent Toolkit Repository
- Abramson et al., Accurate Structure Prediction of Biomolecular Interactions with AlphaFold 3
- Wohlwend et al., Boltz-1 Democratizing Biomolecular Interaction Modeling
- UniProt Consortium, UniProt: the Universal Protein Knowledgebase