OpenAI 的 FDE,全称 Forward Deployed Engineering,可译作“前线部署工程”。这支团队进入客户的业务现场,和芯片工程师一起判定测试是否有用,和客服团队一起找出语音模型在哪些对话里失效,再把方案推到生产环境。负责人 Colin Jarvis 在 2026 年 10 月 22 日发表的文章中说,他于 2025 年初组建团队,为的是缩短模型展示出的能力与企业稳定使用之间的距离。[1]
团队里曾有人问他:如果 Codex 一次就能完成我们忙了几个月的用例,FDE 还要做什么?半导体客户的项目给出了一个出乎意料的答案。工程师先花几个月搭建应用;Codex 变强后,又删掉每个项目约 90% 的定制代码。评测、行业判断和工作流却留了下来,下一次部署反而更快。
芯片验证:先知道“做对了”是什么意思
Jarvis 回忆,2025 年中,约 15 名 FDE 与一家大型半导体客户合作,覆盖十多个用例,目标是改造芯片验证流程。定向测试生成、故障根因分析、调试、架构问答,都在范围之内。文章称,验证在这个行业可占一个项目约 70% 的工作量;这是作者交代项目价值的背景数字,并非对所有芯片项目的统一测量。[1]
把聊天框嵌进工程系统很容易。难的是回答:AI 生成的定向测试,是否覆盖工程师关心的失效模式?面对一次芯片故障,模型给出的归因能否与实际日志和设计约束对上?OpenAI 的 FDE 进入客户验证团队,有人刚入职几天、此前也不熟悉半导体,就跟着工程师学习芯片设计,并共同设计 Eval(评测)来检验测试生成和故障诊断。他们同时为不同用例搭建定制 Harness:让模型接入工具、执行任务并接受检查的运行环境。[1]
最初三到六个月,这些用例先后进入生产,开始有早期用户。原文给出的项目结果包括:AI 定向测试生成节省约 48% 的时间,内核优化的中位性能提升 22%,原本需要数周的调试压缩到数小时。[1] 这些是 OpenAI 对该客户项目的披露;原文没有提供各指标的样本量、对照方法或适用范围,不宜拿来预测另一家公司的收益。
这一步建立了两个东西:哪些任务能交给模型,以及怎样验收模型做得对。没有真实工程任务,Eval 容易沦为模型自测;没有可重复的 Eval,生产上的一次成功也很难复制给下一个团队。
把“定向测试生成”拆成可执行的评测任务,大致要回答四个问题。第一,模型读到的是哪一版设计约束和已有测试?第二,生成的测试能否运行,是否触及指定状态或失效路径?第三,与人工编写或既有生成流程相比,节省的是工程师编写时间、仿真耗时,还是发现缺陷所需的总时间?第四,测试进入回归套件后,假阳性和维护成本由谁承担?这是从案例引出的工程评测设计建议,不是 OpenAI 公开披露的那家客户评测细则。原文只给出了 48% 等结果,没有公开完整实验设置。[1]
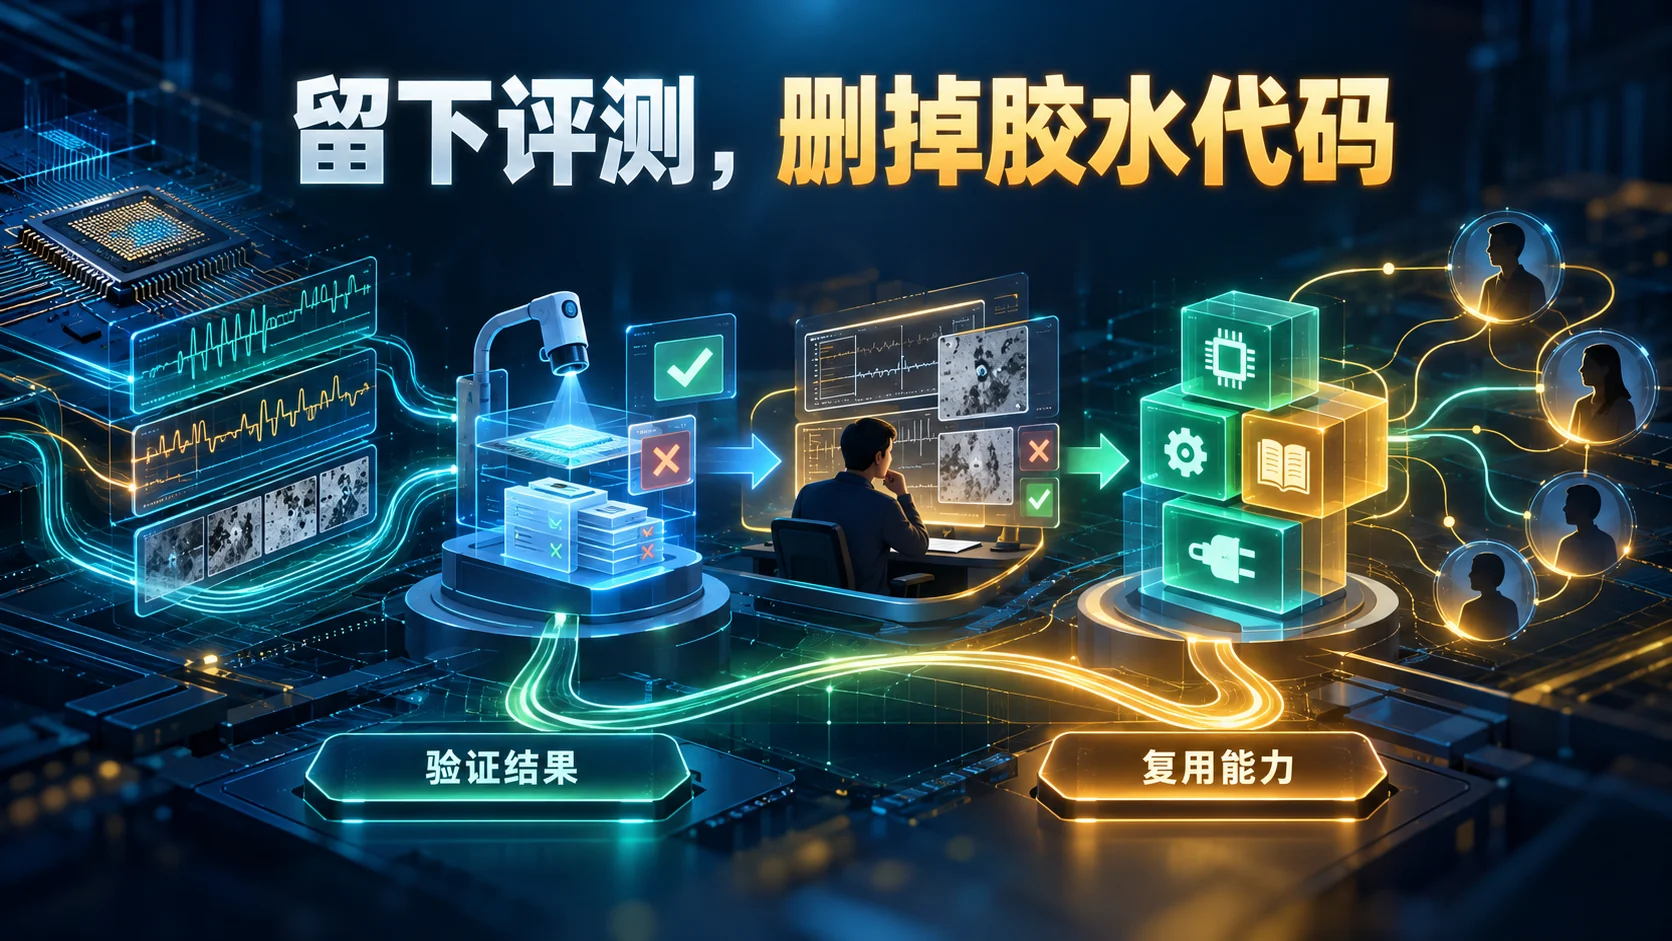
Harness 则把执行环节接起来:向模型提供授权范围内的工具和上下文,运行生成的任务,记录工具结果,让专家能够复核。评测决定“什么叫好”,Harness 决定“如何可靠地运行并留下证据”。企业换客户或换模型时,两者的职责都在,只是实现可以重用、替换或删减。
从十多个定制用例,收敛到一套共同底座
上线之后,新的问题出现了。每个用例都有自己的定制集成、终端界面和命令行工具;往客户另一个团队推广时,工程师仍得带着大量专用代码迁移。随着 Codex 的能力提升,一名 FDE 试着围绕 Codex 重建应用,再和团队把各用例迁到共同的 Harness 上。[1]
原先的定制应用被拆成在共同底座上运行的 Skill 与插件:Skill 固化具体任务的操作步骤和检查标准,插件及连接器承担外部系统接入。Codex 直接成为使用者的交互界面,早先给各场景单独写的终端界面和 CLI 逐步退役。OpenAI 称,每个项目约 90% 的定制代码因此被移除。[1] 这个比例描述的是原有定制代码的删减量,并非总项目成本下降 90%,更不意味着芯片行业知识可以省掉。
迁移后的复制速度更直观。Jarvis 给出的 2026 年 8 月一例中,首次部署用了两个月,拓展到第二个团队只用一天:换上新的连接器或 MCP server,重新建立该团队的 Eval,便能沿用共同底座;团队还有一个用来生成新 Eval 的 Skill。[1] 这个“一天”有前提:首个团队已经花了几个月澄清需求、完成集成与验收,并将重复的环节抽象出来。新的连接器仍要处理当地权限和数据,新的 Eval 仍要对应第二个团队的工作。
这里的 MCP 是让模型工具连接外部系统的一种协议。它解决了“怎样调用”的接口问题;某个故障诊断是否可信,仍需由芯片专家和评测样本来判定。[3] 同样,Skill 可以保存工作步骤,却必须跟随工具、组织权限和模型能力变化维护。[2]
当代码删不动,问题可能在模型本身
半导体案例展示了产品能力提高后如何缩减胶水代码。文章中的电信客户则碰到了另一种边界:原有客服平台准备扩到语音,而客户约 90% 的客服业务量来自语音。口音、语气、时延、函数调用和指令遵循,都可能让一个文字场景里表现尚可的模型在电话里失手。[1]
项目启动时,模型在客户关键 Eval 上得分约 60%。FDE 与客户一起定义上线要求并搭建平台,把具体失败案例带给 Research。随后六个月,随着模型版本迭代,同一类关键 Eval 的成绩先到约 80%,再超过 90%,达到这家客户的生产要求。[1] 原文未披露测试集构成;“90%+”是这家客户关键评测上的成绩,不能作为通用语音客服的上线门槛。
这个过程里,FDE 需要把业务里的模糊抱怨变成研究团队能复现的问题。模型升级之后,再用客户认可的关键任务和失败样本复测。文章说,改进后的语音模型既支撑了这位客户的部署,也进入其他客户项目与 OpenAI Presence 产品。[1] 一位客户遇到的能力边界,只有经过明确的评测和反复验证,才可能变成更多人能使用的模型能力。
企业 Agent 项目该留下什么
Jarvis 提出的 FDE 目标很反常:让客户和下一位 FDE 越来越少依赖当前这支团队。第一轮为具体客户写代码,目的是把问题送进真实使用;当 Codex 或模型本身跨过能力门槛,再删掉此前为补短板而写的实现,把可复用的东西抽出来。[1]
企业可以照这个次序盘点自己的 Agent 项目:
- 留住 Eval。 保存真实任务、成功标准、失败样本和回归记录。模型换版本时,用同一批关键场景复测;新增客户时,再把当地流程和数据补进来。
- 留住业务判断。 把高频且可标准化的操作写进 Skill,把审核、升级处理和异常回退规则写清楚。专家难以形式化的判断仍由专家负责,不硬塞进提示词。
- 把连接器做薄。 系统权限、数据边界和可审计的工具接口留在连接层;针对旧模型弱点反复堆叠的提示词路由、专用界面和脚本,按模型版本定期复查。
- 允许删除。 代码量减少只是信号。验收时要看关键 Eval 是否保持稳定、接入下一个团队需要多久、出了错能否定位并恢复。
半导体项目先用数月弄清什么叫合格的验证,再借 Codex 的进步减去九成定制代码。对企业团队,下一次模型升级时最值得问的问题也许是:哪段代码当初为了补模型短板而存在?把它删掉,关键 Eval 还能过吗?
参考资料
[1] Colin Jarvis, What FDE means at OpenAI, OpenAI, 2026-10-22。项目数字与时间均为作者在该文中的披露。
[2] OpenAI, Build skills,关于 Skill 的打包和复用方式。
[3] OpenAI, Model Context Protocol,关于 MCP 连接工具与外部信息的机制。